 老雷AI实验室
1000个文件的知识库,为什么我坚决不用RAG
先报一个可能颠覆你认知的数字。
我们的 Agent 知识库有一千多个文件,涵盖七个品牌的内容资产、六十多条工作流、八十多个命令行工具的配置。AI 在其中定位任何一个文件,耗时三秒以内,准确率百分之百。
实现方式里没有向量数据库,没有 RAG 管线,没有语义检索服务。靠的是纯文件系统,加一套 CLAUDE.md 多级路由。
都 2026 年了还不用 RAG?这篇就把这个决策的完整逻辑、六层路由的设计、以及规模化之后怎么治理,一次讲透。
什么情况下,RAG反而是错的
RAG 不是不好,是它的假设和 Agent 的场景不匹配。
RAG 的核心假设是,你有一大堆非结构化文本,需要用语义相似度从中捞出「可能相关」的片段喂给模型。这个假设在客服知识库、海量论文检索的场景下完全成立。
但 Agent 的知识库有四个完全不同的特征。结构化程度高,每个文件有明确职责,放哪、叫什么、管什么都是确定的。访问模式确定,Agent 要么按触发词路由到目标文件,要么按流程步骤顺序读取,不存在「帮我模糊搜一下」。精度要求极高,RAG 的召回率八成在聊天场景可以接受,在 Agent 工作流里取错文件就是执行灾难。迁移审计成本,文件就是正本,命令行能读能搜、版本管理能追踪;向量库的嵌入是个黑箱,换个模型全部重建。
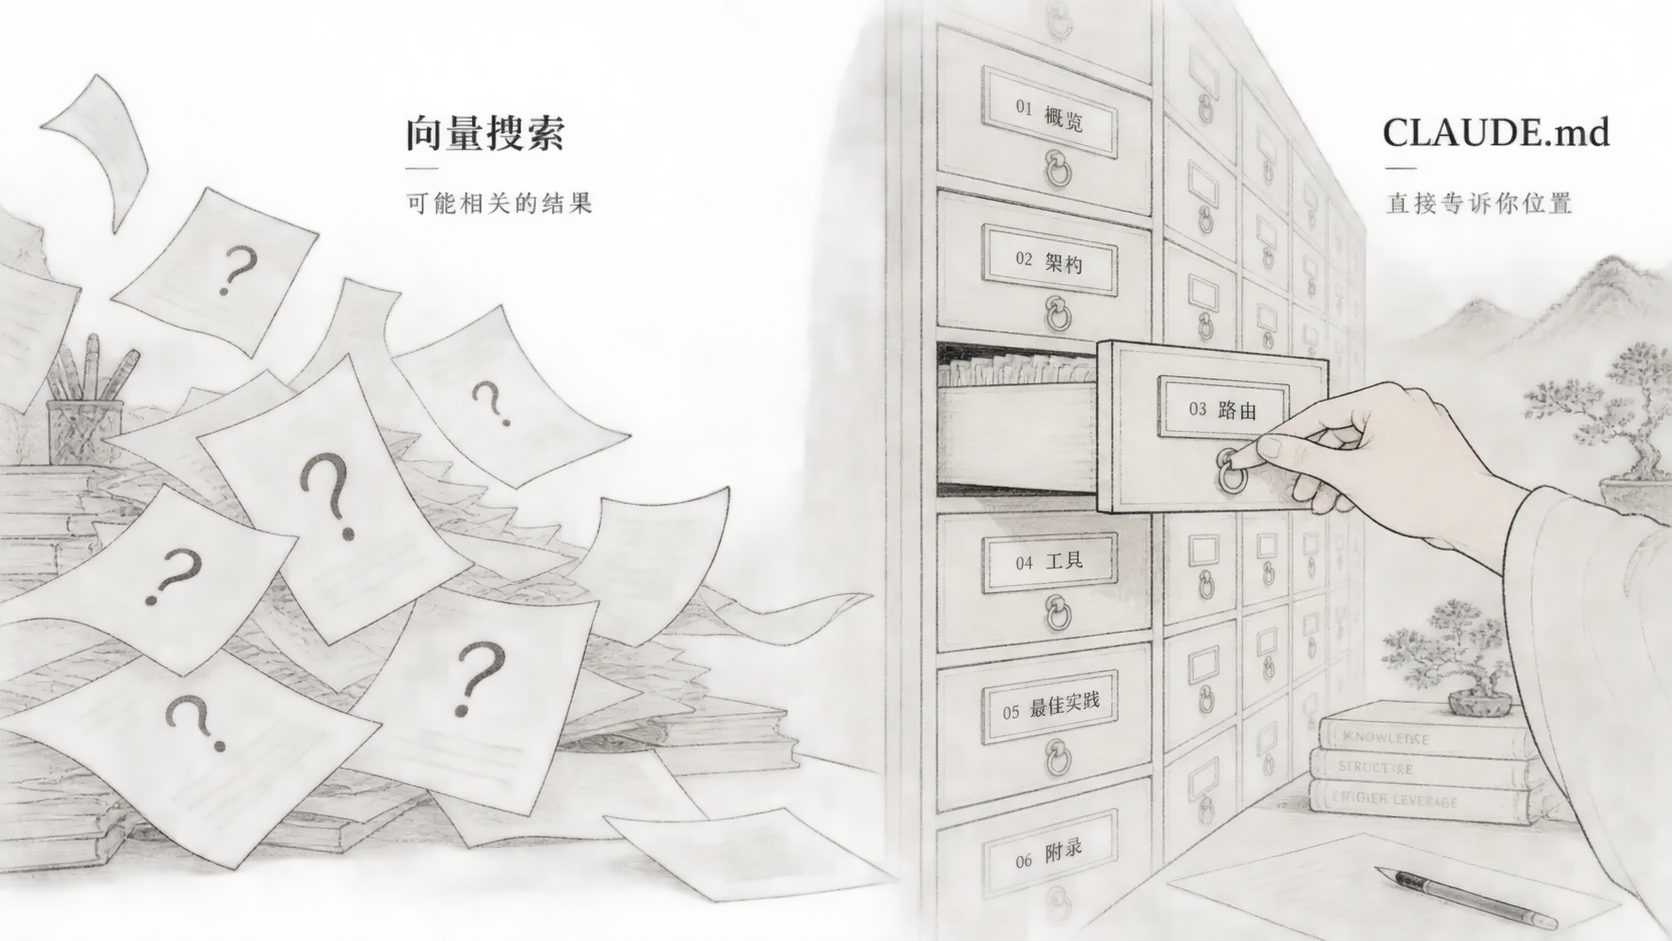
向量数据库像搜索引擎,给你「可能相关」的结果让你自己挑。CLAUDE.md 路由像图书馆目录,告诉你目标在第几层第几个抽屉,打开就是。
划清边界地说,当知识库超过一万文件、内容高度非结构化、查询意图模糊时,RAG 依然是正确选择。规模和结构决定方案,这句话反过来也成立。
六层路由,最多三跳到达目标
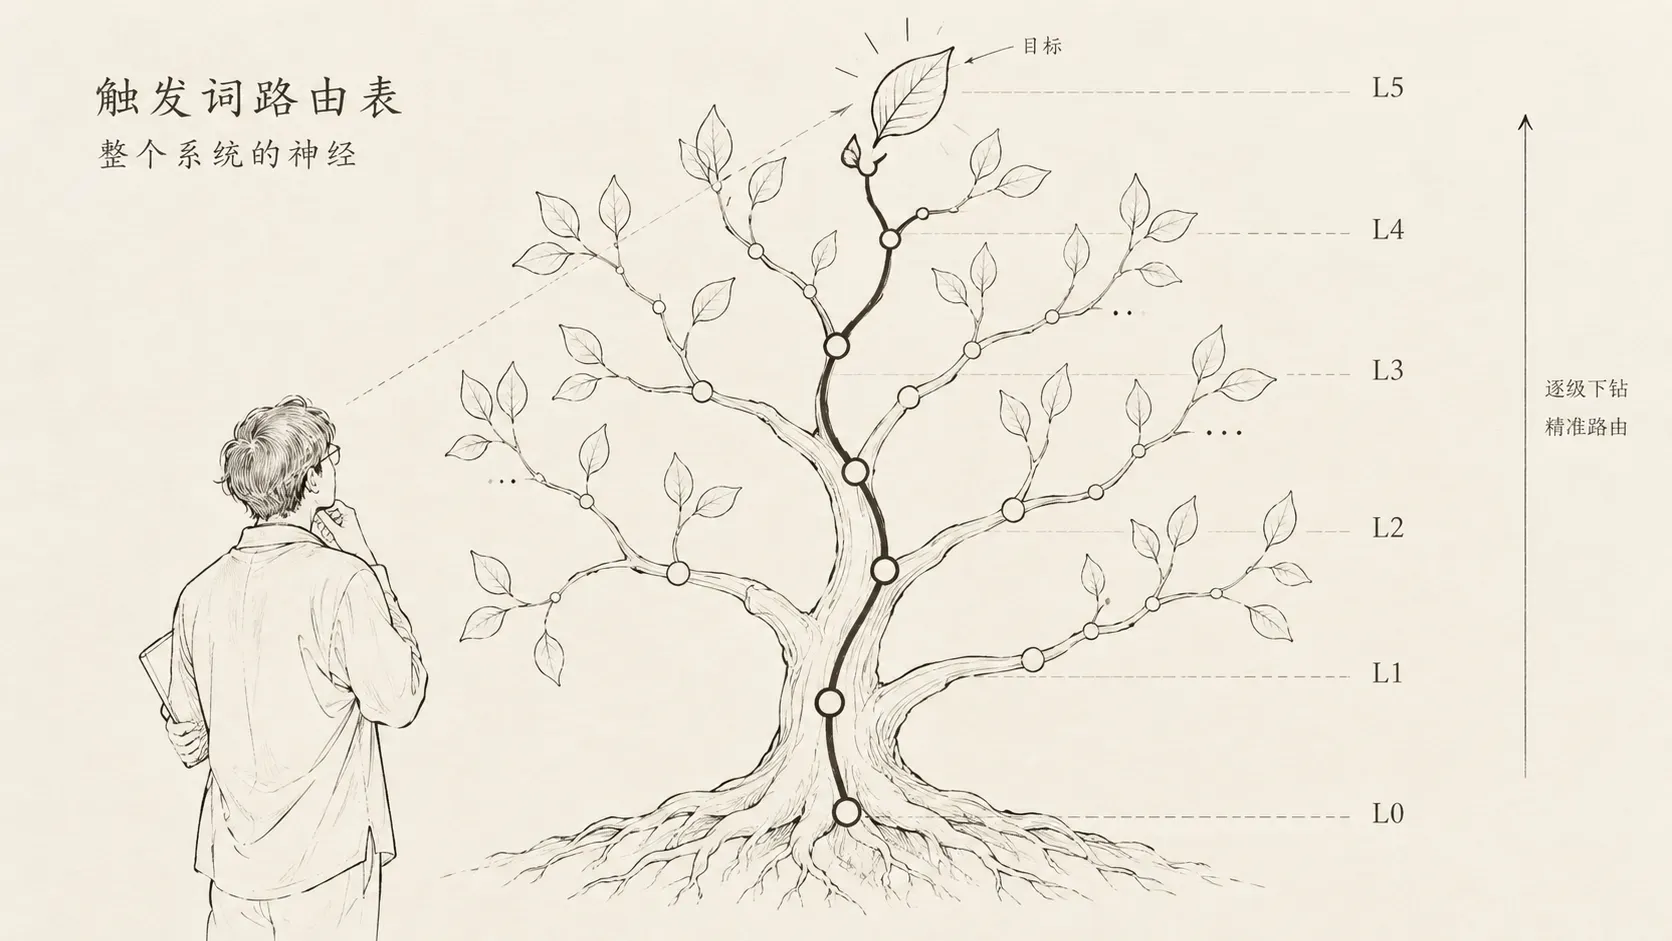
整个方案的核心架构一句话,用链式的 CLAUDE.md 文件构建一棵导航树,Agent 从根节点出发、按触发词逐级深入、最多三跳到达目标。
层级从 L0 到 L5。L0 在项目根,只写一句话身份定义加指向。L1 是知识库根的全局导航,包含行为准则、工具路由、目录触发词表和直读指引。L2 到 L3 是各级目录的域内索引和详细路由,逐层收窄范围。L4 是工具和工作流内部的操作指南。L5 是叶子文件,放具体规范和数据。
为什么限定三跳?经验值来自实测,一跳信息不够,四跳以上 AI 容易在导航里迷路。三跳意味着最多读三个导航文件加一个目标文件,上下文开销稳定在可控范围。这个数字不是拍脑袋,是拿几百次真实寻路任务喂出来的。
Agent 的寻路过程是这样的。用户说「写一篇官网文章」,Agent 读根导航,命中触发词「官网文章发布」,指向对应工作流目录;读该目录的导航文件,获得完整执行路径和子流程列表,开始执行。全程确定性百分之百,不存在「召回了错误文档」的可能性。
根导航文件是整个知识库的灵魂,生产级的结构包含五块,行为准则、工具体系、知识库导航(触发词路由表)、命令速查、直读指引。
其中直读指引是个容易被忽略的设计。高频访问的内容走逐级路由反而慢,所以在根导航里直接给出绝对路径,让 AI 一步到位。高频走快车道,低频走目录树,两层都要有。
展开说生产级根导航的五个板块。行为准则,写 Agent 的操作规则,比如工具优先、改前先读规范、规则只增不改。工具体系,列出可用的 MCP 和本地工具的路由表。知识库导航,就是那张触发词路由表。命令速查,放最常用的几条命令。直读指引,给高频内容的绝对路径。
这五块不用一次写完。老雷的经验是先从最高频的三个知识领域起步,边用边长,三个月后自然成形。
触发词路由表,整个系统的神经
路由表的格式很简单,目录、职责、触发词,三列。
品牌目录对应人设、表达风格、画像这些触发词。工作流目录对应出课、引流、建站。工具目录对应工具、脚本、凭据。Agent 读到用户请求后,在这张表里做关键词匹配,命中就跳进对应目录继续深入。
写好触发词有两个硬条件。唯一性,不和其他目录的触发词冲突。覆盖性,用户可能的所有自然表达都要覆盖到。老雷的实际操作是,每次 Agent 走错了路由,就回来补一个触发词。跑了半年,这张表从最初的二十个长到了两百多个,它现在是我们团队最有价值的一份数据资产。
触发词表是活的。它是系统和真实用法之间的碰撞记录,每次碰撞都该让表变厚一点。
规模化治理,靠归档和审计
文件涨到一千个之后,新的问题变成了治理。
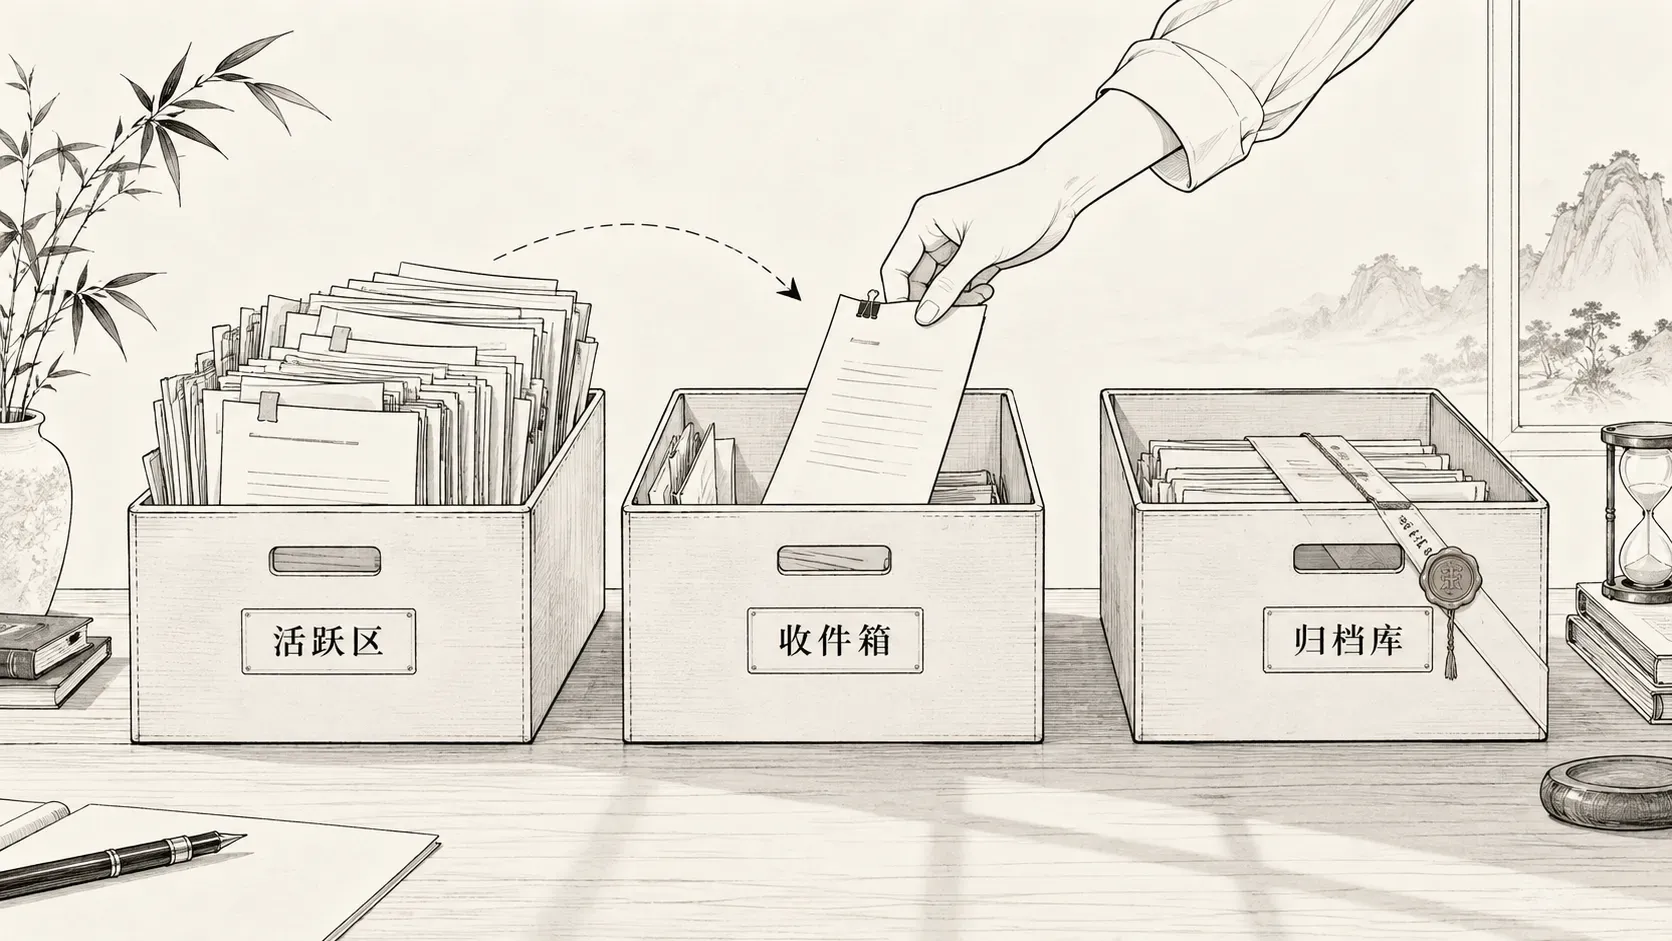
一是归档分层。活跃文件、收件箱、归档存储三层分开,控制活跃区规模,AI 的导航效率取决于活跃文件数量,不常用的老文件沉到归档层,需要时再捞。二是本地命令行工具做确定性审计和归档,重复检测、失效链接、结构校验全部脚本化,判断逻辑不藏进黑箱。
归档的分层规则也值得抄。活跃区的文件数量是效率的生命线,我们的阈值是超过八百个就强制整理一次。三个月没有被任何流程引用的文件自动降级进收件箱,收件箱里再躺半年没人认领,就整体搬去归档存储。每一层的文件数和最后访问时间,用脚本每周出一张健康报表。知识库和人一样,需要定期体检。三是和 卡帕西 提出的 LLM Wiki 模式的关系,同宗但走得更远,那个方案适合个人笔记整理,当知识库要承载多品牌运营、多工作流编排、多 Agent 协同时,单层导航撑不住,你需要多级路由和治理机制。
从零搭一套,四步走完
第一步,建目录分区。按职责划分顶层目录,一个目录一个职责,宁多勿混。
第二步,写根导航。把行为准则、触发词路由表、直读指引三块配齐,触发词从最高频的二十个起步。
第三步,给每个目录配域内导航。写清子目录结构、域内路由和边界声明,让逐级下钻每一层都有据可依。
第四步,跑起来,让路由表长大。Agent 每次走错路由都是一次宝贵的反馈,把纠错动作变成补触发词的例行操作。三个月后,这套系统的命中率会逼近百分之百。
从零搭的时间投入也交个底。我们完整搭到一千文件的规模,累计花在知识整理上的时间大约三周,摊到每天不到半小时。而这三周换来的,是此后每一次 AI 调用的确定性。这笔账,值得每个准备上 Agent 项目的团队重算一遍。
RAG 是搜索问题的答案,路由是导航问题的答案。先分清你手里的是哪个问题,再动手选方案。
最后给一个诚实的边界声明。这套方案在一千文件的规模上精度碾压 RAG,不代表它万能。三类场景老雷会毫不犹豫地建议上 RAG,文件上万且持续爆炸增长、内容以扫描件和对话记录这类非结构化数据为主、查询意图天生模糊无法穷举触发词。工程决策从来不是站队,是量体裁衣。
写给 FDE 同行收个尾。客户问你「要不要上向量数据库」的时候,先问回去三个数字,文件多少个、结构化程度多高、查询模式是精确还是模糊。三个数字一报,方案自然浮出来。我们的经验是,企业内部知识库的规模和结构化程度,大多数落在纯文件系统方案的甜蜜区里,省下的那套 RAG 管线的钱和运维,够你把知识库内容整理得漂亮一倍。