老雷AI实验室
14 个场景跑下来,把 n8n 的自建账和选型对照算清楚
上一篇拆 Make,后台有读者留言问了一个躲不开的问题,客户说数据一步都不能出内网,那 Make 的方案是不是直接就死了。
问得很准。全托管平台的代价就是把数据交出去,这一条在企业场景里经常是过不了合规那一关的。所以这篇把 n8n 摊开讲,老雷把过去一年用它跑的 14 个实战场景掰开了算账,从视频批量生产到 AI 集成再到副业变现,这篇算的是自建的账,结尾给一张 Make 和 n8n 的选型对照,两篇凑成一对。
如果说 Make 是租来的自动化,n8n 就是自己拥有的自动化。
n8n 是什么,跟 Make 差在哪
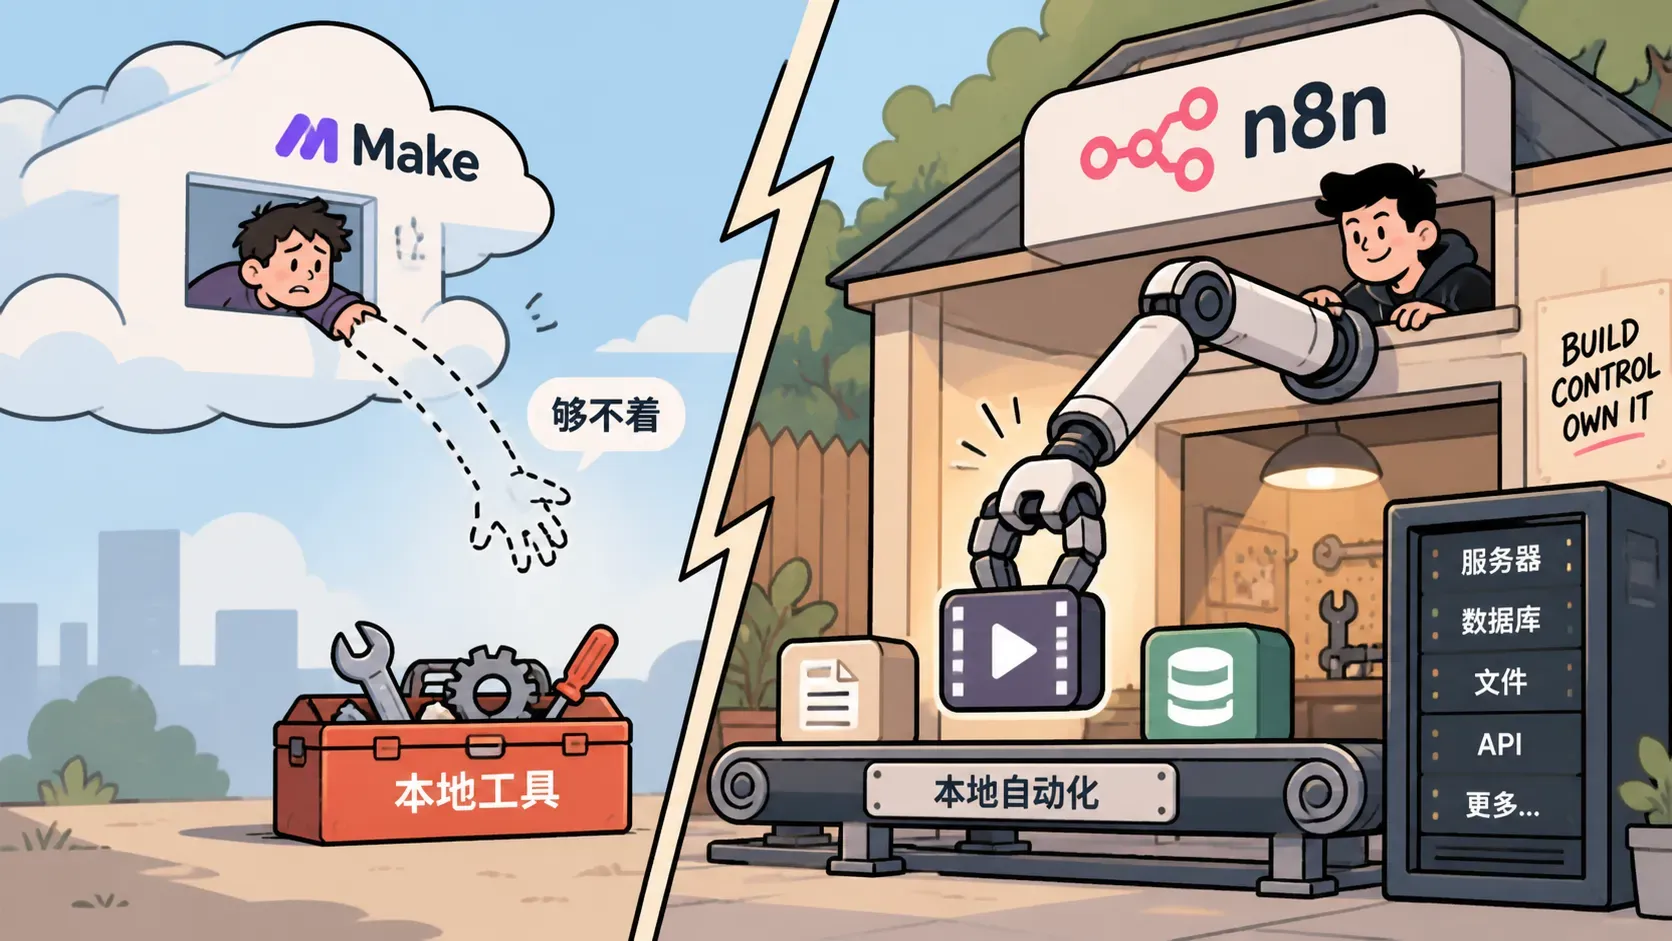
n8n 是一个开源的自动化平台,名字读作 n-eight-n,取自 nodemation。它跟 Make 最深的差异不在功能清单,在所有权。数据存在你自己的服务器上,工作流是 JSON 文件可以进 Git 管版本,节点不够用可以用 TypeScript 自己写,自建部署后没有执行次数限制,还支持离线跑。打个比方,Make 像租一间精装公寓,拎包入住但不能砸墙,房东随时可能涨租,n8n 像自己买地盖房,前期费劲,但房子是你的,想怎么改就怎么改。
法律边界也得讲清楚。n8n 用的不是 MIT 那类完全开放协议,是公平代码模式,源码开放,你可以免费使用、修改、自建,但不能拿它的代码包一层去做竞品 SaaS 卖给别人。对正常使用来说,做内部自动化、卖工作流模板、做代运营,都不受影响。
它特别适合三类人,数据敏感的企业、要深度定制的技术团队、想用 AI 做复杂自动化的创作者。如果你 Make 用着觉得够用,没必要折腾,别为了开源而开源。
它擅长什么,Make 够不着的地方
第一件是本地执行。Make 的模块跑在云端,碰不到你服务器的文件系统。n8n 自建后可以直接调命令行工具,视频场景里最典型,定时触发拉选题,大模型写脚本,语音合成节点配音,FFmpeg 节点拼画面加字幕,一条 TikTok 流水线就成型了。人的精力集中放在选题和审核两端,机器包掉所有标准化组装。批量生产时用分批节点把任务清单拆成队列控制并发,避免十条视频同时渲染把服务器 CPU 打满,再配 Code 节点做动态参数,不同视频不同配乐不同封面,批量但不千篇一律。这种细粒度控制全托管平台给不了。
写作链路也能整套搬进 n8n,RSS 节点定时拉行业资讯,大模型生成结构化大纲,每个段落独立调用避免上下文过长质量下滑,再用条件节点自动检查字数和关键词密度,最后一稿多渠道适配分发。SEO 场景的账更好算,关键词挖掘管线定时调关键词 API,清洗筛选后写入关键词库,发现高价值低竞争的蓝海词自动预警,跑一次两三分钟,同样的事手工做至少半天。拿它的结果配合搜索后台的排名数据做匹配分析,哪些词已有内容覆盖、哪些还是空白、哪些文章排名在下滑,一个完整的 SEO 监控台就出来了。进阶玩法还有把大模型微调整条管线编排起来,训练数据采集、格式化、提交、评估、上线切换自动流转,不过微调不是万能的,能靠提示词和 RAG 解决的就别急着微调。
还有一个 Make 用户经常撞上的坑顺带提醒,YouTube 官方 API 配额很紧,每天默认一万单位,一次搜索就烧掉一百,工作流一天跑几次就把配额烧光了。用 RSS 源替代 API 追频道更新是更省的办法,RSS 没有调用限制。
第二件是工程化。工作流是 JSON 文件,进 Git 分支管理,测试流跑在 staging 环境,改动后自动触发回归测试,这套 CI/CD 的质量保障打法在 Make 上根本无从谈起,它的场景锁在 SaaS 后台里。
第三件是 AI 集成的深度。n8n 内置 AI Agent 节点和 MCP 客户端节点,大模型在工作流里不只是生成文本,还能调用工具执行操作。这里有个架构心得,确定性的部分,取数、格式转换、条件分支,交给普通节点,只在真正需要理解和判断的环节调用大模型。这种混合架构比纯 Agent 稳,比纯规则活。举个具体场景,GitHub 仓库来了新 issue,n8n 用 Webhook 接住事件,先用 Code 节点做预处理,只提取和这个 issue 相关的文件与函数,再交给 Claude Code 的 Skill 做定点分析,自动给出修复建议甚至直接提 PR。直接把整仓代码塞给大模型是行不通的,上下文一溢出推理质量就垮,先预处理再定点修,效果完全两样。我之前写过给 Skill 建质检闭环那篇,n8n 在这套体系里就是天生的调度层,Webhook 收事件,Skill 做智能处理,各干各的擅长。
第四件是副业上的零边际成本。服务器成本固定,每多服务一个客户不加平台费,一台小 VPS 每月不到五十块就能跑一个客户的完整实例,数据还完全隔离。对在意数据安全的企业客户,这本身就是一个能收溢价的卖点。路子有三条,卖工作流模板、做自动化代运营、用管线批量生产内容,互不排斥可以叠加,核心是扎进一个你熟悉的垂直行业,把那个行业最痛的手工环节自动化。RAG 知识库问答这类产品,向量库节点加 AI Agent 节点,搭起来很快,收费按搭建费加月度维护费的模式走,比一次性买卖健康得多。
n8n 的价值不在于它可以做什么,在于它让你拥有什么。
运维是真成本,先把冷水泼了
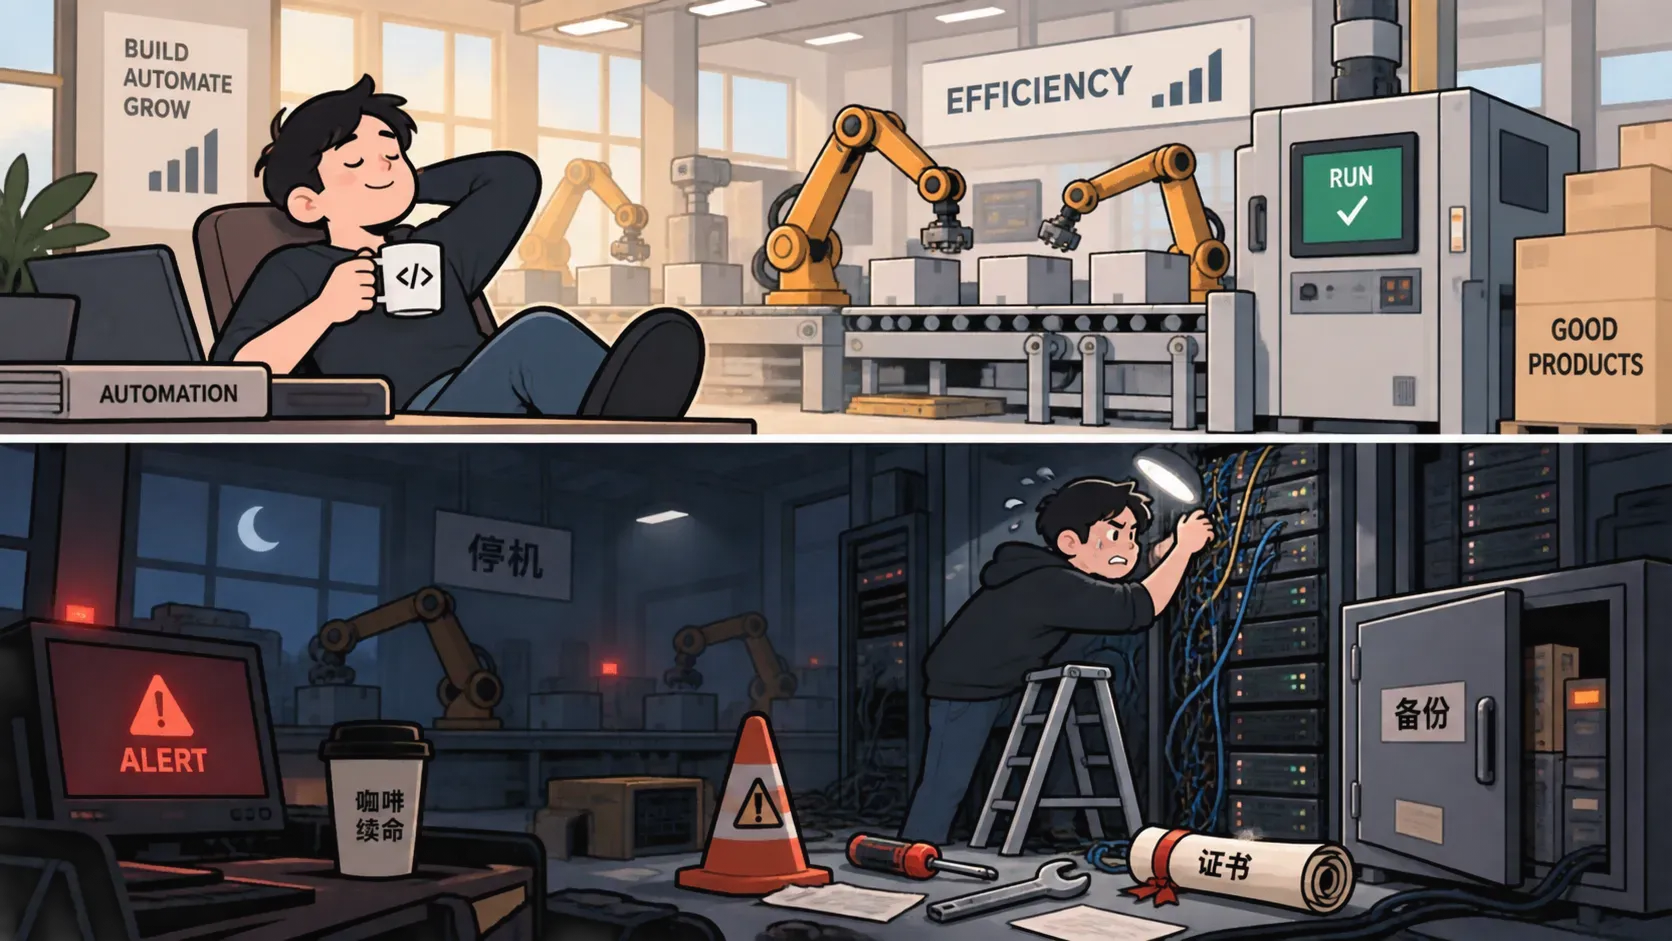
第一盆冷水,n8n 不是 Make 的免费替代品。它的核心价值是所有权和可控性,你要是只冲着免费去,大概率会在运维上把省的钱加倍赔回去。服务器要维护,n8n 要升级,证书要续期,数据库要备份,这些都是持续的工时。
第二盆冷水,自建不等于安全。部署在自己服务器上只是安全的前提,HTTPS 配置、端口隔离、凭据加密、定期打补丁,一样不能少。一台裸奔在公网上没更新的 n8n,比 Make 的托管服务危险得多。
第三盆冷水,别把复杂度当本事。单个工作流超过五十个节点基本就不可维护了,用子工作流把大流程拆开,每个只做一件事,跟 Make 那边的拆分原则一模一样。另外 AI 节点别干精度活,让它判断邮件要不要回复很靠谱,让它精确计算订单金额很危险,AI 和确定性逻辑要分开。
还有一个隐蔽的坑,工作流导出 JSON 不等于备份。JSON 里只有流程定义,凭据、环境变量、运行历史都不在里面,丢了加密密钥,数据库恢复了你所有凭据也得逐个重配。完整备份要连数据库转储和密钥一起管。老雷见过最冤的一次翻车就是一个团队只导了 JSON 当备份,服务器磁盘挂掉之后,几十条工作流的 API 凭据全部重配了一遍,整整耗掉两天。
从 Make 搬家,怎么搬不翻车
已经有一批 Make 管线在跑的团队,迁移别搞一刀切。先把最痛的那条搬,通常是执行次数最多、月账单占比最大的那条,在 n8n 上重建后两边并行跑一周,确认稳定再下线旧管线。
凭据要逐个重配,Make 的凭据导不到 n8n,动手前先列一份清单。遇到 n8n 没有现成节点的服务,用 HTTP 请求节点直接调 API 是最快的过渡方案,不必等官方节点。搬完的每条工作流导出进 Git,把版本管理这个 Make 给不了的能力立刻用起来。
选型对照,放在最后
给 FDE 同行做方案时的判断依据,压缩成两段话。选 Make,当你不想碰服务器、只想拖拽搭建,工作流逻辑简单几个节点就够,团队里没有技术人做运维,且预算扛得住按次计费。选 n8n,当数据涉及隐私和商业机密不能落第三方服务器,当你要 Git 管版本、分环境部署,当你要写自定义节点对接内部系统,当工作流跑得频繁到按次计费肉疼,当你要在工作流里调本地命令或者让大模型做多步推理和工具调用,且团队有 Docker 和数据库的维护能力。
老雷的经验是,判断不了就从小切入,先用 Docker 把 n8n 部署起来,搭一条每天拉 RSS 发摘要的定时管线练手,一周内你就能摸清自己团队适不适合这条路。
写到这儿想起买房和租房的争论。租房的人说灵活自由,想搬就搬,买房的人说月供再重,房产证上写的是我的名字。自动化平台也一样,租来的省心,买下的踏实,没有标准答案,只有跟你处境匹配的答案。唯一确定的是,你得先想清楚自己要什么,再去挑钥匙。
采集、加工、分发的管线思维不变,变的只是管线架在你家房顶还是别人家房顶。选好了就动手,两条路都能跑起来。