 老雷AI实验室
Agent跑一周烧了137美元,后来我把月账单压到了5美元
先说个数字。
137美元。
有团队装了开源的Agent框架Hermes,接上API欢欢喜喜跑自动化,七天后一查账单,就这个数。
你可能觉得是他们用量太大,还真不是。Hermes本身开源免费,MIT协议,贵的是背后没人管的模型调用。
钱漏在哪儿了
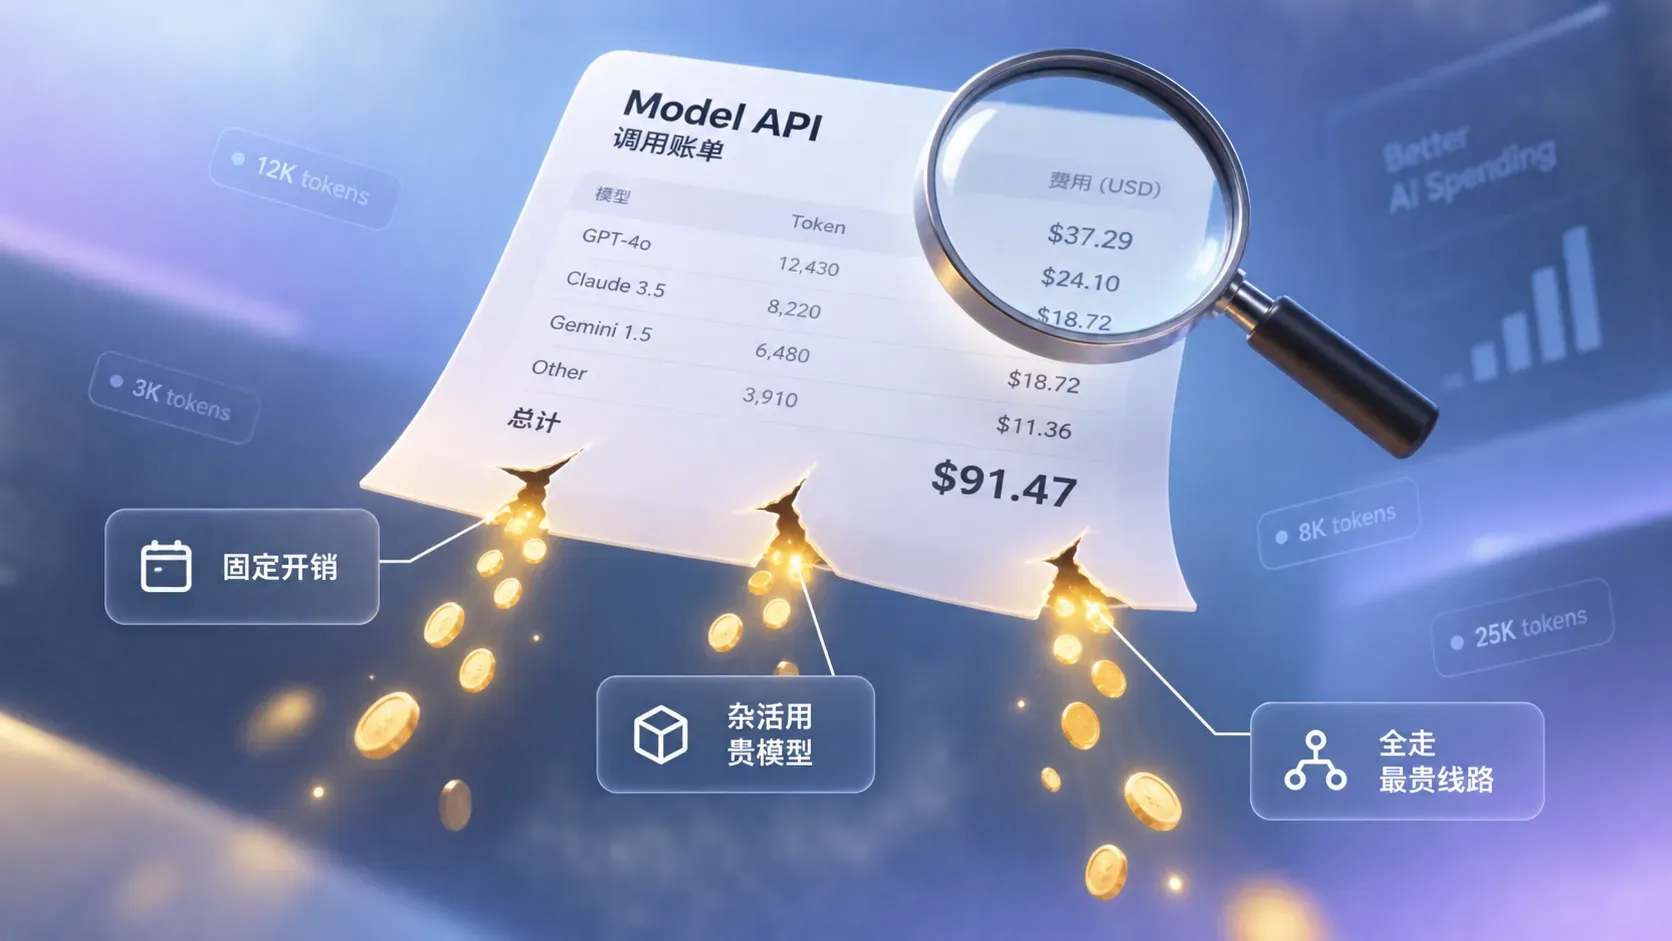
把这笔账拆开看,钱都漏在三个特别隐蔽的地方。
第一处,固定开销。一个没优化过的Hermes实例,带着72个工具,每个工具的说明书,也就是Schema,每一轮对话都要完整塞给模型过一遍。一上来就吃掉19210个token,活儿还没干,钱先花了。
第二处,杂活用了贵人工。压缩对话历史这种辅助任务,默认跟着主模型走同一条通道,相当于让主刀医生去干护士的活,还按主刀的价格付钱。
第三处,路全走最贵的。没配任何路由,所有请求默认线路,一分便宜没占到。
POC阶段量小,看不出疼。业务一上来,账单按倍数放大,老板问ROI的时候你就尴尬了。
后来我们把成本这块从头到尾治理了一遍。同样的活儿,月账单从200美元压到5美元以内,任务质量没打折。
说实话,这里面有几招老雷也是被账单教育了之后才学会的。六件事,按花钱的口子一个一个说。
六个口子,一个个堵
先说第一件,让请求挑便宜的路走。
这个点很多做交付的人不知道,同一个模型,走聚合网关比如OpenRouter,能路由到好几个子提供商,官方API、AWS Bedrock、Together AI这些,价格和吞吐量各不相同,有时差得还不少。
Hermes里对应的是provider_routing配置。核心一个sort字段,批处理、跑后台任务这种不赶时间的,填price,让它自动挑当下最便宜的。终端里交互式对话,填latency,优先响应快的。再配上白名单only、黑名单ignore、优先级order三个过滤器,基本够用。
两个提醒。路由只在走网关时生效,直连官方API不存在路由这回事。然后data_collection设成deny,这条我希望你写进所有企业交付的默认配置里,数据流向哪些提供商,是合规问题,不是可选项,别等客户法务来问。
顺带说一句,路由不只省钱。把批处理和交互任务分开走不同档位之后,高峰期互相抢通道的情况也少了,算是意外收获。
接着说第二件,主路堵了得有备路。
可靠性设计其实也是成本设计。主通道半夜挂了,没有降级方案,要么业务停摆,要么人工切到更贵的应急通道,两头都是亏。
Hermes的韧性体系是三层。第一层凭据池,同一个提供商多配几把Key,一把限流换下一把,下面单说。第二层主模型降级,主模型失败了自动切到别的提供商或模型。第三层常被忽略,视觉、网页提取、上下文压缩这些辅助任务,各自有独立的降级链,跟主模型互不拖累。
有个设计细节值得抄,它的降级是按轮次算的,不是按会话。这一轮主模型挂了切备用,下一轮还是先试主模型。这样既不会一路降到底回不来,也给了主模型每轮恢复的机会。
还有个省钱的角落大多数人漏掉,子代理不用配那么贵的模型。委派出去的子任务一般比主任务简单,一行配置让它用便宜模型,子任务成本直接打到零头。
再给数据敏感行业补个选项,降级链的末端可以挂本地模型。Hermes支持LM Studio这类本地方案,云上通道全线异常的时候,本地模型顶不住全部活,应急兜底够用了,而且数据不出门。
第三件,同一家多配几把钥匙。
凭据池的逻辑很朴素,同一提供商注册多个API Key,这把触发了限流,毫秒级换下一把,会话不断。
轮换策略四种,轮询、挑用得最少的、先用完一把再说、随机。按业务挑就行,不用纠结。
真正值得细看的是它的错误分级处理。碰到429限流,先在当前Key上重试一次,它会尊重对方返回的Retry-After,不瞎打,还429才换Key。碰到402欠费或配额耗尽,立即换,出问题的Key扔进24小时冷却。碰到401认证过期,先试刷新Token,刷新不动才换。全池子都趴下了,才走跨提供商的fallback。
给不是做技术的读者翻译一下这层的价值。没有它,客服Agent半夜限流,等于客服线半夜停摆,外加一个被电话叫起来救火的人。有它,这事在用户感知发生之前就结束了。
第四件,让每一分钱都能对上账。
管不住成本的项目,十有八九是账记不明白。要三层都看得见,每次调用花了多少,抓单点异常。每次会话累计多少,算单个任务成本。每个业务环节占多少,回答老板那句钱花哪儿了。
这里有个高频翻车点,我建议直接写进验收标准。不同模型的tokenizer不一样,同一段中文在不同模型那儿的token数能差出一两成。你拿着A渠道的token数去推算B渠道的成本,对不上是必然的。
别问老雷是怎么知道的。
举个对账的例子。同一段两千字的中文,走A渠道算出来可能是三千token出头,换B渠道也许只要两千六。直接拿A的用量乘B的单价,两边永远对不齐。所以报表上只留一个口径,要么全站按金额计量,要么网关层归一化之后再入库,吵架自然就少了。
第五件,别让上下文悄悄吃钱。
长跑的Agent会话,真正的大头是每轮重复携带的上下文,不是那次回答本身。三个办法,按收益排。
收益最猛的是工具按需加载。默认配置下,几十个工具的说明书全量塞进每一轮,就是开头那个19210 token。改成Tool Search按需检索,工具说明只在真用到时才进上下文。代价是检索多一次延迟,后台批处理完全无感。这一项砍掉了大约89%的固定开销。
不过别一刀切,高频使用的核心工具留在明面上,藏起来反而多绕一步。真正该藏的是一个月用不上两回的长尾工具。
其次是上下文压缩,长对话历史分段压缩,每轮省75%左右。但这里有个我亲自踩过的坑,值得单独讲讲。
有次长会话跑着跑着,主模型触发限流,压缩任务当时默认跟着主模型走。主模型一限流,压缩跟着失败,整个会话上下文丢了,任务从头再来。
一次限流,收了我两遍钱。。。
要是发生在夜里批处理,它能重试到天亮,账单和业务双输。修法就两行配置,压缩任务绑定一个独立的便宜模型,再加防抖保护,短时间反复触发压缩时合并处理。改完之后,成本曲线平了。
最后一个,能用代码解决的别劳烦模型。批量读文件、清洗数据这种活,让Agent在沙盒里跑代码本地处理,只把结论带回来,别让50个文件的内容从模型上下文里流一遍。这个比委派子任务还省,代码执行本身几乎不花token。
第六件,排班本身也能省钱。
预算敏感的项目,我们的配置思路是免费额度优先、按量兜底。主力模型吃包月额度比如GLM,额度见底自动切到DeepSeek这类便宜按量的,配置改两行的事,额度恢复再切回来。建议把这个检查写成固定动作,每月一号看一次额度水位,别等批处理跑到一半才手忙脚乱地切。
成本警报一定要配,用量到日预算八成就告警。看板不用华丽,一张按天聚合的用量表加一条预算线就够用,关键是指定一个人每天早上瞄一眼,失控基本都能在24小时内按住。
上线前,拿这张单子过一遍
最后,老雷给FDE兄弟们一张上线前的单子,拿去直接用。
路由分档配了吗,批处理走价格优先,交互走延迟优先。data_collection deny写进默认配置了吗,合规项别留成可选项。三层降级齐了吗,子代理用便宜模型了吗。凭据池每个提供商至少两把Key,402冷却开了吗。三层用量可见了吗,对账口径统一成金额了吗。压缩任务绑定独立模型了吗,工具Schema改按需加载了吗,批量数据处理走沙盒了吗。成本警报设了吗。
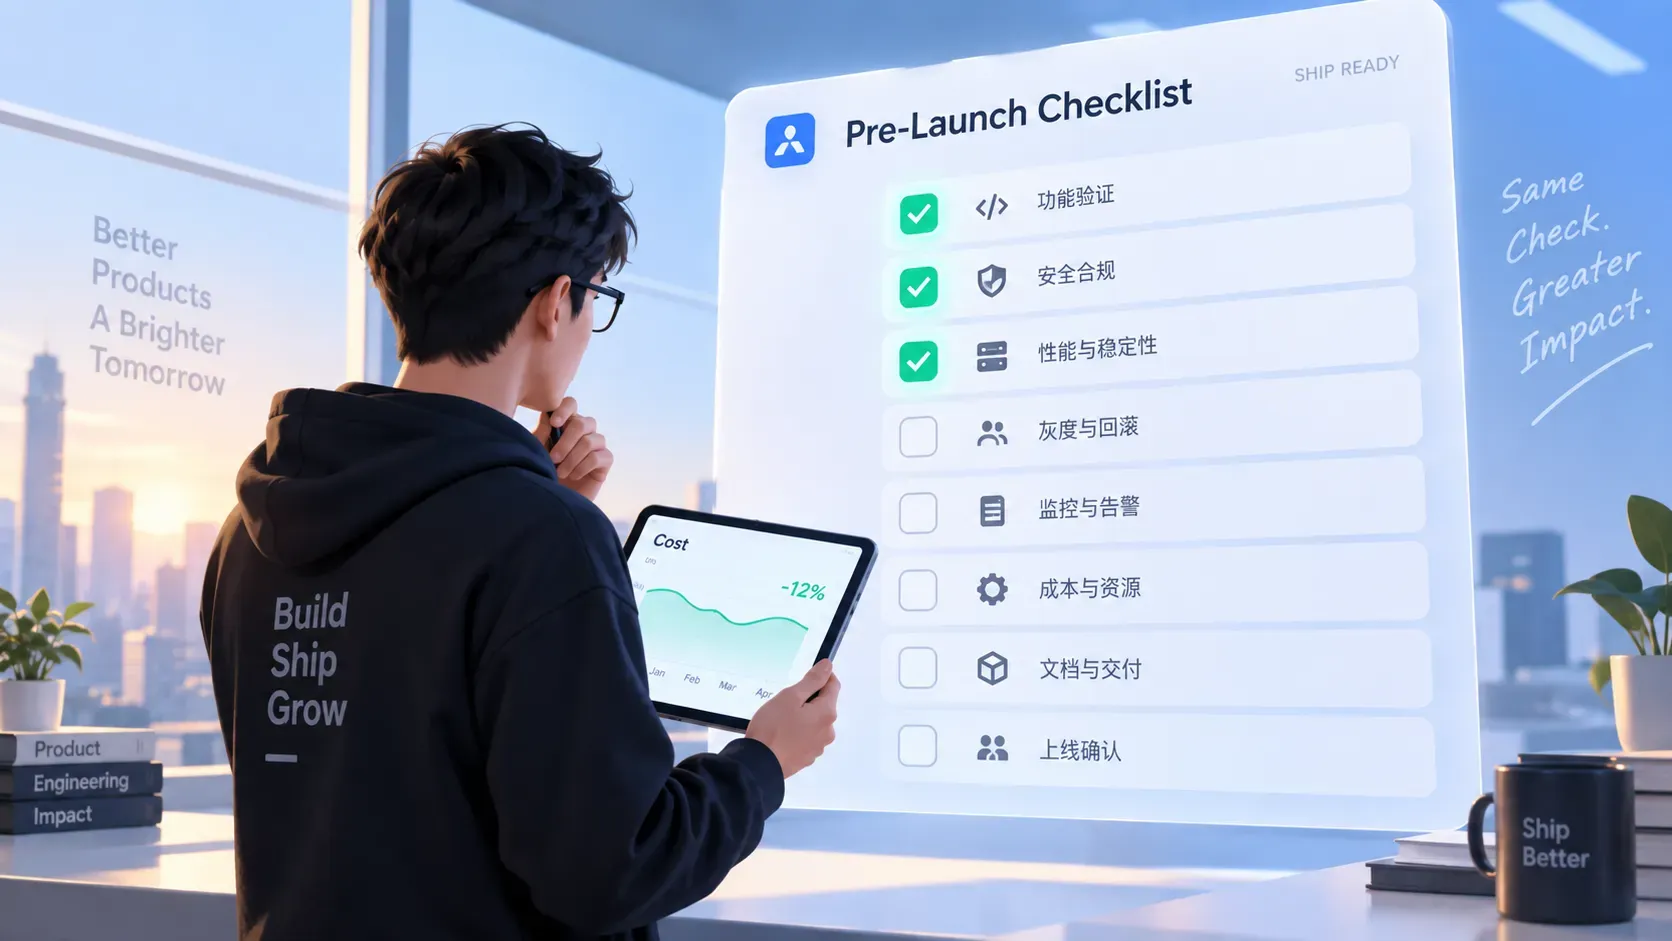
单子不齐不用慌,先补前三项,它们覆盖了最常见的三类翻车。剩下的,跑一个月有了真实账单数据,再回头补也不迟。
写到这儿想起个事。电灯泡刚发明那会儿,电是奢侈品,发电机的钱工厂主们咬牙出,可电费单没人管,直到后来电表和电网把一切都变成了看得见的账。
现在的AI调用,就是一百多年前的电。成本工程做的事说穿了很朴素,给新时代的电,装上电表。
成本工程做与不做,同样的业务量,账单能差出一个数量级。
这不是省钱的小聪明。一个AI项目从能演示走到能运营,门槛就在这儿。迈不过去的,都停在Demo阶段了。