老雷AI实验室
别再每次开新会话都自我介绍了,Agent 知识库的八层架构这么搭
你大概也遇到过这种事。Claude Code 明明上周刚教过你团队的提交规范,今天开个新会话,它又一脸茫然地把代码风格写回老样子。你教的写作风格随机漂移,你踩过的坑它接着踩。不是模型笨,是你的经验从来没有一个地方能让它读到。
我们被这个问题折磨了整整三个月。追新工具、换提示词、写超长的 CLAUDE.md,全试过,收效甚微,经验还是散落在聊天记录里,随开随丢。直到把问题想明白,毛病不在模型也不在工具,在于所有人都在卷工具,没有人把「上下文」当成一个工程问题来设计。
这篇把我们花三个月蒸馏出来的 Agent 知识库架构摊开讲,八层结构、路由铁律、记忆闭环,读完你能照着搭一套自己的。
工具越卷,上下文越没人管
先看两个事实。2026 年 AI 工具的更新速度已经离谱,OpenClaw 四个月拿下 25 万 GitHub 星标,Gemini CLI、Codex、OpenCode 每周出新版本,62% 的开发者已经用上了 AI 编码工具。我们自己追了半年新工具,核心产出没怎么动。
再看另一边,你的知识、经验、判断标准,这些东西换一百个工具都不会消失。
工具是发动机,上下文是导航和驾驶习惯,发动机再好,没有导航也是空转。
市面上的记忆方案,Mem0、Zep、Letta 这些框架解决的是让 AI 记住聊过什么。我们要解决的问题更大,是让 AI 在开口之前就知道你是谁、你怎么做事、你的标准是什么。这不是一个记忆框架,这是一个人完整工作系统的数字化。
为什么用 Markdown 而不是向量数据库
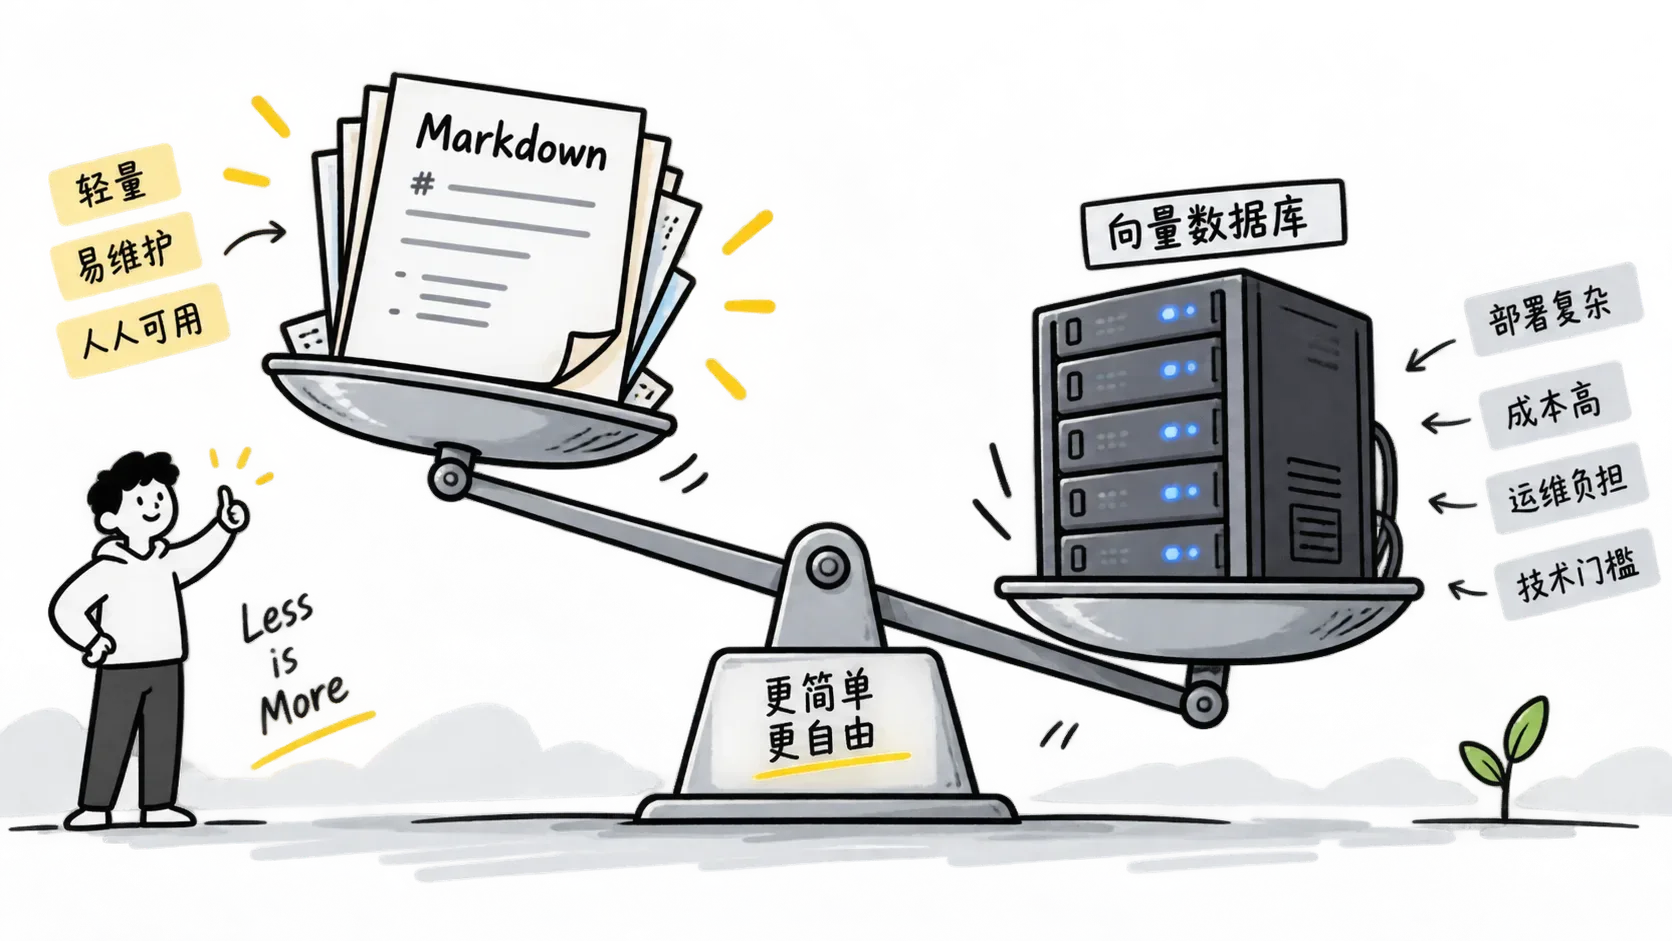
动手前查了 31 个知识管理理论,做的第一个关键决策是格式选 Markdown,不走向量数据库加知识图谱的主流路线。
五个维度比下来,Markdown 全胜。可读性,人和 AI 双向可读,向量库只有 AI 能读。追溯,Git 原生版本管理,谁改的、改了什么一清二楚。依赖,文本即数据,零运维,不用养服务。跨框架,任何 AI 工具都能直接读,不绑定任何一家。扩展,加字段不用动结构,向量库改一次 Schema 就得迁移。
老雷的判断是,对个人和小团队来说,简单的东西才能持久,持久的东西才能复利。向量数据库真正的主场是文档量超过十万篇、要跨文档语义搜索、有专门运维团队的场景。大多数人拿 Markdown 配一个轻量向量索引就够了,别为了管知识去学数据库。
八层架构加三条铁律
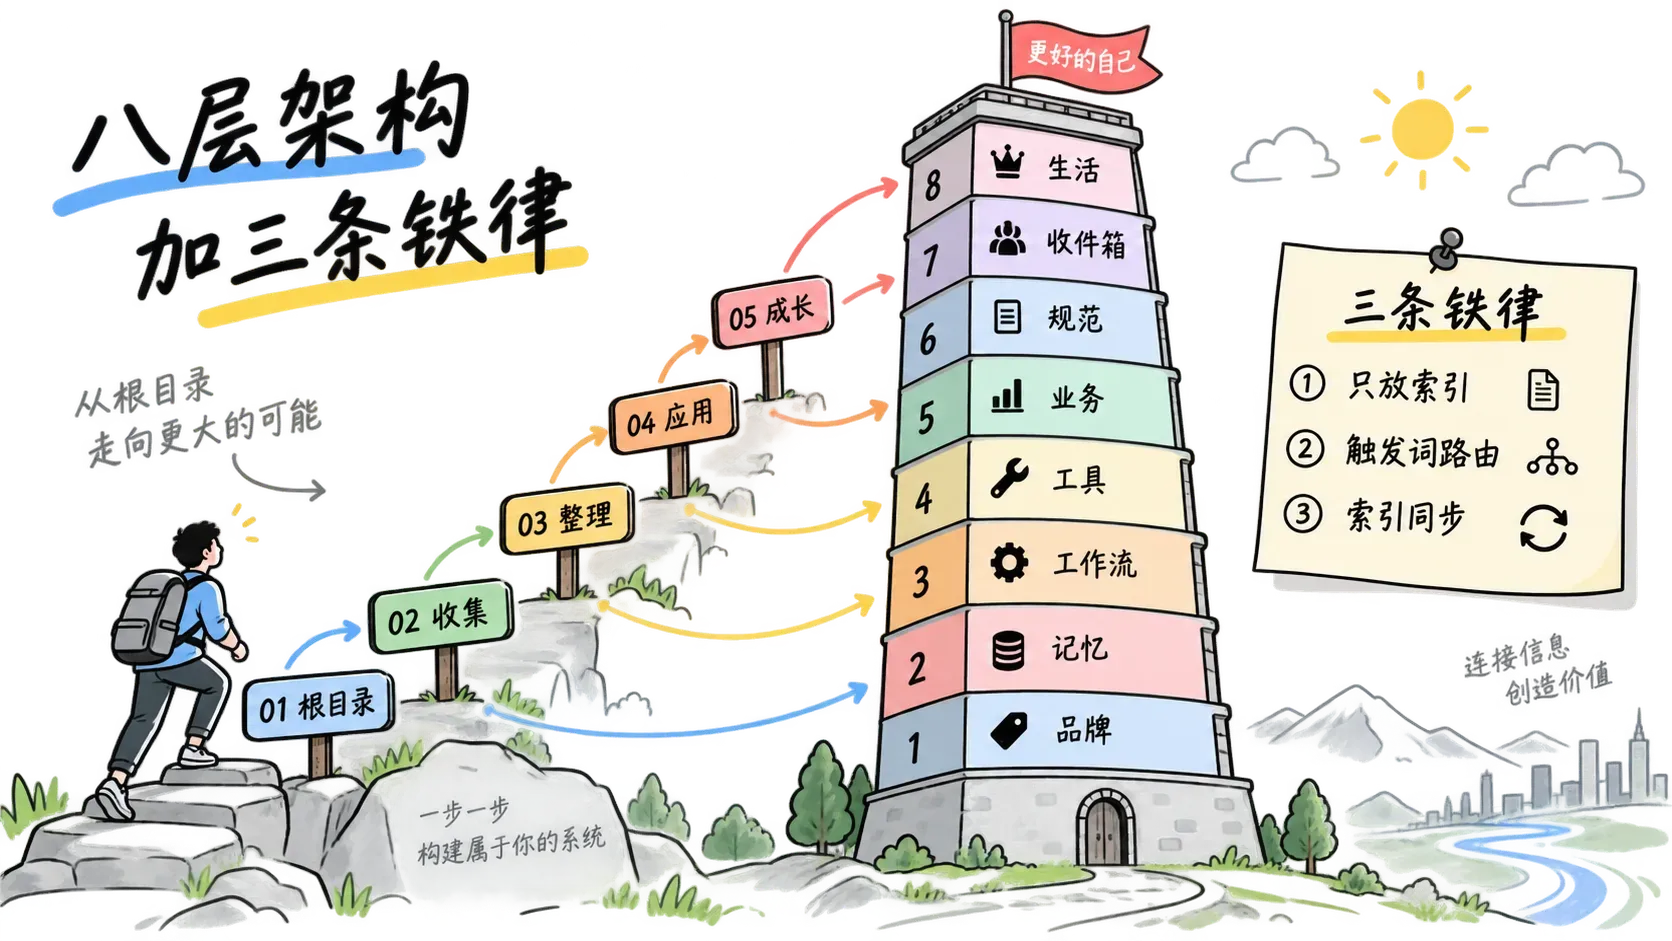
不管做哪个行业,做事都绕不开八个问题。我们是谁、学到了什么、怎么做、用什么工具、正在做什么、质量标准是什么、新信息从哪来、工作之外呢。把这八个问题映射成八层。品牌层管定位、表达风格、受众和专长。记忆层存规则、偏差记录和踩坑复盘。工作流层放 SOP 和步骤拆解。工具层管 CLI、Skill、MCP 和凭证。业务层放项目、产品和素材。规范层定质量标准。收件箱是外部信息唯一入口。生活层管健康、财务、关系这些工作之外的事。
前四层是核心,做事必须有。品牌和记忆始终加载,其他按触发词按需加载,上下文才不会撑爆。这套架构的精髓不在八层是哪八层,在正交性,每层职责不重叠,删掉任何一层,其他层照样能跑。
八层怎么串起来不乱,靠五层路由。根目录的 CLAUDE.md 做全局路由表,往下是域、子域、目录各级的 CLAUDE.md,一层层只做索引,最末端才是具体的内容文件。拿品牌层举例,根路由里写「风格」这个触发词指向品牌目录,品牌目录的 CLAUDE.md 再指向平台子目录,平台子目录指向具体的风格文件,一层层下来全是路标,没有一篇百科全书。
三条铁律记住。CLAUDE.md 是目录不是百科全书,只放索引不放内容。触发词必须可路由,每个 CLAUDE.md 里要有触发词到路径的映射表。新增或删除文件后,立即同步更新对应层级的索引。
打开任意一个 CLAUDE.md,三秒内能找到你要的文件路径,做不到就该重新设计。
品牌层是灵魂,工具层是手脚
品牌层回答我是谁、写给谁、什么调性。我们把它设计成三层正交结构。最里面是身份,定位、表达风格、专长、经历、商业模式等八个文件,写作前必读定位和表达风格这两份。中间是风格,按平台分目录,微信、小红书、推特、官网、知乎,每个平台下面再分风格子目录,每个风格自包含平台规则、语言习惯和结构模板。最外层是参数,风格描述拆成刚性和浮动两类,句长、人称、术语策略这些基因不随主题变,情绪基调、数据密度随主题调。配上 Fallback 三级降级,某个平台没有专属风格就逐级回落到通用风格,任何平台任何主题都有风格可用,实测风格覆盖率从六成提到了 98%。
工具层把 Agent 的手脚外化,大脑是模型,手脚靠 CLI 和 Skill。三个子系统。KB CLI 六个模块三十六条命令,管记忆、检索、收件箱、索引、维护、同步,写记忆、查知识、审收件箱、更新索引各有一条命令对应。九十一个本地 CLI 覆盖平台搜索、媒体处理、文档转换、内容发布这些领域,各自独立凭证、独立文档。再加一层路由多态凭证,同一个「搜索」意图映射到不同平台的后端,Agent 只认意图不认后端。
九十一个听起来吓人,真正高频的就十五个上下,其余都是长尾,偶尔需要时一条命令就能用。效率等于委托程度,工具不是越多越好,关键是多少重复活从你身上挪到了 Agent 手上。
质量稳不稳,看规范层。我们写了 22 万字规范、十七套,覆盖写作、品牌、产品、工具、Skill 各类产出物,所有规范文件本身又遵循同一套元规范,定位、格式参数、能力限制、审核、禁区、变更记录六块,自洽。没有规范的时候,AI 写出来的东西一股机器腔,有了规范,它知道你不用哪些套话、什么结构算合格,输出立刻稳定。Claude 的官方文档自己也说过,AI 在能验证自己工作的时候表现明显更好,规范就是那个验证标准。花时间写规范是投资不是成本,一页规范能省掉后面上百次重复纠正。
记忆的终点是归位,不是记住
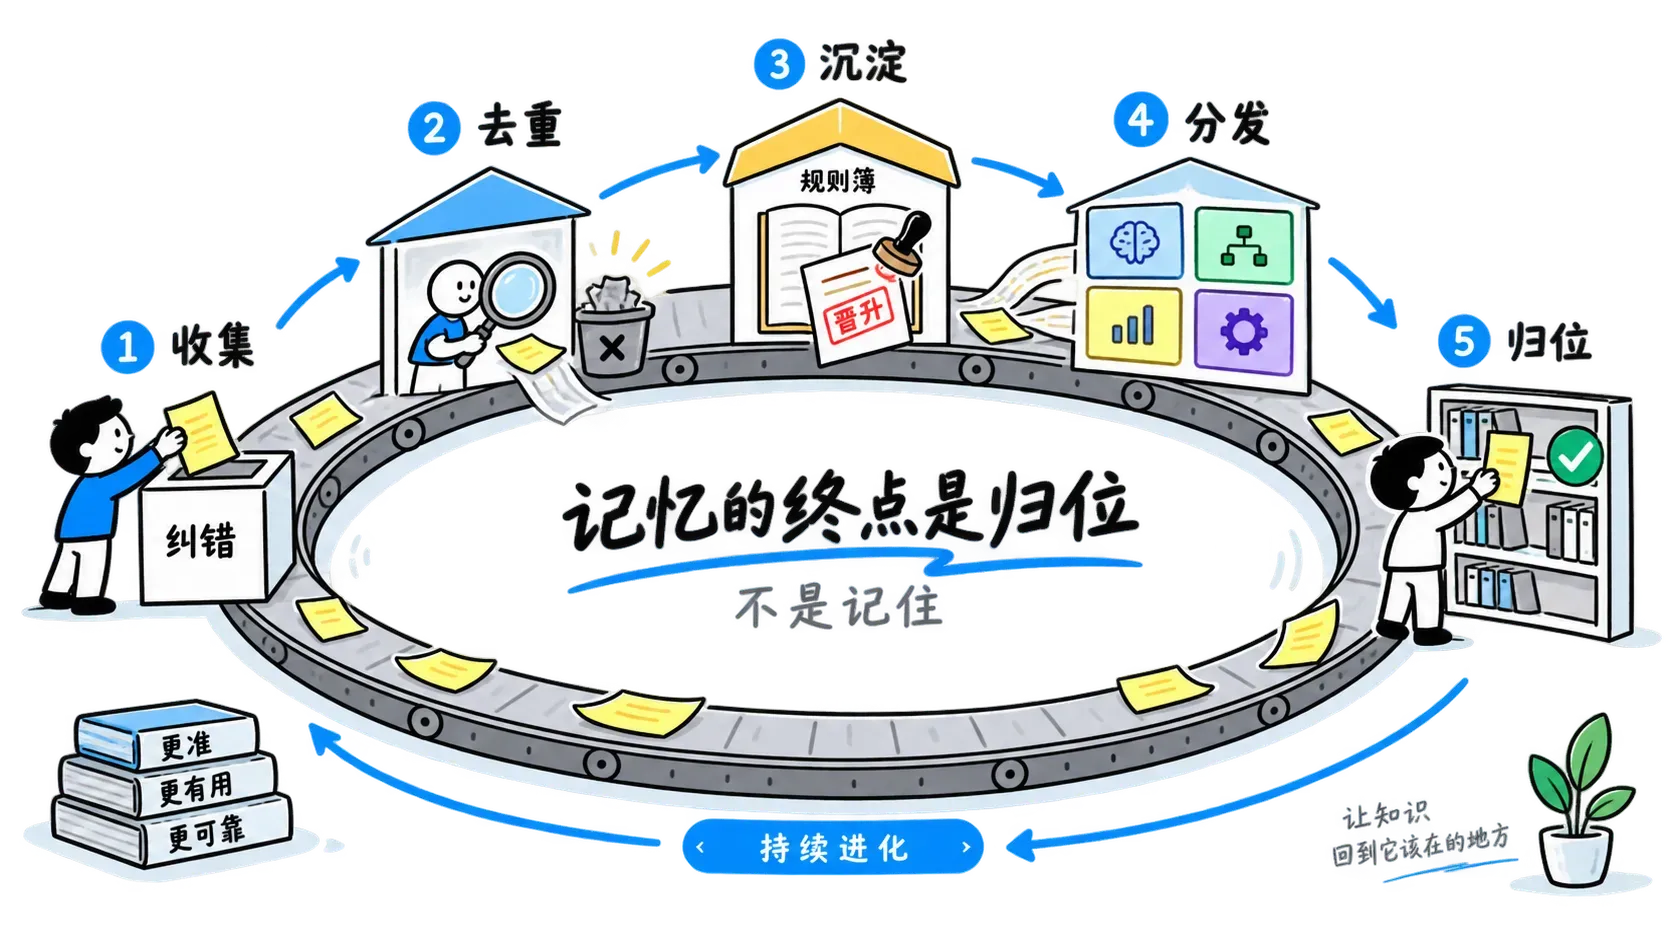
记忆系统解决的是 AI 犯过的错会不会再犯。五个环节跑成一个闭环。
你在会话里纠正了 Agent 的某个决策,比如它把提交信息写成了团队禁用的格式,你指出来,立刻用 KB memory add 把这条发现写进暂存。暂存满七天或满二十条,跑一次自动审查,让 Gemini Flash 过滤、去重、分类、合并,人不用一条条看。审查通过的条目晋升到规则文件,变成始终加载的核心规则。再跑一条同步命令,把规则双向投影到 Claude Code、Codex、Gemini CLI、OpenClaw 四个框架,一份真源多份投影,不用每个框架重复配置。终极环节是归位,被引用三次以上的规则,沉淀进对应领域的规范文件,不再占用记忆槽位,不然记忆系统自己会变成新的技术债。
信息入库走收件箱,它是外部信息的唯一入口,PDF、网页、书籍、截图都得过四阶段管线。提取,把原始内容抽成纯文本或 Markdown。提炼,结构化加去重加归类。审核,人工确认,不重要的可以交给模型自动过。入库,归位到对应目录再更新索引。一条信息有没有资格进库,问三个问题,会被引用吗、能产生决策吗、不写下来会忘吗,三个都不是就扔掉。
收尾交个底,别被 22 万字规范吓退。老雷提醒一句,从品牌、记忆、工具、规范四层的最小闭环起步就够,先让 Agent 跑起来,踩了坑再扩。没深度用过 Claude Code 也能学这套,架构本身是通用的,换成 Cursor、Gemini CLI 照样成立,只是路由文件的加载方式略有差异。
同一套架构,我们跑过自媒体长文产线,一句话进去,自动读身份和风格,出稿配图发三个平台。也跑过跨境电商选品,一句话问某个品值不值得做,它自己抓数据出报告写文案。同一个 Claude Code,两种完全不同的人格,区别只在背后的知识库。
真正让 Agent 变聪明的不是模型升级,是上下文的工程化。模型每半年升一代,你的上下文设计一次,永久复利。
这套架构没有任何一处非它不可的东西,用的模型、命令行工具、目录名都可以换,值钱的只有一条,把你的上下文当成工程来对待,给它结构、给它路由、给它记忆的出口。今天就可以动手,先建品牌和记忆两个文件夹,让你的 Agent 下次开会话之前,先读到你。