 老雷AI实验室
Gemini 微调流水线,n8n 两条工作流从素材跑到专属模型
我以前做风格注入,路子很直,把自己的经历、观点、写作特征全部塞进提示词里。效果有,但两个瓶颈越用越明显。提示词越写越长,上下文窗口被挤得越来越满,而且每次调用都得把这几千字的人设描述重新传一遍,token 白白烧钱。
更别扭的是长文场景。人设提示词和内容提示词在同一个上下文里抢注意力,两边互相牵制,谁也发挥不好。
直到把微调整条流程搬进 n8n 才发现,这件事完全可以一劳永逸,而且自动化搭好之后,新手照着流程也能跑通。这篇把整条流水线拆开讲,从一篇素材进表单,到专属模型出成文,中间不需要人守着。
为什么值得动微调
理解微调有个特别省事的类比。通用大模型就是一个万能函数 f(x),输入任何问题都能给出还不错的答案,但输出是通用的,没有你的风格、你的观点、你的表达习惯。
微调做的事情,是在这个通用函数上叠一个风格偏置 g(x),让输出从 f(x) 变成 f(x) 加 g(x)。这个 g(x) 不动模型的通用能力,但让所有输出都带上你的风格印记。
用大白话讲,提示词是每次上岗前现场教,微调是教会了再上岗。
这套打法不是纸上谈兵。实测里用一百篇女性作家的文章微调 Gemini 2.5 Pro,再配 n8n 批量生成,出来的东西不只学会了第一人称代入、犀利批评、故事化叙事这些表面风格,连把明星事件映射到职场困境、把游戏体验升华成人生哲理这种深层思维模式都迁过去了。同一个题目,提示词版像员工在念稿,微调版像作者本人在说话。效果细节,同系列的实测篇里有逐层拆解。
先说清楚微调改了什么、没改什么。它改的是输出的倾向,模型原有的推理和知识能力都还在,这也是新手最常担心的点,后面验收那节还会再提。
而提示词到底差在哪,差在三件具体的事上。
风格深度不够。你可以在提示词里写「用犀利的语气、第一人称代入、善用比喻」,模型会照做,但那种自然流露的风格感是模仿出来的。提示词写得越具体,文章越像在「表演」风格,而不是「拥有」风格,读者隔着屏幕都能感觉到那种用力过猛。
上下文成本高。每次调用都传几千字的人设描述,token 费用还是小事,真正的问题是它挤占有效上下文的空间。生成长文的时候,人设和内容在抢模型的注意力,两边效果都打折,而且这个成本是每次调用都要重复付的,批量生产一百篇就是乘一百。
一致性难保证。批量生成一百篇文章,每篇的风格都可能有微妙的差异,因为模型对提示词的理解存在随机性,同一套人设今天跑出来一个样,明天又是一个样。微调把风格固化到权重里,一致性是天然带出来的,不靠碰运气。
风格提示词治标,权重里的风格才是治本。
两条工作流,从文章跑到专属模型
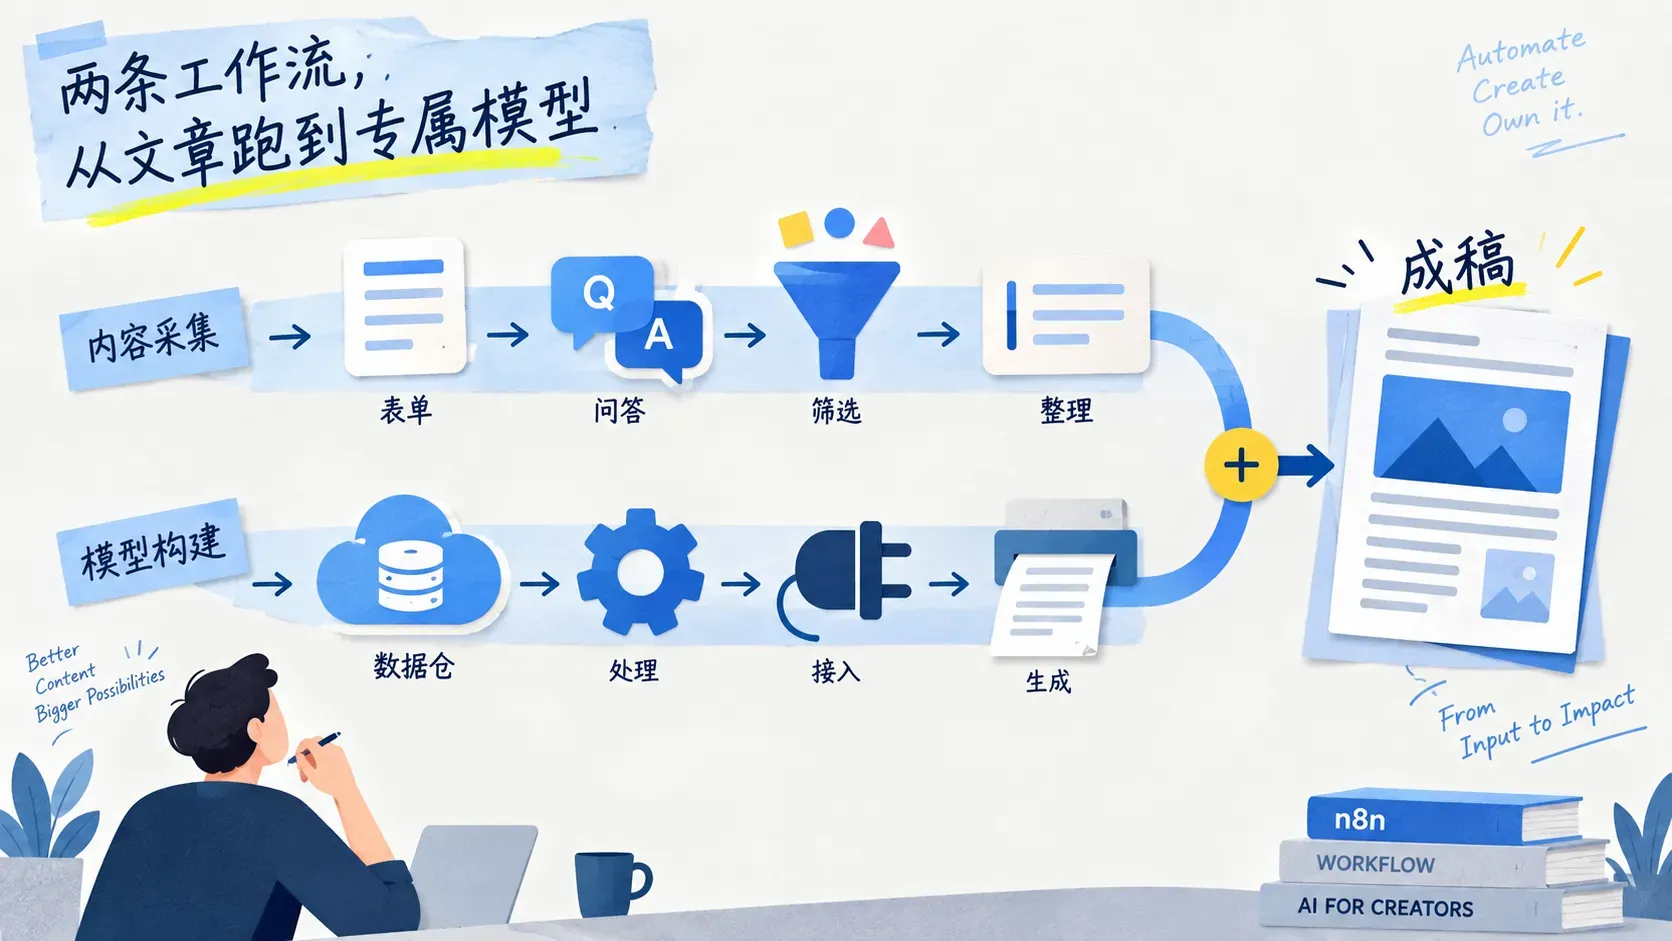
整条微调流水线用 n8n 搭成两条工作流,各管一段。拆成两条不是炫技,数据准备和模型训练的节奏完全不同,前者高频迭代,今天不满意明天重跑,后者低频重活,一轮几分钟到几小时,分开搭各自独立调试,改一头不用动另一头。
工作流一管数据集准备,链路是这样跑的。表单收原始文章文本,调用 Gemini 按逆向生成框架产出问答对,自动清洗去重,再按比例切成训练集和验证集,最后输出符合 Gemini 微调格式的 JSONL 文件。
入口做成表单看着朴素,好处是随手就能投喂,看到一篇好稿子,手机上贴进去,流水线自己往下跑。训练集和验证集的切分也由工作流自动完成,验证集别拿来参与训练,它是后面判断模型学没学歪的裁判。
这条链路里最值钱的是逆向生成框架。它不是把原文切成一段一段,而是让大模型从一篇文章反推,要写出这样的文章应该问什么问题、该配上什么回答,把写作意图和风格特征显式地组织成问答题对。模型学到的是可迁移的模式,不是对原文的背诵。训练数据的质量优势就是从这里拉开的,同样一百篇文章,普通切法和逆向生成的差距,在训练结果上非常明显。
工作流二管微调与调用。数据集先传到 Google Cloud Storage,通过 Vertex AI 的 API 启动微调任务,任务完成后拿到微调模型的端点 ID,之后在 n8n 里直接调用这个端点生成文章,后接自动配图和 Markdown 排版。这个端点在 n8n 里就是一个普通的模型节点,跟调用任何 API 没区别,唯一的区别是它说话带着你的味儿。到这一步,从素材进表单到成文出结果,中间一个人都不用守。
给 FDE 拆成 checklist 就是五步,攒一百篇风格统一的稿子,跑逆向生成产出问答对,清洗去重切分数据集,Vertex AI 提交微调任务,拿到端点接进工作流。老雷见过的卡点多半在第二步,问答对的质量决定后面所有环节的上限,这里值得反复调提示词框架,别急着往下走,底子打多深,模型的上限就有多高。
平台怎么挑
微调平台三条路,按需选。
Google Vertex AI 是微调 Gemini 系列的官方途径,2.5 Pro 和 2.5 Flash 都支持,效果最好,需要谷歌云账号和信用卡。实测微调 2.5 Flash 一轮几十到上百美元,具体看数据集大小和训练轮数,微调完成后调用价格和标准 API 一样,没有隐藏溢价。
预算有限,或者想调 LLaMA 这类开源模型的,看 Together AI,操作简单,成本更低,适合先小规模验证想法。
面向国内市场的,阿里云百炼和火山引擎都提供通义千问、豆包这些国产模型的微调,适合做国内受众内容的团队,合规和结算都省事。
挑平台的核心判断就两条,模型阵容里有没有你想要的基座,数据放上去流程顺不顺。这两条过了再看价格。三条路也不冲突,不少团队的做法是小成本先在便宜平台上验证数据质量,验证过了再上 Vertex AI 调正式模型。
还有个趋势值得记一笔,一键微调的平台正在变多,上传数据、选好基座,剩下的事平台替你办完。这个形态会把微调的使用门槛继续往下压,今天还嫌麻烦的团队,过半年再看可能就是点几下按钮的事。
新手最常问的四件事
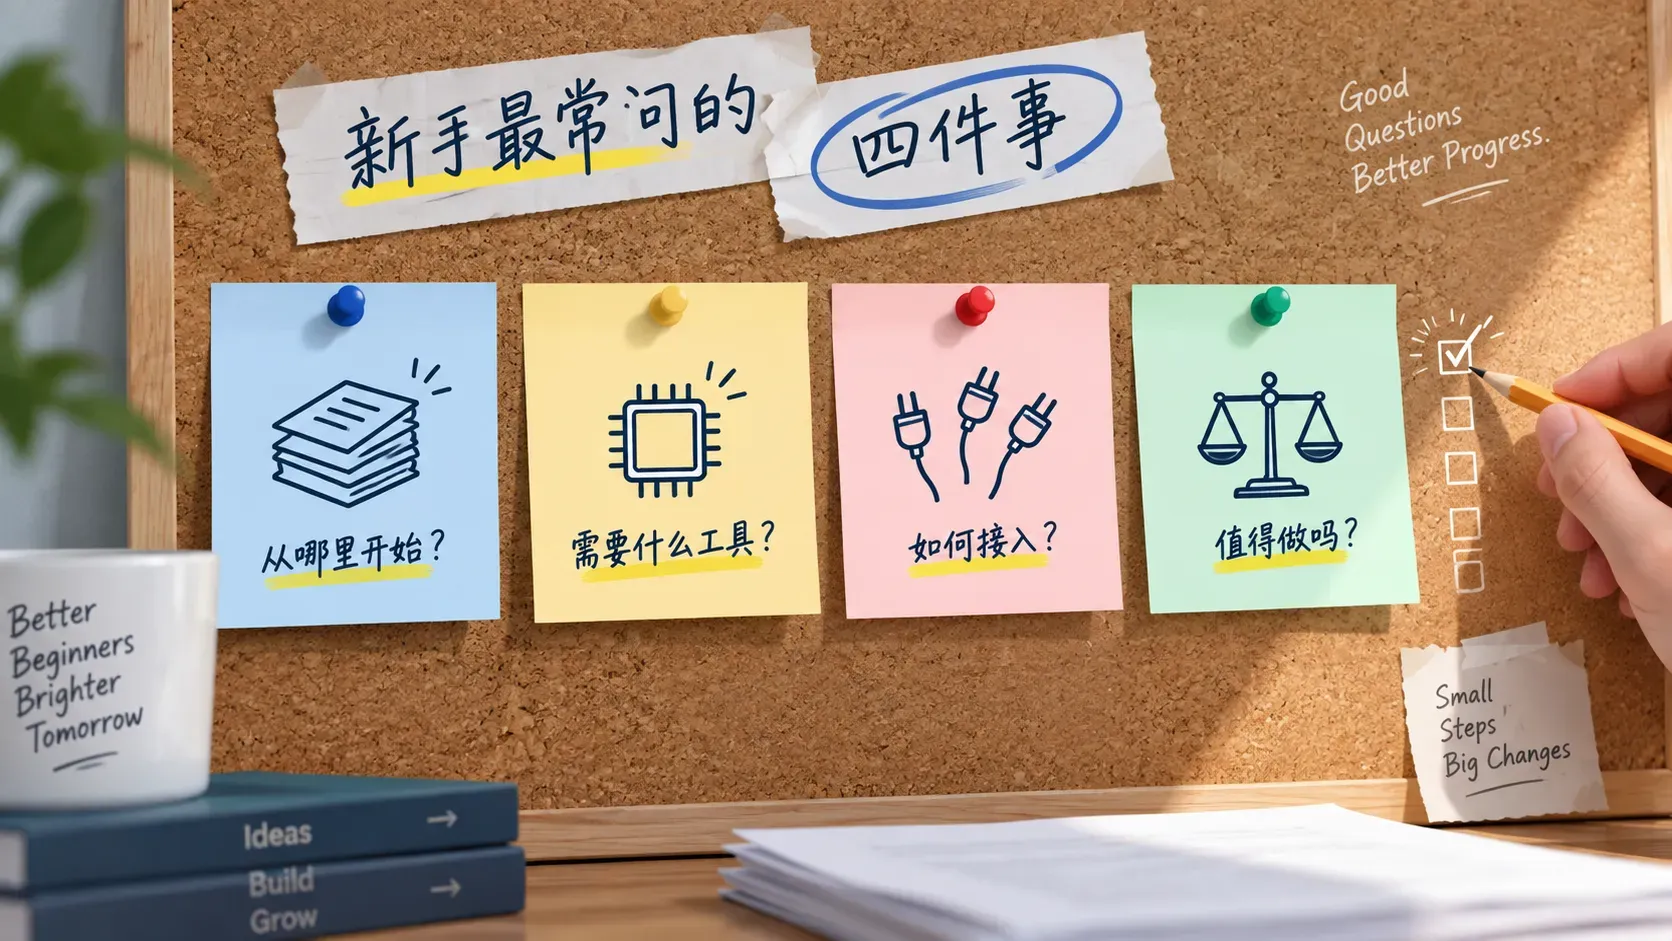
一百篇文章够吗。实测的答案是一百篇高质量文章是个很好的起点,数据质量远比数量重要,一百篇风格鲜明的文章,效果好过一千篇风格混杂的。自己动手时先做抽样对比,同一批题目让原模型和微调模型各写一遍,差异不到位的题,多半是训练数据里这类样本太少,回头补数据比调参数管用。
微调完通用能力会不会坏。这是最常见的担心,实测的体验是风格偏置是叠加上去的,模型的基础推理和知识能力还在,只是输出时更倾向用你的表达方式。稳妥起见,上线前把通用任务也抽测一遍。
能不能一个模型管多种风格。可以,每种风格单独准备数据集、单独微调,得到多个端点,n8n 工作流里按需求切换调用。注意每个端点都是一份独立资产,风格别裂得太碎,几个核心风格足够大多数团队用。
三个方案怎么搭配。提示词、RAG、微调不互斥,最强的组合是微调固化基础风格,RAG 补充最新知识,提示词控制单次任务的参数,让每个方案干自己最擅长的那部分事。
先把风格养成熟
最后说句实在的,微调适合风格已经成熟、需要规模化产出的团队,一次性投入换长期受益,前提是你已经知道自己要什么风格。
还在探索期的,提示词仍然是更灵活的选择,今天犀利明天温柔,改一行字就行,别急着把自己焊死在某个风格上。等哪天你发现自己在不同的提示词里反复描述同一套风格,那就是该微调的信号。
老雷的建议是把顺序反过来用,先用提示词把风格打磨稳定,顺手攒够一百篇代表作,等风格成了资产,再上这条 n8n 流水线把它焊进权重。到那时,从选题到成文的整条内容生产线,就可以真正做到无人值守,你要做的只剩下最后那道把关。