 老雷AI实验室
公司文档堆成山,AI为什么还是答不对你的问题
问一个很多老板都疑惑过的问题。
公司的知识散落在几十个文件夹、好几块云盘、几百条聊天记录里,什么都有。可打开 AI 对话窗口,问一个自己领域的深度问题,得到的回答却像搜索引擎摘要,泛泛而谈,缺少你们真正积累的判断和细节。
很多人第一反应是换个更贵的模型。老雷把话放在前面,换模型大概率没用,问题不在 AI 的能力上限,而在你喂给它的知识下限。上限是厂商的军备竞赛,下限才是你能动手改的部分。
今天这篇是给 FDE 和技术负责人的实操指南,讲清楚文件夹和知识库的本质区别,四层架构怎么搭,以及一份从零构建的检查清单。
先划一条线,文件夹不等于知识库
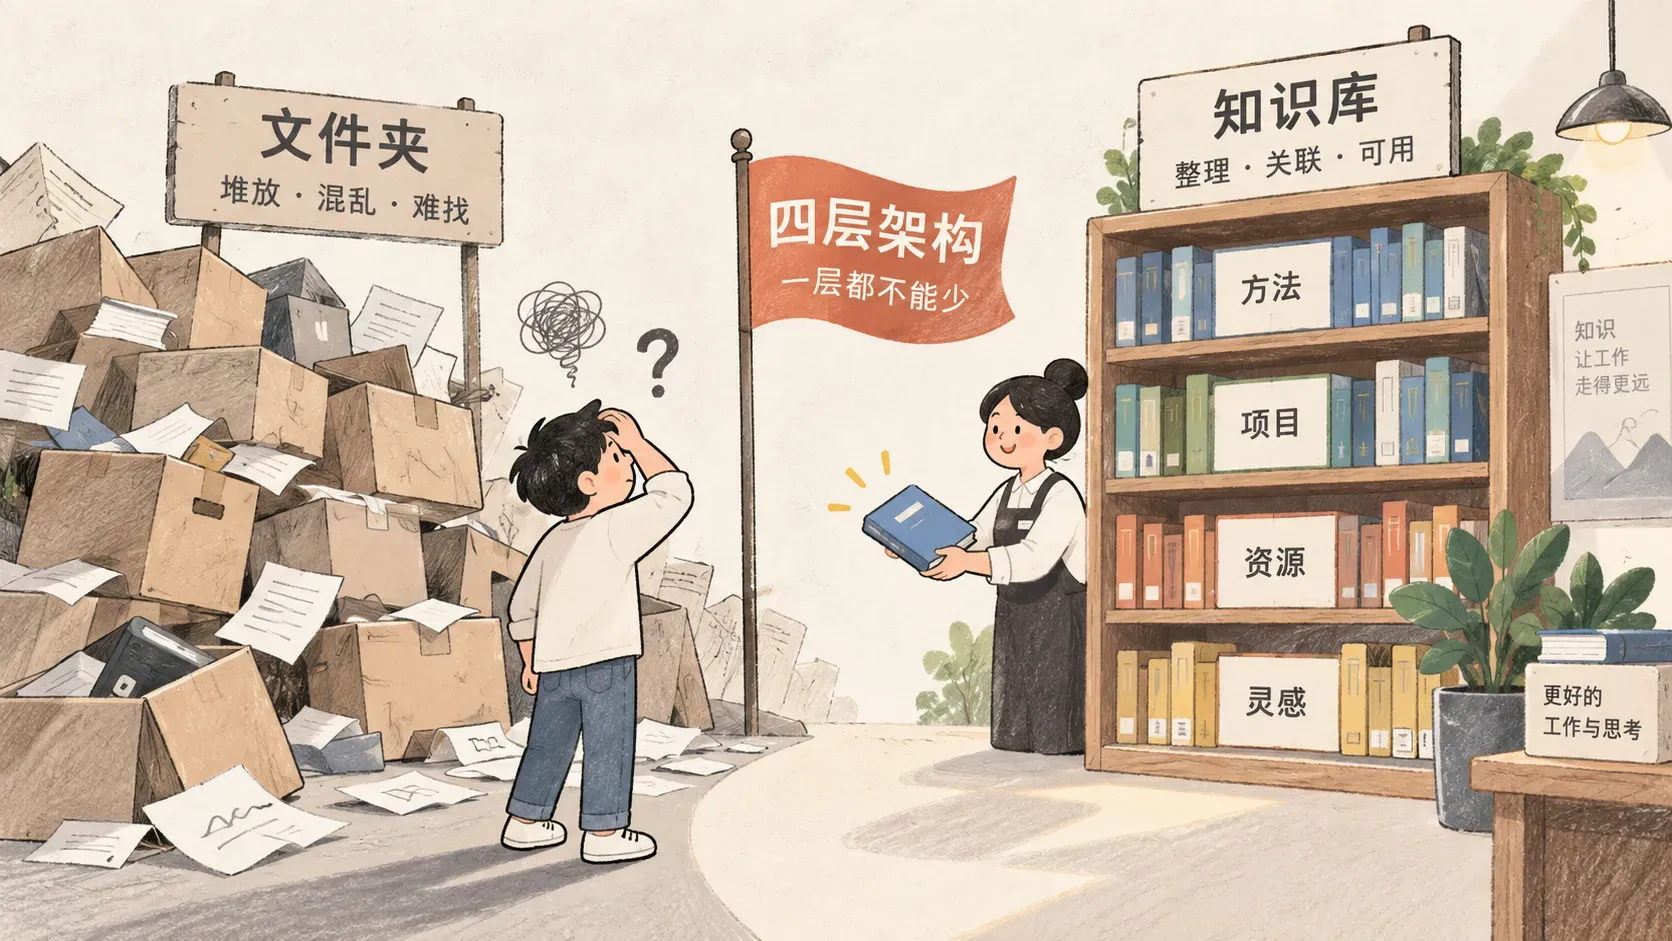
文件夹是存放文件的容器。你在里面放了 200 份文档、30 个 PDF、几张架构图,文件夹不会拒绝任何东西,也不会告诉 AI 这些文件之间有什么关系。AI 打开这个文件夹,看到的就是一堆孤立的文件名。
知识库在文件夹之上做了三件事。
结构化,每份知识文件有统一的元数据和分类标签,正文用多级标题建立内容层级。这样 AI 能跳到特定章节精确读取,而不是把整篇当一串文字从头啃到尾。可导航,有一份导航文件告诉 AI,品牌相关知识在哪个目录、工具文档在哪个目录、查某个概念先去哪里。没有这份导航,AI 只能遍历全部文件,又慢又费「记性」。可产出,知识文件不是被动被读取,而是配合规则和模板,让 AI 直接调用知识完成写作、分析、决策这类任务。存而不用,等于图书馆只进书不借书。
差距是惊人的。同一个「根据我们的品牌定位写一篇推广文」的指令,对着散落文件写出的东西,和对着结构化知识库写出的东西,完成度能差几倍。后者能自动调取品牌定位、受众画像、历史爆款数据、写作规范,全部融进产出。同样的问题换个问法,答案的深度也完全不同,因为 AI 能顺着结构化的线索,挖到你埋在角落里的那些真实判断。
打个比方,文件夹像一个没有目录的图书馆,书随意堆在地上。知识库是分好类、贴好标签、配了管理员的图书馆,你说一个关键词,管理员把相关的书摆到你面前。
四层架构,一层都不能少
能稳定支撑 AI 产出的知识库,通常包含四层。
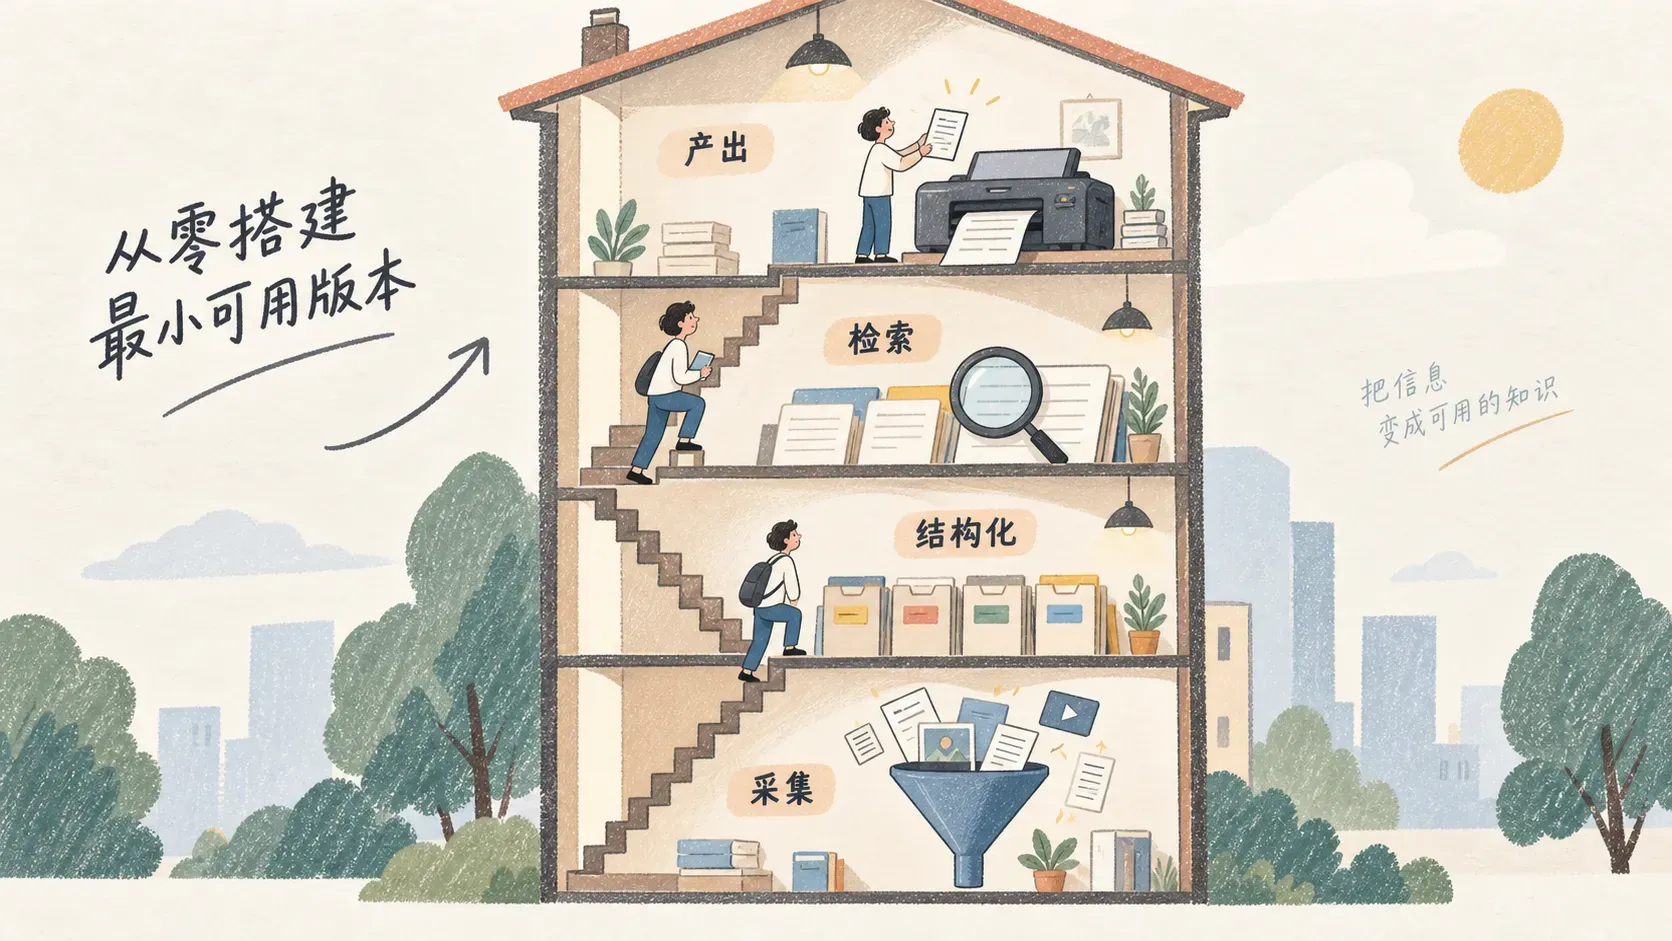
第一层,采集层,把散落的知识收拢进来。微信群里技术讨论、收藏夹里的参考文章、代码仓库的注释、电子书和课程笔记,统一收拢、转成可编辑的格式。这里有条重要的纪律,采集不是囤积。一个判断标准,如果这份素材三个月后你想不起来为什么存它,它就不该进知识库。每一份入库文件都应该有明确的用途指向。
实践中最高频的采集动作就四类。网页文章,抓取原文转成 Markdown,保留标题结构。电子书,PDF 或者 EPUB 按章节拆成文本文件。聊天记录,群里的技术讨论导出成纯文本归档。内部文档,代码仓库的说明文件、架构文档、关键注释提取入库。四条通道跑起来,散落的碎片就开始往一个池子里汇。
第二层,结构化层,让 AI 能解析而不只是能读。三个核心动作,统一格式(全部用 Markdown,开头加元数据标注分类和关键词)、分层标题(用标题层级建立内容结构,让 AI 能跳到特定章节)、目录导航(每个目录放一份导航文件,写明这个目录有什么、常用触发词怎么路由)。选 Markdown 这类纯文本格式而不是某个协作文档平台,原因只有一个,可移植性。任何 AI 工具都能直接读取纯文本,不依赖特定平台的接口。你换了工具、换了模型,知识库照样能用。公司的知识不应该被锁在任何一个软件产品的仓库里,锁进去那天,议价权就在别人手上了。
第三层,检索层,解决从哪找、怎么找。文件量在几百份以内的知识库,导航文件加 AI 工具原生的文件读取就够了,AI 通过触发词定位到目录,再读取具体文件,几秒的事。量更大或者要跨系统调用时,再上语义检索方案,把文件切成小段转成向量,按语义相似度匹配最相关的段落。小书店找书靠记忆逛,百万藏书的图书馆才需要检索系统。
我们前几天发过一篇实战,一条 30 字的指令稳定产出一篇 6000 字长文,背后撑着的就是这套架构,检索层的功劳占了一半。
第四层,产出层,知识库的终极价值不是被读取,而是被使用。把检索到的知识和预设规则结合,让 AI 直接完成长文写作、技术文档、数据分析报告、培训课件这些具体任务。每个场景配一份对应的模板和规则文件,产出就从「碰运气」变成「按流水线出品」。
举例说,写一篇推广文时,AI 会自动调取品牌定位、受众画像、历史爆款数据、写作风格规范,把这四样融进一篇文章里。做技术文档时,它读取架构设计文档和接口规范,产出部署教程。产出层考验的是规则和模板的沉淀厚度,模板越具体,产出越接近「直接能用」。
从零搭建的最小可用版本
理论讲完,动手只要四步。
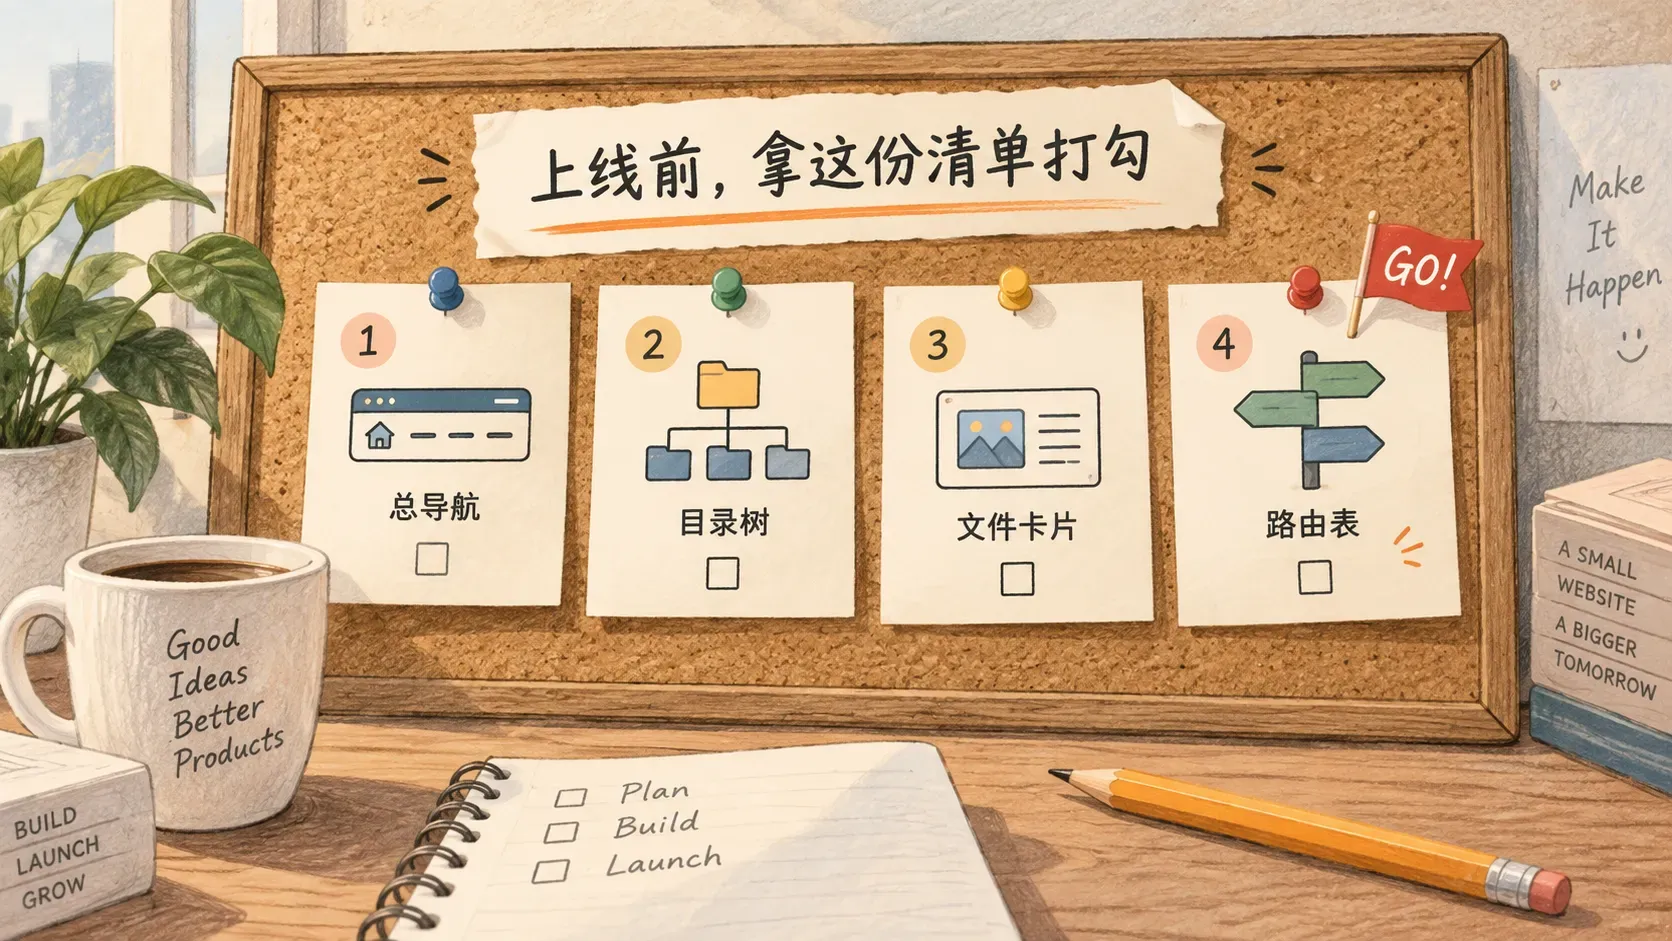
第一步,建根目录,写总导航文件。核心内容三块,目录索引(所有一级目录及用途)、触发词路由表(提到什么话题,去哪个目录找)、使用规则(文件格式、命名规范、更新规则)。不用一次写完,从最常用的三五个知识领域起步,边用边扩。选领域的标准也简单,挑那些新员工入职时你反复讲、客户反复问、团队里最依赖某位老脑子记忆的部分——这些是最先该被结构化的知识。
第二步,设计目录结构。按知识领域划分,一条核心原则是一个目录只负责一类知识。比如品牌、工具、规范、素材、业务、研究,各管各的,每个一级目录下再放一份本目录的导航。
第三步,编写知识文件。全部 Markdown 格式,开头加元数据标注标题、分类、关键词、日期。一份文件聚焦一个主题,坚决避免万能大杂烩,一份文件里塞了定位、画像、竞品分析和写作风格的混合体,AI 用起来反而更低效。粒度越细,检索越准,这个原则贯穿始终。
第四步,在总导航里建触发词路由表。比如提到品牌定位,去品牌目录的身份文件找;提到写作规范,去规范目录。这张表建好后,AI 每次启动都会先读它,用户提到任何话题,它都知道第一步行囊往哪放。
上线前,拿这份清单打勾
- 每份知识文件都有元数据和分层标题
- 每个目录都有导航文件,根目录有总入口
- 触发词路由表覆盖了最高频的十几个使用场景
- 采集有纪律,没有「先存着再说」的死文件
- 全库统一 Markdown,没有锁死在某个平台里
- 至少跑通一个产出场景(比如按品牌规范写一篇推广文)
全打上勾,你的知识库就从「文件堆」升级成了「知识资产」,AI 的每个回答背后,都有你公司的真实积累在撑腰。
上线之后还有三条维护纪律,决定这个资产能不能保值。新踩的坑当天写进对应文件,过夜就忘。规范先行、内容跟上,先定标准再填东西,反着来永远对不上。每月做一次结构审计,删过时的、合并重复的、更新失效的。
这三条没有一条需要技术,需要的只是把它当成正经工作排进日程。
工具会换,模型会换,唯一不会被换掉的是结构化的知识资产本身。
最后说个判断。评估任何 AI 项目时,老雷都会先看对方的知识库长什么样。文件夹式散养的项目,演示惊艳、上线拉胯,几乎是规律。因为 AI 的回答质量,上限是模型,下限是知识。而下限,才是企业能自己动手改的部分。
古腾堡印刷机普及之后,人类花了两百年才建立起图书馆的分类法。知识放在那里不叫资产,能被精确找到、被反复使用的知识才叫。这一轮 AI 落地的竞争,说到底就是各家「建馆速度」的竞争。
而这场竞争的好消息是,建馆的材料,你公司里早就堆着了。缺的从来不是砖,是那张图纸。