 老雷AI实验室
Hermes 接本地模型实战,64K 硬门槛和六个必踩的坑
先说一个数,2048。
这是 Ollama 拉完任何一个模型之后默认给你的上下文窗口,单位 token。而 Hermes Agent 的最低要求是 64,000。这两个数撞在一起,结果就是 Hermes 启动时直接拒绝,报错退出,一句多余的解释都不给。
我第一回把 Hermes 接上 Ollama 就栽在这。模型明明跑起来了,聊天对答如流,一启动 Agent 就被拒,翻了一圈配置才想明白,不是模型不行,是窗口不够。这篇把本地推理的三条路、选型的关键分水岭、六个高频坑的排障思路全部拆开,给要交付私有化 Agent 的工程师一份能照着走的清单。
三条路,先看你的机器是哪种
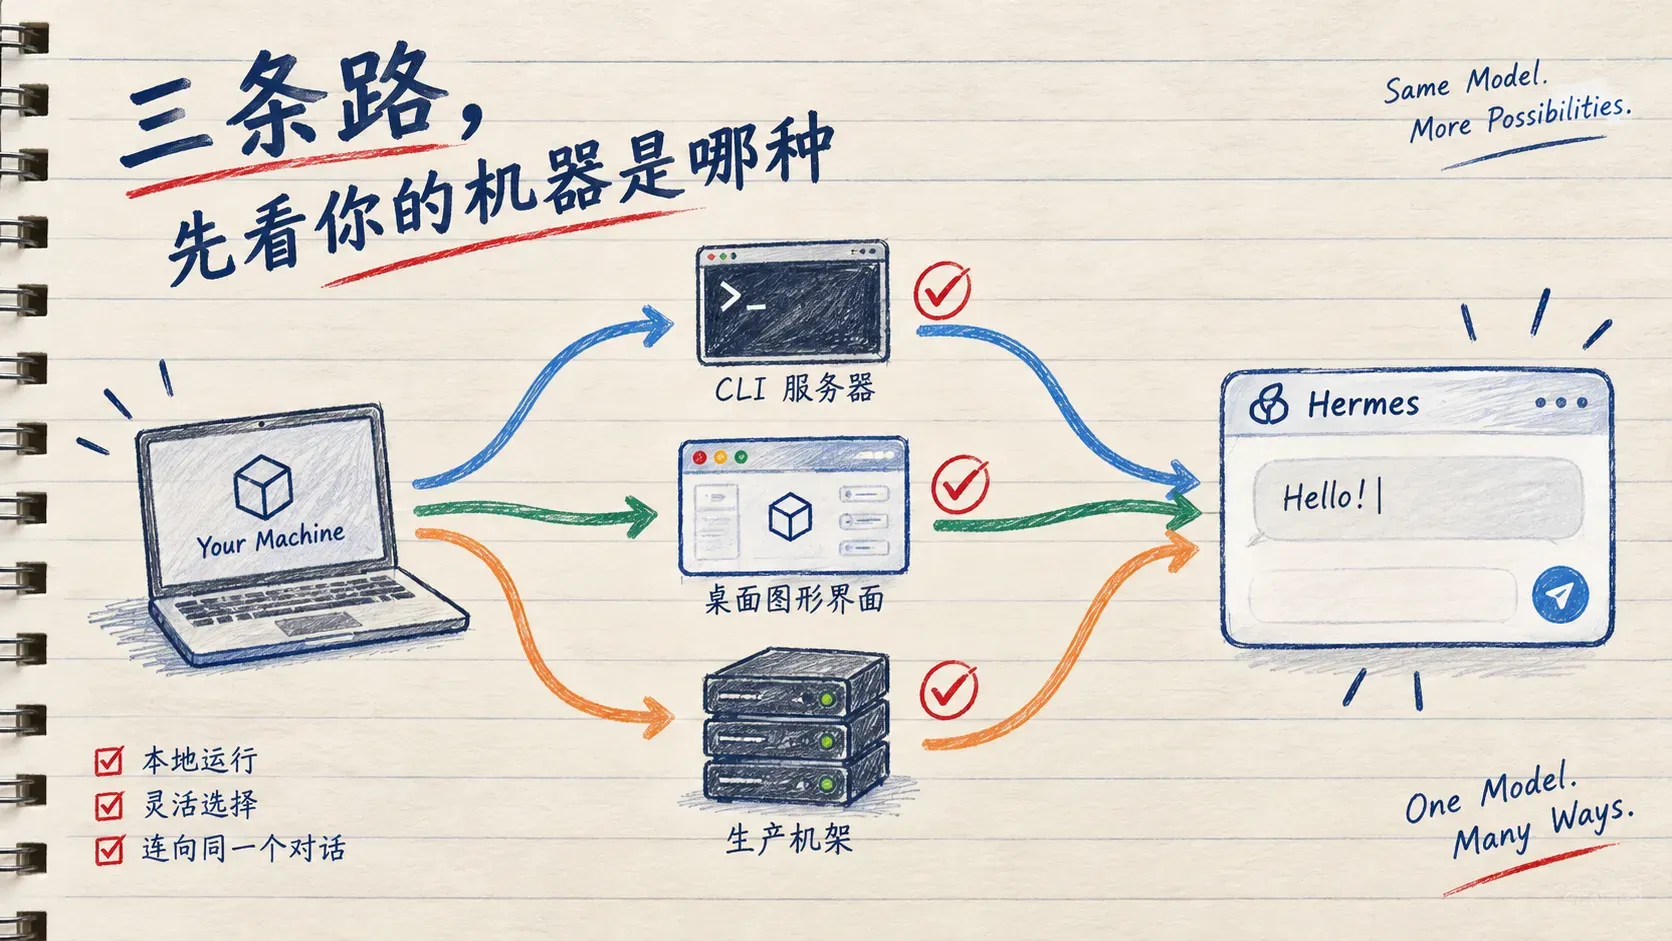
Hermes 接模型走 OpenAI 兼容协议,任何暴露 chat completions 端点的推理后端都能接,主流就三条路,一条条说。
Ollama 是最轻的,一行命令安装,一行命令拉模型,服务器部署和 Docker 场景的首选。LM Studio 是桌面应用,下载、加载、切换全在图形界面里点,还带 JIT 加载,收到请求才把模型装进内存,空闲自动卸载,内存紧张的机器特别受用。它还有个 LM Link 功能,重活留给家里的 GPU 工作站,笔记本装 Hermes,出差在咖啡厅也能吃到远程显卡的推理。vLLM 是生产级选项,PagedAttention 内存管理加多 GPU 并行,要在集群上给多个 Agent 实例供血,选它。
三条路在 Hermes 这边的接法完全一样,把 provider 设成对应标识,再指到本地端点。Ollama 默认端口 11434,LM Studio 默认 1234,vLLM 自己起 8000。区别只在你怎么管理模型本身。老雷的建议是,先拿 Ollama 把链路跑通,长期给 Gateway 供血再上 vLLM,图形界面党直接 LM Studio。
vLLM 这条路补一个容器场景的坑。Hermes 的 Docker 容器连独立部署的 vLLM,别的客户端都正常,偏偏 Hermes 连不上,八成是两个容器不在同一个 bridge 网络。放进同一个网络,再给 Hermes 配上 host 映射,或者干脆用 host 网络模式绕开隔离,顺带把流式超时拉长,本地推理慢,容器里默认的超时会先断。
Ollama 像应用市场拉了就跑,LM Studio 像文件管理器点点鼠标,vLLM 像 Nginx 面向生产流量。
64K 上下文,第一道硬门槛
为什么非要 64K。Hermes 的 Agent 管线要在一次对话里塞下系统提示词(约 2K token)、工具 Schema 定义(2K 到 19K,看你开了多少工具)、持续增长的对话历史,还有模型自己的输出。2048 的默认窗口连系统提示词都放不下。64K 是 Hermes 团队测出来的安全下限,刚好装下一轮完整的工具调用循环。
Ollama 侧的解法是用 Modelfile 重建模型,两个参数,numctx 设 64000,numgpu 设 99,能卸到显卡的层全部卸过去,显存不够的自动回落 CPU。建完给模型起个新别名,Hermes 那边填这个别名。
这里藏着一个非常阴的坑。Ollama 的模型信息接口报的是「最大支持上下文」,不是你实际配的 num_ctx。你要是只在启动命令里带参数,没写进 Modelfile,Hermes 一查接口看到的数字挺漂亮,实际推理还是 2048,错误照报。所以别信运行时参数,写进 Modelfile 持久化,这是一条铁律。
LM Studio 这边省事一点,模型设置面板里把 Context Length 滑到 64000 就完事。但 64K 的 KV 缓存要额外吃掉几个 GB 内存,机器得留足余量。
选型看什么,工具调用是分水岭
本地模型选型,最容易走偏的方向是看跑分。MMLU、GSM8K 这些基准衡量的是模型思考的能力,但 Hermes 要的是另一件事,该调工具的时候不犹豫,拿到结果能接着往下推进。两种能力相关,但不等价。
社区今年 5 月做过一轮基准,19 个模型跑 25 个真实 Agent 任务,结论很直白。3B、7B 的小模型经常无视工具调用指令,或者生成格式错乱的调用。Hermes 内置 auto-repair 能自动修一部分格式错误,但修复成功率随模型变小一路下滑。云端一线模型在这项上依然有绝对优势,这也是后面混合策略的伏笔。
按硬件给三档。8 到 16 GB 内存,跑 3B 到 9B 档,只能当聊天窗口,工具调用指望不上。24 GB 上下的 Apple Silicon,量化后的 31B 模型大约每秒 5 到 8 个 token,这是能拿到完整 Agent 体验的入门线。32 GB 以上再配一块 8 GB 显存的 NVIDIA 卡,31B 能跑到每秒 15 到 25 个 token,目前公认最稳。想要视觉理解,27B 的 Qwen 是多模态,多卡环境能推到每秒 30 以上,内存盘子也更大。
Apple Silicon 用户再提醒一句,Ollama 和 LM Studio 都原生支持 Metal 加速,前提是你装的是 ARM 原生版本,套在 Rosetta 里跑就白瞎了统一内存的优势。
六个高频坑,照单排障
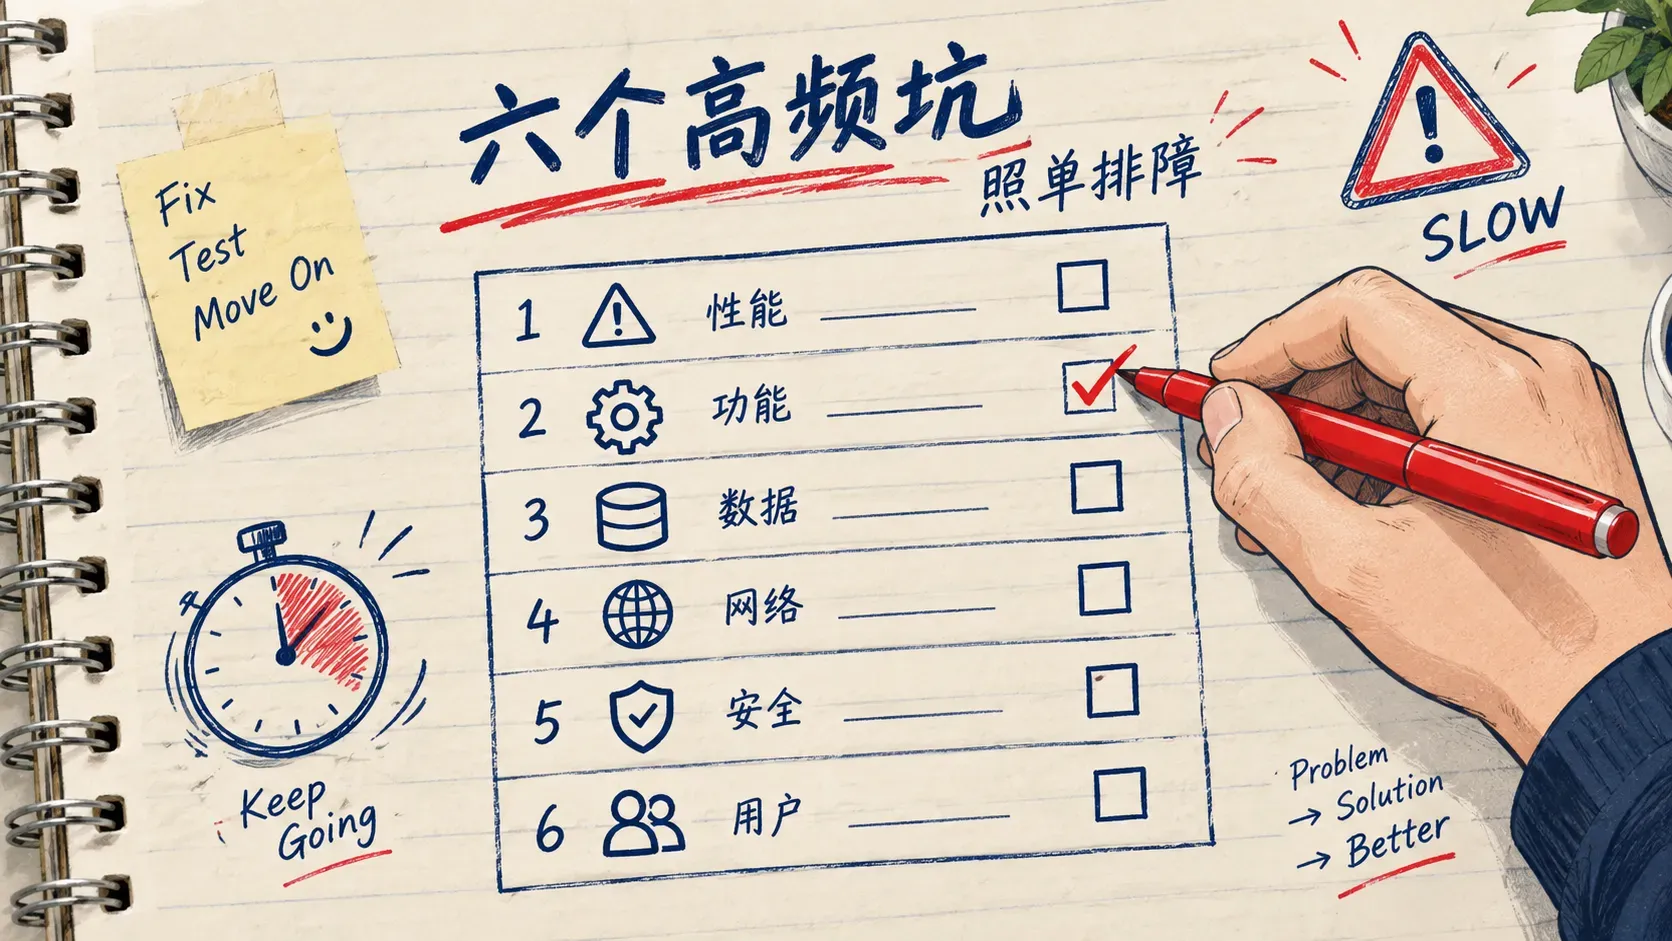
这六个坑是社区问答区出现频率最高的,交付前照着过一遍,能省下大量排障时间。
第一,响应慢到离谱。有人在 64 GB 内存的 Mac Studio 上一次响应等了 20 多分钟。先用 ollama ps 看两件事,模型是不是太大开始走内存交换,GPU 层数是不是 0。参数超过可用内存,系统把数据换到磁盘,速度从几十 token 每秒断崖跌到不足 1。另外别手痒把上下文往 128K 设,64K 是最低要求不是越大越好,窗口每大一圈,KV 缓存多吞几 GB。
第二,Hermes 比裸模型聊天慢得多。同样的模型,LM Studio 里秒回,接进 Hermes 就要等。这不是 LM Studio 的锅,是 Agent 管线在每次请求里注入系统提示词、工具 Schema 和记忆上下文,72 个工具的 Schema 定义就占约 19,210 token。解法是开工具延迟加载 toolsearch,模式设 auto,阈值 0.1,常驻 terminal、readfile、writefile、listdirectory、send_message、memory、skills 这 7 个最常用的,其余按意图动态加载、3 轮不用自动卸载。实测工具 token 从 19,210 降到 2,200 上下,砍掉 89%,本地响应速度直接上一个台阶。长对话再配定期压缩,效果更稳。
第三,模型不执行工具调用,回你一段代码文本糊弄。小模型的指令遵循能力有限,换 31B 档是根治办法,或者配 fallback 让云端兜底。
第四,压缩风暴。主模型限流的时候,对话压缩这个辅助任务默认跟着主模型走,一起挂,Agent 直接丢掉全部对话上下文。解法是把视觉理解和压缩各自显式配独立 Provider,比如视觉走 Gemini,压缩走 DeepSeek,跟主模型在 Provider 层面彻底解耦。老雷见过不止一个团队栽在这,配对一次之后这个坑就永久消失。
第五,纯 CPU 推理超时。31B 模型在 CPU 上每秒 2 到 5 个 token,一次响应 30 到 120 秒,Hermes 默认 120 秒的流式超时根本不够。把全局超时和流式超时都拉到 1800 秒,Hermes 检测到本地端点会自动放宽一部分,但大上下文场景手动设一遍才踏实。
第六,模型待机被卸载。Ollama 空闲 5 分钟自动卸载模型,下次请求重新加载要等 30 到 60 秒。聊天场景无所谓,Telegram 或 Discord 的 Gateway 场景这就是灾难,把 keep_alive 设成 24h,服务器上用 systemd 配置持久化,重启也生效。
一份分层账,本地和云端怎么混
纯本地是不是终点。我的答案是不是。
本地模型在复杂多步推理上跟云端一线模型差距明显,超长上下文也是云端的主场。我在 Mac mini 上长期跑 Hermes,沉淀下来的是一套三层策略,用最低成本把场景全覆盖。
主力思考交给 GLM-5.1,走智谱的 Coding Plan,月度订阅额度五台机器共享,额度内边际成本为零。额度耗尽自动切 DeepSeek V4 Pro,按量计费,实测每百万输入 1.74 美元、输出 3.48 美元。视觉辅助固定 Gemini 2.5 Flash,免费额度大,更重要的是独立 Provider 不受主模型限流牵连。作为对照,同样的用量换 Claude Sonnet 每次会话约 0.8 美元,一个月下来 24 美元上下,三层策略基本压在 0 到 3 美元,九成场景等于免费。
本地硬件够的话,把主力换成 Ollama 里的 31B,再按优先级配一条 fallback 链,本地出错或超时就自动降级到云端,切换对用户透明。想要更省事,Nous Portal 这种统一订阅网关一次登录能覆盖三百多个云端模型,拿它当 fallback 池子正合适。这就是「日常免费、复杂付费」的混合模式。
密钥一律进 .env,其余配置全进 config.yaml,别混着放。
顺手交代一下 Hermes 的配置优先级,排障时用得上。命令行参数单次覆盖,优先级最高,config.yaml 管模型和工具这些非密钥设置,.env 放 API Key 和 Bot Token 这类密钥,内置默认值垫底。同一个配置两处都写了,以 config.yaml 为准。会话里可以用斜杠命令临时切换模型,但只影响当前会话,永久切换还是得改配置文件。
云端侧还有个低成本的过渡选项,NVIDIA 的 NIM 接口,四十 RPM 以内免费,不用绑信用卡,想在不花钱的前提下给 Agent 挂个云端备胎,先用它练手完全够。
收尾给一份交付前的最小清单。确认模型支持工具调用,确认上下文写进了 Modelfile 而不是只挂在运行时参数上,确认 toolsearch 已开启,确认视觉和压缩各有独立 Provider,确认超时和 keepalive 按你的场景调过。五项全绿,再谈上线。
本地化这件事,说到底不只是省钱。金融、医疗这些对数据出境有硬约束的行业,数据不出内网是合规前提,本地推理是刚需而不是偏好。老雷这两年的感受是,云端模型负责把体验的天花板撑高,本地模型负责把底线焊死,两条腿都硬,Agent 才敢进生产环境。