老雷AI实验室
口播稿自动生产线值不值得搭?一条 Make 工作流的账和坑
一个做财经口播的团队,手里攒着几十段播客音频、几百个参考视频、还有几万字的行业文稿。每条视频开工前,编辑还是得一个字一个字把口播稿敲出来,一个月下来,光写稿就吃掉大半个制作周期。素材越攒越多,稿子还是手搓的。
这不是个例。素材的形态越来越杂,文本、音频、视频各来一份,但产出端只要一样东西,能直接上提词器的口播稿。中间那道转化全靠人肉,是内容团队最隐蔽的一笔固定成本。
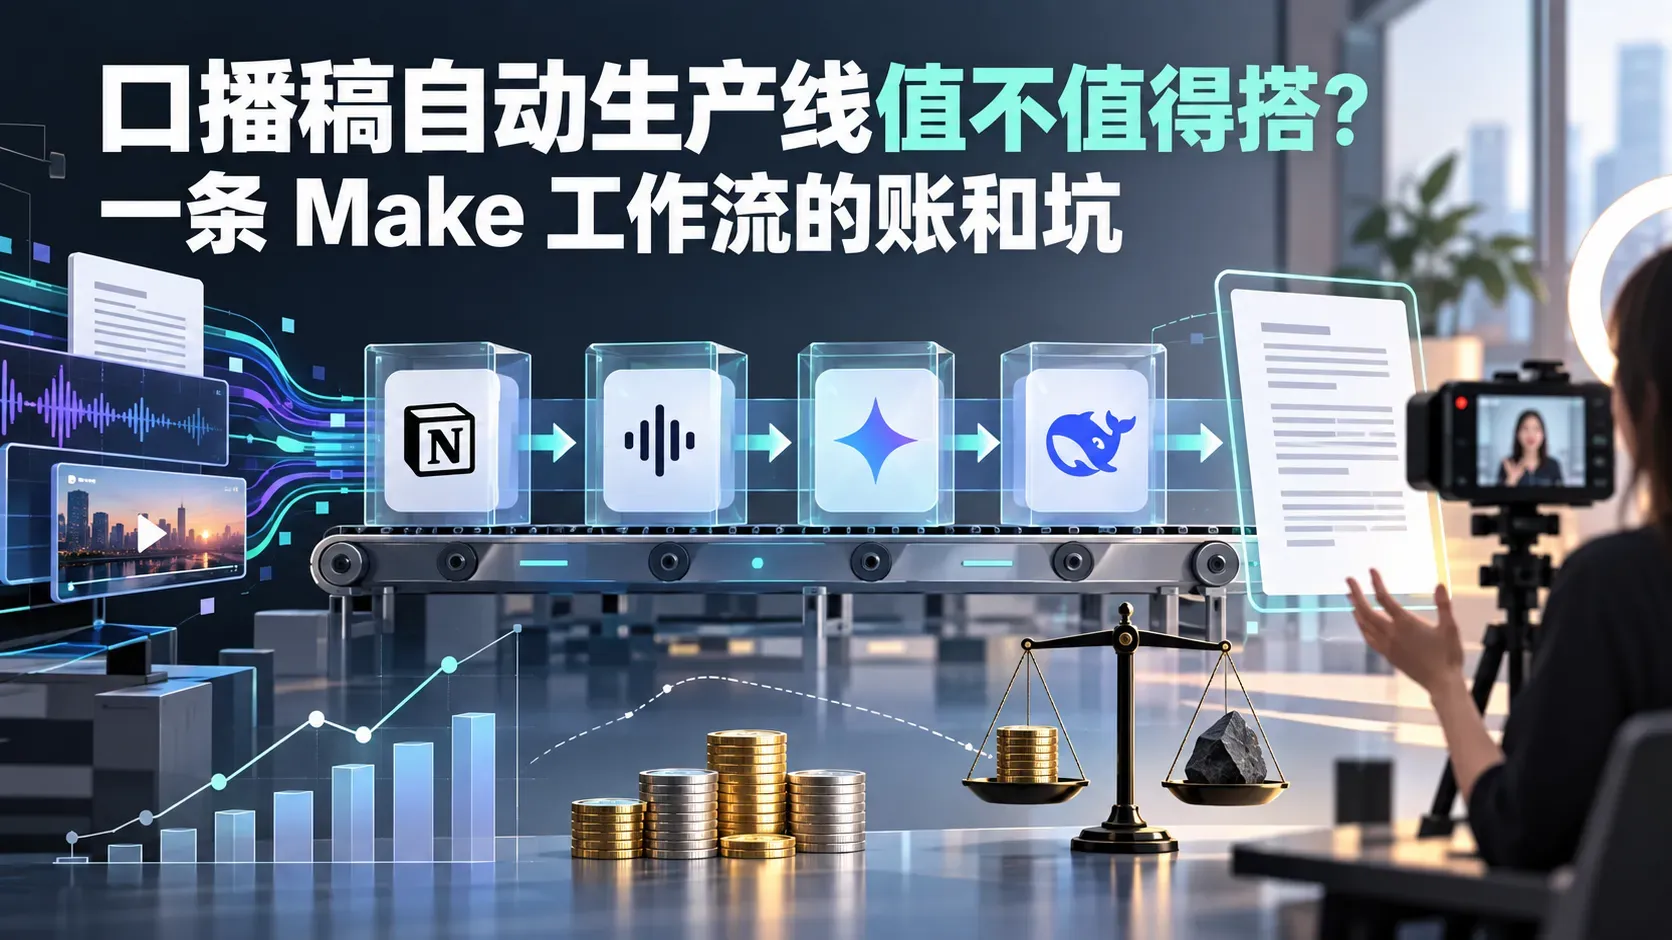
2025 年 2 月,老雷看到一个把这件事自动化掉的方案,值得拆开来给各位老板算笔账。它用 Make 搭了一条多模态生产线,在 Notion 里贴一条素材链接、把状态改成「开始」,文本、音频、视频三种形态的素材都能自动变成结构化口播稿,写完自动存回 Notion。实测里它跑通了财经音频、电影解说、书评转口播等好几种组合。
这篇不讲手把手搭建,只回答三个问题。这条线由什么组成,钱和质量怎么平衡,哪些坑别人已经替你踩过。看完你就能判断,自己的团队要不要上这套东西。
一条生产线,三个进料口
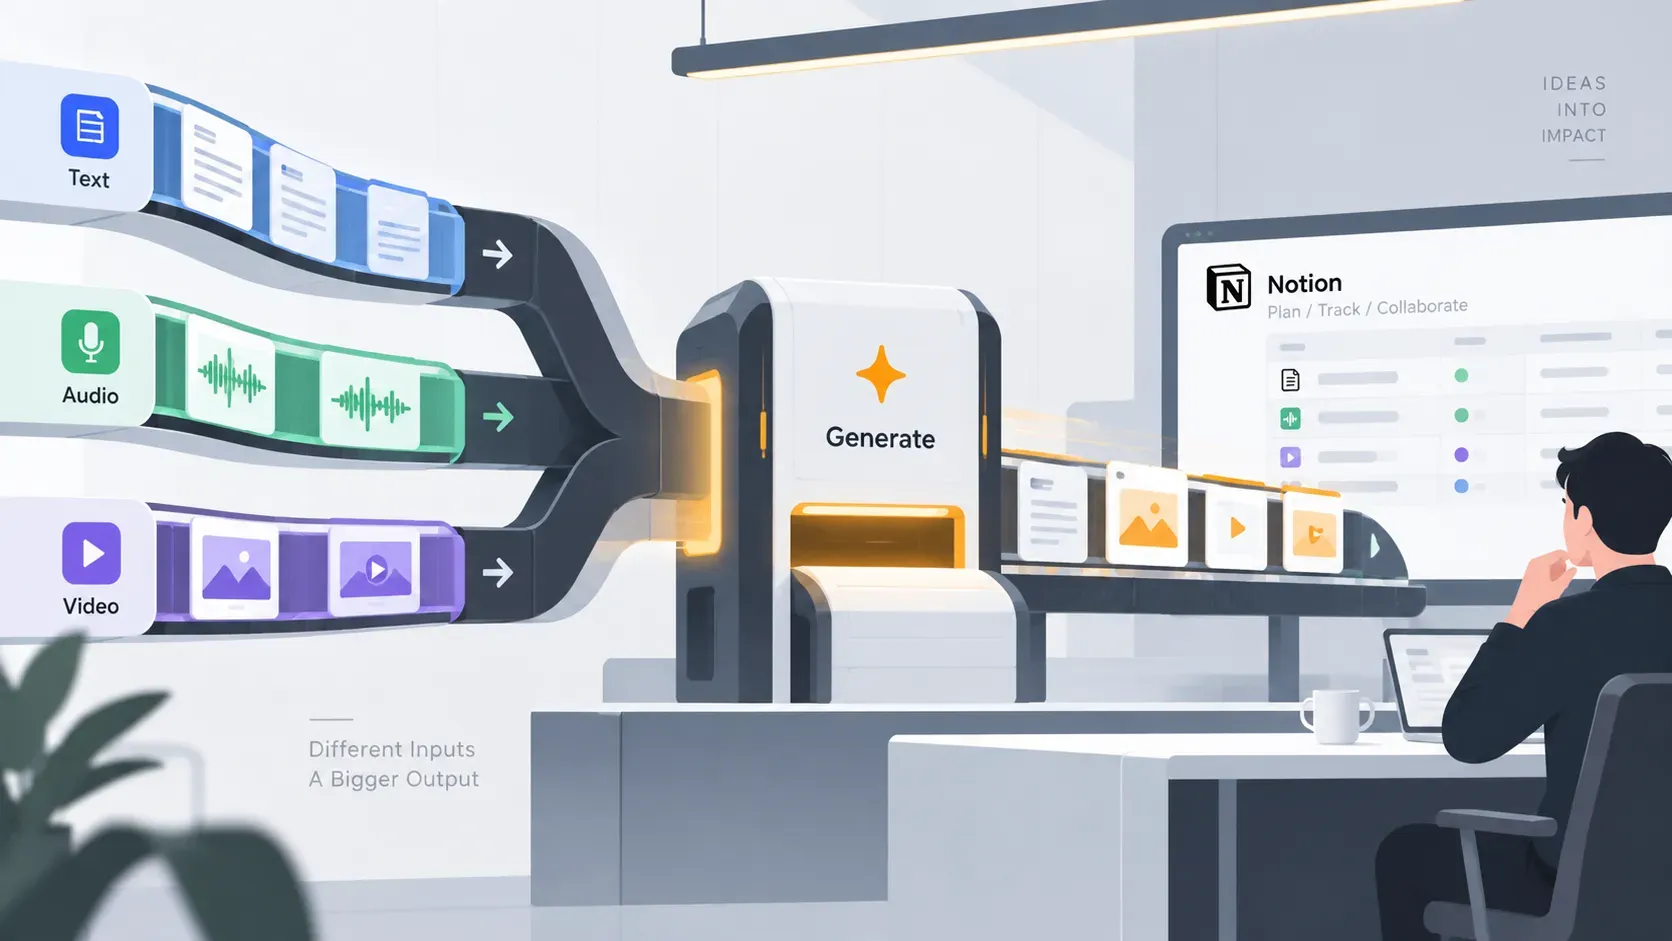
整条线的架构一句话能讲完,三条输入链路,一条生成链路。
操作端简单到不像话。Notion 数据库就是整条线的控制台,字段不复杂,素材链接、写作风格、段落字数、目标平台,再留一栏填额外需求。团队里任何人在库里贴一个素材链接或一段文本,选好风格和字数,状态改成「开始」,剩下的机器全包。想模仿谁的口吻,就在风格字段里写谁,想要口语重一点还是干货密一点,额外需求里写一句就行。
这个设计对管理者很友好。你不用教每个人用自动化工具,他们面对的就是一张熟悉的表格,门槛低到实习生第一天就能上手派活。
三个进料口各管一种形态。文本素材直接读进来,聚合成完整长文。音频走 Replicate 平台的转录模型,几十分钟的长音频也能转成中文文字稿,按使用付费,不用不花钱。视频这条最有意思,先下载文件,传给 Gemini 2.0 Flash 做多模态分析,模型按时间轴把整个视频解说一遍,直接吐出一份带段落划分、去掉了插播广告的解读文稿。
三条链路的产出统一汇进一个变量,生成链路从那里取料。输入和产出就此解耦,以后想加第四种素材形态,加一条进料口就行,生成端一个字不用动。
素材从哪来,也是个流程问题。视频平台的素材用下载工具转成 MP3 或 MP4,传到一个能出直链的网盘,把直链贴进 Notion 就算进料完成。老雷的建议是把这一步写进团队的内容运营手册,谁来下载、传到哪个盘、链接贴哪一栏,固定下来,流水线才不会三天两头断料。
老雷见过不少自动化项目死在「一步到位」上,什么都想吃,结果什么都接不稳。这个方案的结构给了一个更稳的思路,先把输入和产出分开,每条链路都是可以单独换的零件。
写稿这一环,选 DeepSeek R1 的账
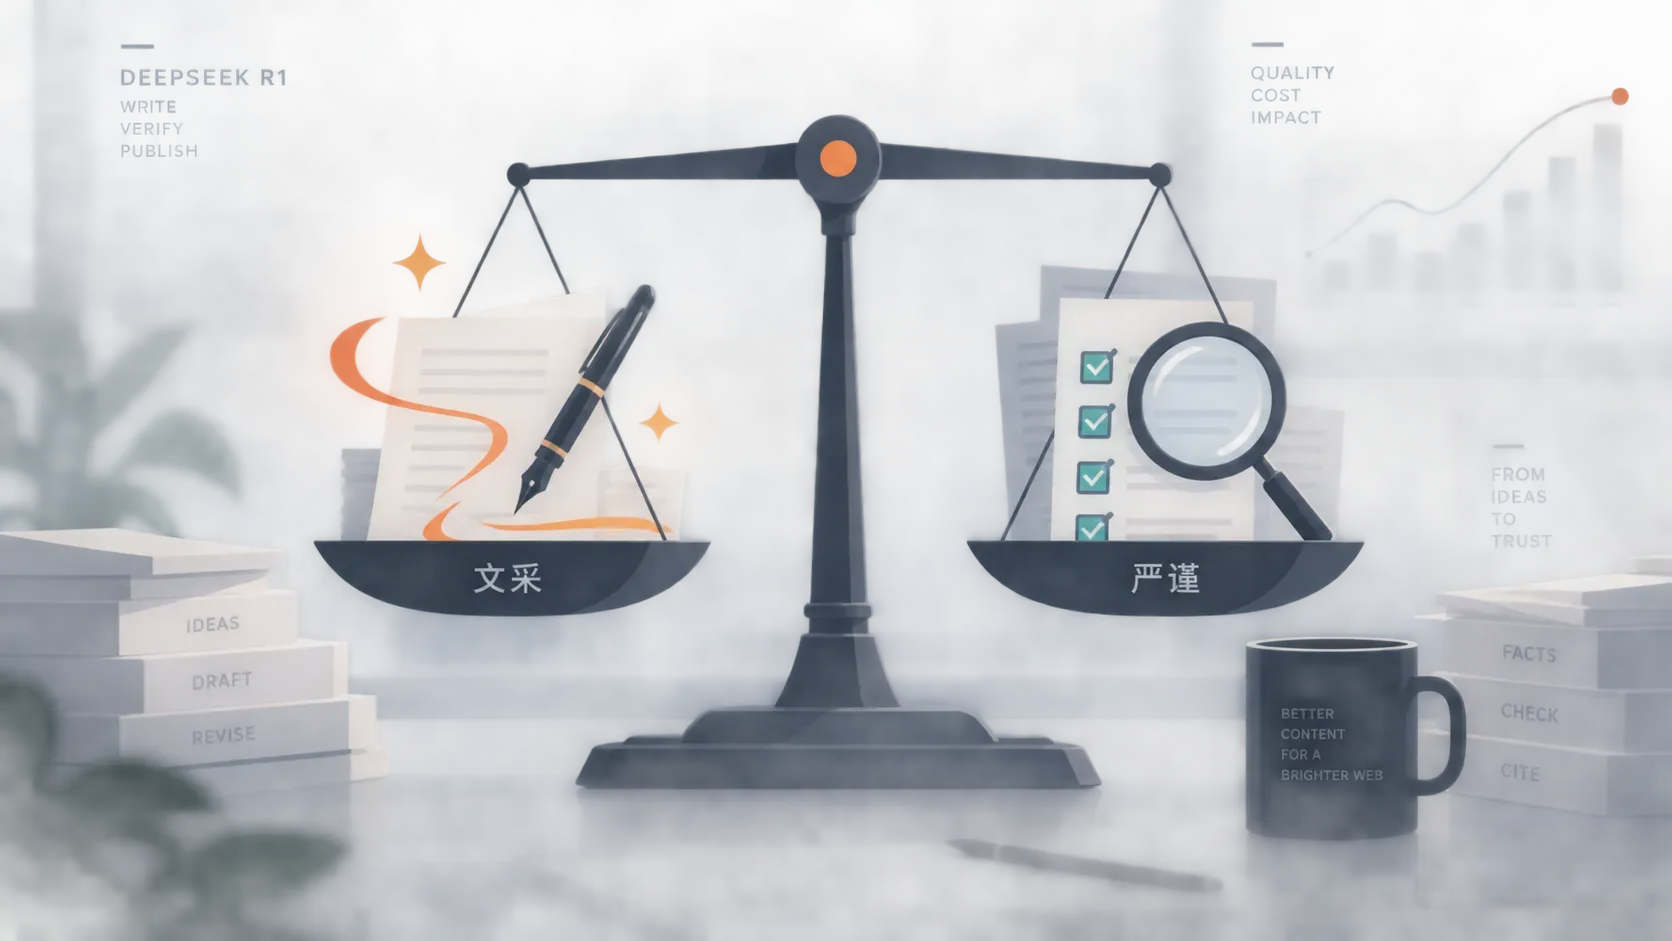
生成环节用的是火山引擎的 DeepSeek R1。图的是它的风格化写作能力,实测里让它模仿「小林说财经」的口吻讲周期理论,它能把「回升、繁荣、衰退、萧条」四个阶段翻译成「春种、夏长、秋收、冬藏」。这种带着泥土味的本土表达,恰恰是口播稿能不能立住的关键,直译式的书面语观众根本听不下去。
但这里有一笔质量账要算。R1 为了表达效果会自行加料,写出原文里没有的细节,这是风格化写作躲不开的代价。两条路,要么生成后加一道人工审校,把事实类内容核对一遍,要么把这一环换成 GPT-4o,风格弱一点但信息更准。选哪条,取决于你的内容离事实有多近。财经、医疗、法律这类内容,审校环节不能省,出了事实错误的账号,掉的不是一两个粉。
长稿子还有一道衔接题。大模型单次输出长度有限,几千字的稿子要切段生成,段与段怎么接住前文,方案里给了两种存法。
覆盖存储,每次只记最新一段,省 Token,代价是全文连贯性一般。完整存储,每次把开头到当前的全部内容喂给模型,连贯性明显更好,Token 消耗也水涨船高。几千字的素材,实测完整存储的效果好出一截,多花的钱买的是听众耳朵里听不出来的顺畅,这笔钱该花。
输入比输出长,模型做压缩提炼,稳。输入比输出短,模型做信息扩充,容易出戏。
段落字数这个参数别拍脑袋。万字以上的素材设 800 到 1000,让模型压缩提炼,信息密度反而更高。素材本身只有几百字,就压到 500 以下,不然模型为了凑字数开始瞎编。实测里 R1 每段输出稳定在 400 到 500 字,按一分钟口播稿 280 到 300 字的常规语速换算,1500 字正好对应一条五分钟视频,够支撑日更或隔日更的排期。
五个坑,都是别人替你踩过的
第一,Notion 里存素材链接用文本属性,别用链接属性,格式校验会给你报一堆莫名其妙的错。
第二,音频和视频都要直链。判断标准很简单,链接贴进浏览器地址栏能直接开始下载的就是直链,网盘分享页那种一律不行。
第三,转录和视频分析都是异步处理,等待时间给足,200 秒以上比较稳。等待不够,工作流会在半路拿到空结果,这种错最耽误排查时间,而且报错信息完全不告诉你原因。
第四,火山引擎的 DeepSeek R1 接入时填的是接入点名称,不是模型名称,填错了连不上。
第五,第一段和后续段落要用两套提示词。第一段直接写,从第二段开始要把前文结尾喂进去,要求承上启下。这个细节决定一篇稿子读起来是完整的文章,还是生拼硬凑的段落,我见过衔接没处理好的稿子,念到第三段就听出来是机器写的。
真正值钱的不是省下的稿费
实测跑通的组合里有两个让我印象很深。一个是把电影解说视频直接喂进去,Gemini 看完画面,生成了《落叶归根》的解说口播稿,全程没人动笔。另一个是豆瓣书评转成知识分享口播,连排版带分段一次到位。严肃的经济理论文稿,也能被改写成抖音味十足的通俗讲法,原文的框架没丢,表达换了一层皮。
这些组合以前不是做不出来,是没人有这个人力。一个编辑把一小时的视频整理成文稿,再改写成口播稿,大半天就没了,现在这道工序被压到了一杯咖啡的等待时间。
但这套东西真正的价值不在省稿费。文本、音频、视频三种形态两两连线,每条线都是一个现成的赛道。音乐变 MV,书籍变口播,知乎回答变配图短视频,外文资料变中文内容,财经播报的文稿变成带表情、有肢体语言的出镜讲解。素材仓库里躺着吃灰的东西,换个模态就是新账号的选题库。
成本结构上这条线也干净。转录按使用付费,不用不花钱;视频分析和文案生成都是调用式的变量成本,跑一单算一单;固定支出只有 Make 的订阅和 Notion 这种本来就有的工具。对一个内容团队来说,这种花销结构比养一个专职写手轻得多,试错成本也低,跑一个月不喜欢,关掉就行,没有沉没负担。
模态之间的每一条连线,都是一条别人还没挤进去的路。
回到最开始那个问题,要不要上这条线,老雷的判断标准就三条。素材形态是不是至少两种,口播稿是不是周更以上的稳定需求,有没有人能接住最后一步的审校。三条全中,这条线的回本速度会超预期。只中一条,先花一周把素材库和链接规范整理好,再谈自动化也不迟。
工具本身会一直换,Gemini 和 R1 明年多半有更强的继任者,但「多形态素材进、标准化成品出」这条生产逻辑不会过时。早一点把素材流和数据流理顺的团队,等更强的模型出来,换一个零件就能整体再提一档。