老雷AI实验室
RSS 只会通知不给全文,Jina Reader 把网页变成干净纯文本
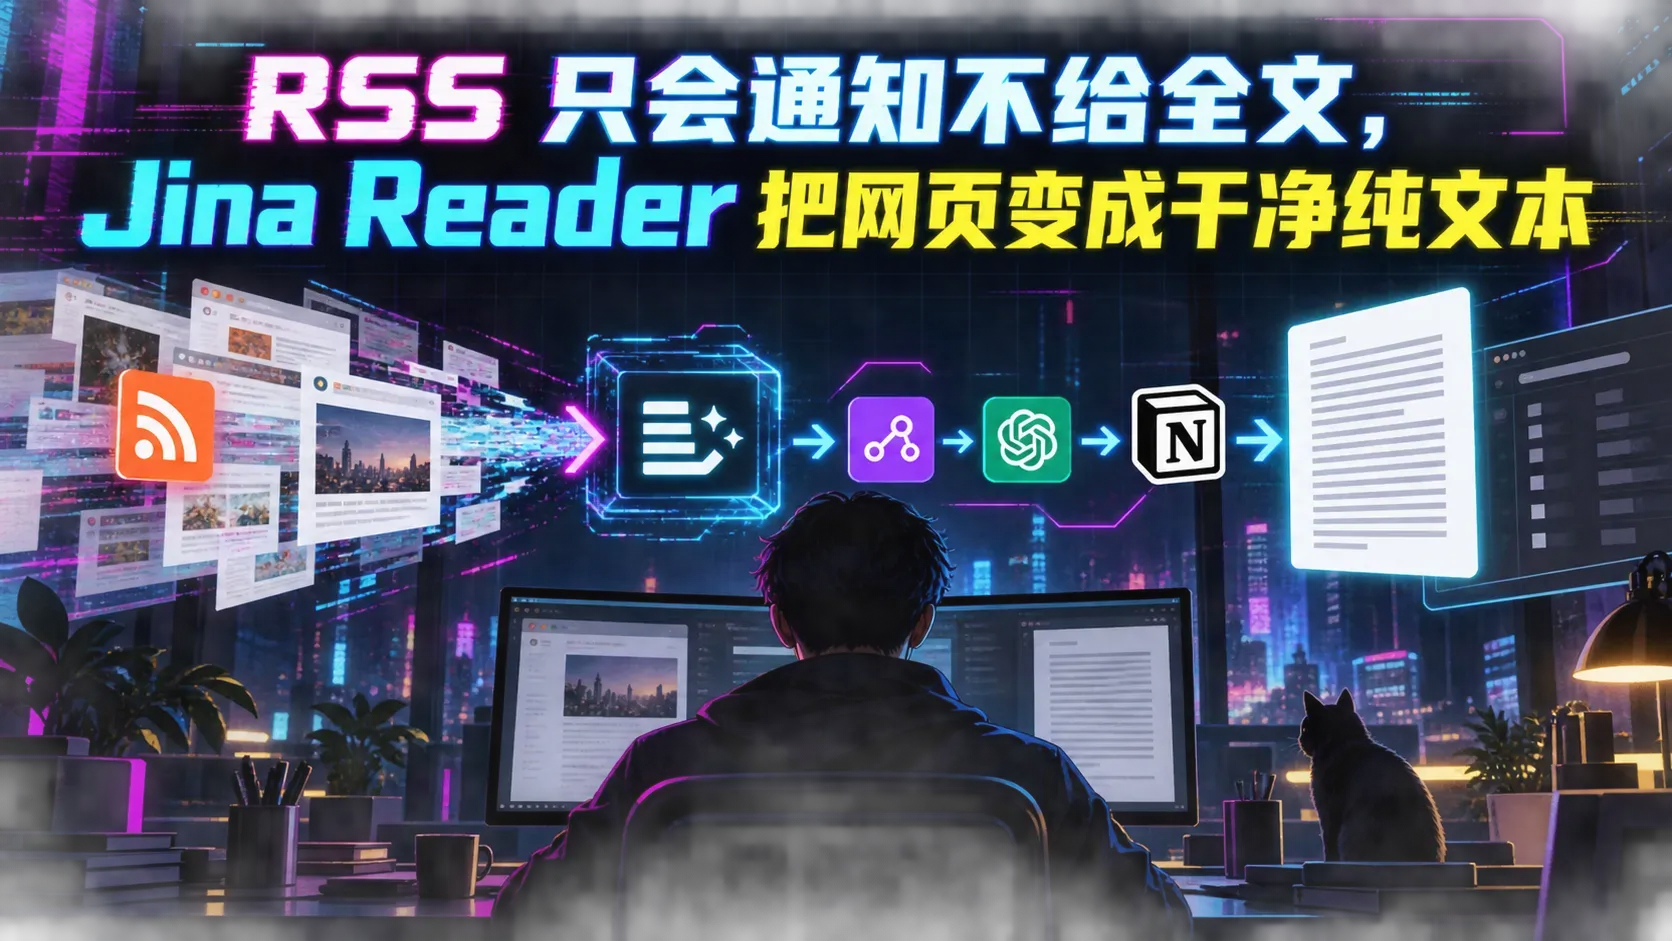
用 RSS 追信息的人都会撞上同一堵墙。订阅源很勤快,网站一发新文章它就通知你,可点开一看,只有标题和一段摘要,正文没有。想把内容完整收进知识库,还是得自己开浏览器、进网站、复制全文,一套动作回到手工时代。
一两条还好,要是盯的是一个高频更新的信源,比如一家 AI 公司的官网新闻页,一天几条,天天手动搬,用不了两周人就崩了。追踪特定网站更新的研究者、做资讯简报的运营、靠信息差吃饭的内容团队,多多少少都受过这个罪。
这篇讲怎么把这堵墙拆了。用 Make 加一个 Jina Reader 的 HTTP 调用,任何网页链接都能变成干净的纯文本,HTML 标签和无用符号全部剥掉,再交给 ChatGPT 整理成中文快报,连同全文一起存进 Notion。我拿 OpenAI 官网的新闻页当例子,把整条流水线从零到一搭给你看。
先把根上的问题讲清
RSS 这个协议天生只负责通知,正文给不给、给多少,全看网站心情。多数网站的源只吐标题加摘要,个别连摘要都省。以前想拿全文,得写爬虫,解析 HTML,对付各种反爬,工程量不小。
Jina Reader 把这件事变成了拼 URL 的活。 在任何链接前面拼上 r.jina.ai,它就返回这个网页的纯文本,标签、导航、广告这些杂质全被剥掉。对要喂给大模型的内容来说这个特性特别值,HTML 里一堆标签符号塞给模型纯烧 token,换成纯文本进去,每一分 token 都花在内容上。
而且它是标准的 HTTP 请求,任何能发请求的工具都能接,放进 Make 里就是一个 HTTP 模块的事,零代码。自己写爬虫的话,页面一改版选择器就失效,隔三差五得回去修,这种隐性维护成本在交付项目里最伤,能用稳定服务解决的绝不上手搓。
RSS 解决的是有新东西了,Jina Reader 解决的是新东西到底是什么。
还得说一句适用面。别被新闻页这个例子框住,任何需要抓网页内容的场景它都顶得上,监控竞品官网的更新、追踪监管部门的公告、盯某个作者的主页,道理一模一样,换掉入口链接就行。
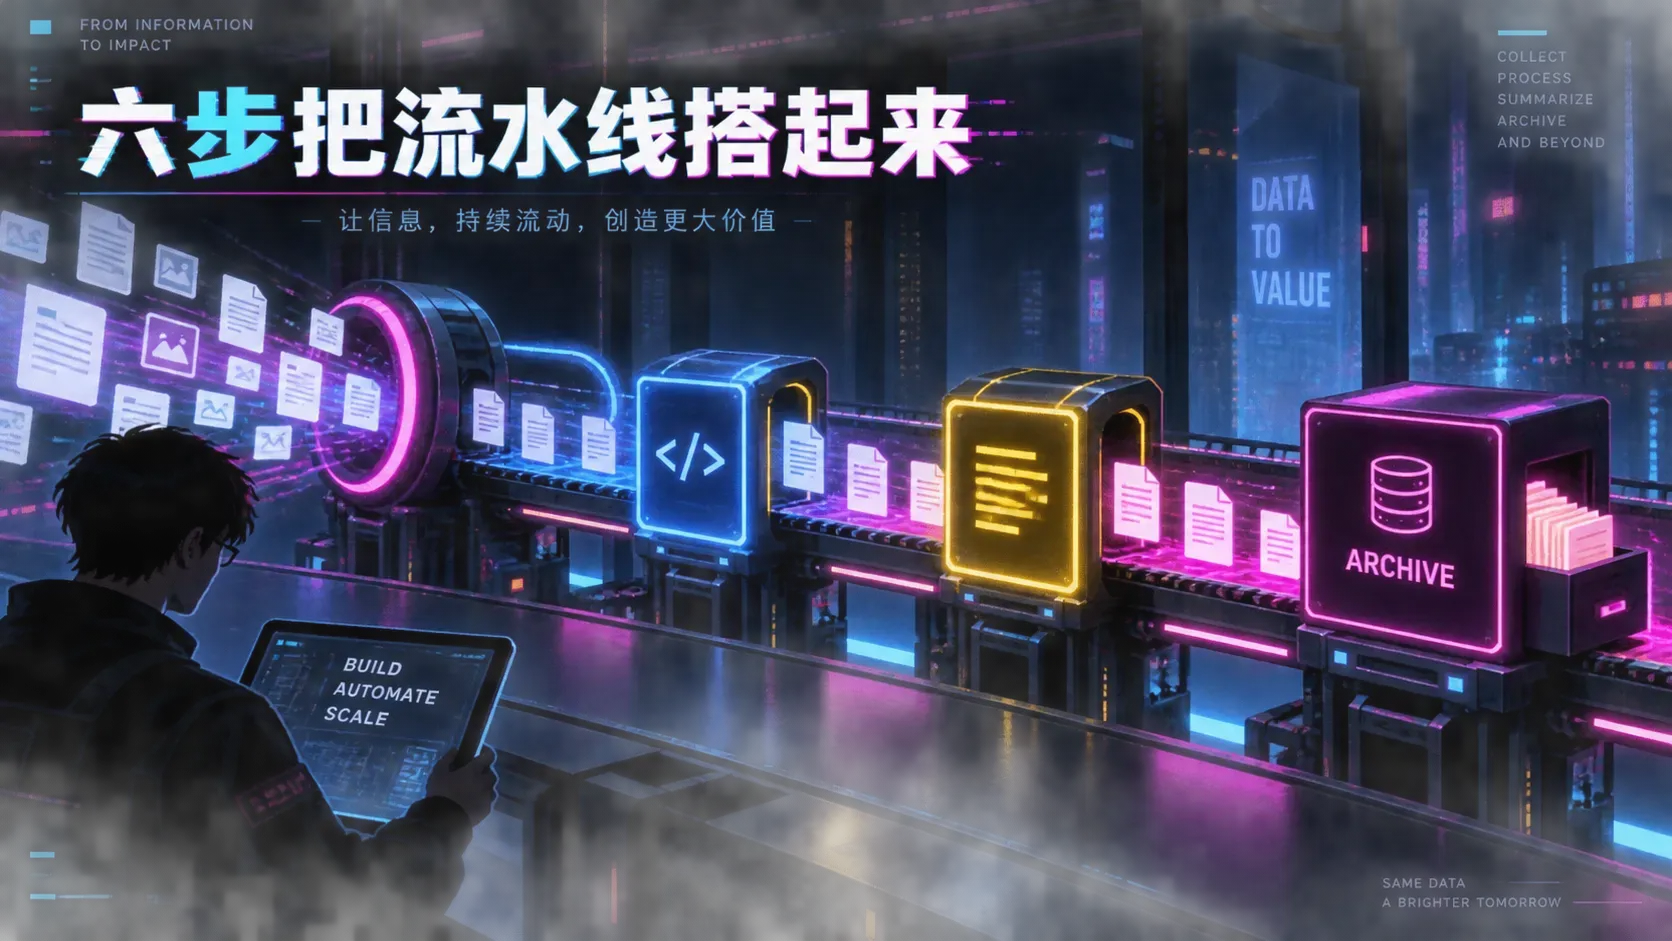
六步把流水线搭起来
第一步,建 Notion 新闻库。新建表格命名 OpenAI 新闻库,属性六个,标题存翻译后的中文标题,新闻内容存 ChatGPT 生成的快报,发布时间和更新时间两个日期字段,封面用 Files & Media 类型存新闻配图,链接存原文 URL。库设计就一个原则,快报和全文分开放,快报放属性字段方便列表页直接扫,全文放页面正文方便点进去细读,两层各有各的用处。日期字段记得存原文的发布时间,条目自己的创建时间是入库时间,两个时间将来要做时间线分析时完全是两回事。
第二步,把目标页面变成 RSS。OpenAI 的新闻页是一个列表,每张缩略图对应一篇新闻,这种结构和 RSS 很像,用 RSS.app 粘贴页面地址就能生成订阅源。操作是拿 Google 账号登录,点新建,粘贴页面 URL,生成之后复制它给你的 RSS 地址。RSS.app 是付费服务,不到 10 美元一个月,预算有限就搜 URL to RSS,免费替代工具不少,只要输出标准 RSS 格式都能接进后面的流程。
第三步,Make 里建场景,命名 OpenAI 新闻采集,加 RSS 模块选 Watch RSS Feed Items,粘贴生成的订阅地址,数量设 5。跑一次看输出,标题、摘要、网址、发布时间都在,缺的就是全文,缺的这一块正是下一步要补的。顺带确认一下这个源吐出来的摘要质量,有的源摘要有斜杠和换行这种杂质,不影响后面走 Jina,但心里有数总没错。
第四步,加 HTTP 模块选 Make a Request。URL 一栏填 https://r.jina.ai/ 然后拼上 RSS 模块输出的链接字段,动态拼接,每条新闻自动换成自己的地址。Headers 配两条,Authorization 填 Bearer 加你的 Jina API Key,X-No-Cache 填 true,每次绕过缓存拿最新内容。Content Type 选 Raw,其他保持默认。跑一次这个模块,5 条 RSS 数据会各自走一遍 Jina Reader,打开 Output 里的 Data,能看到整页新闻的纯文本,干净得像手动整理过一样。
第五步,加 OpenAI 模块,模型用 GPT-3.5,够用且省 token。提示词让它扮演资深新闻编辑,把发来的新闻整理成 500 字以内的中文快报,要求简洁明了、客观介绍、抓住关键点、给读者能带走的观点,并按固定 JSON 格式同时输出翻译好的中文标题和快报全文,输出完不带任何多余符号。提示词里留两个占位符,分别替换成 RSS 的 Title 和 HTTP 模块返回的 Content,标题让模型翻成中文,内容让它压缩成快报,一次调用两件事全办了。
第六步,存进 Notion。Create a Database Item 搜出新闻库,字段映射五条,标题接 JSON 里的中文标题,封面接图片地址,发布时间接 RSS 的时间,新闻内容接快报,链接接原文网址。再拖一个 Append Page Content 模块,条目 ID 用上一个模块刚创建的那条,Paragraph 里放 Jina Reader 返回的全文。这样每条记录既有 500 字快报可以速览,又留着完整原文备查。
跑完整条链,回到 Notion 切成画廊视图,中文标题、500 字快报、封面图、原文链接、完整正文,一条新闻五样俱全,封面配快报,一屏新闻尽收眼底。
交付前怎么验收
三条标准。第一条,任意挑两条库里最新的记录,快报字数在 500 字以内、观点站得住,说明提示词没跑偏。第二条,点开记录里的原文链接,和 Jina 采回来的全文对一遍,主要段落都在,说明抓取没缺肉。第三条,封面图正常显示,画廊视图刷下来没有空封面。三条全过,这条流水线才算能交出去。
验收之外再交代一句部署节奏。上线头两周建议每周回看一次库里新增的记录,重点看两样,快报质量有没有漂移、目标页面改版有没有影响抓取。跑满一个月没出幺蛾子,再把它当基础设施信任。
三个省 token 和防抽风的小窍门
测试期别整条链反复跑,5 条数据每条都过一遍 ChatGPT,token 哗哗地烧。右键单个模块选 Run this module only,一次只处理一条,提示词验证过了再放整条链跑。这个习惯能帮你在调试期省下一大半 API 开销,模块级的单点验证永远比整链重跑便宜。
Notion 模块偶尔会抽风,字段映射不上或者搜不到库。老雷踩过几次之后摸出规律,把弹窗关掉重新打开,让它刷新一次数据,十有八九就好了,真不用急着改配置。
Jina Reader 在它官网上配置时留意四个参数。模式选读取,不要选搜索,要的是这个网页的文本,不是全网的搜索结果。API Key 免费申请一个,带上能提高使用效率。图片选 URL 格式返回,图片以链接形式输出,不占正文文本长度。缓存关掉,配合请求头里的 X-No-Cache 双保险,采到的永远是最新版页面。
调试期省的是 token,上线后省的是命,单点试跑这个习惯值回票价。
三条使用边界
一,RSS.app 要钱,但这一层完全可替换。免费工具、读网站 Sitemap 拿全部页面链接,都是路子,选顺手的就行,后面的流水线一个字都不用改。判定标准就一条,输出的东西是不是标准 RSS 格式,是就能接。
二,Notion 的授权和其他第三方服务一样有时效,隔一阵子连接会失效,流水线莫名报错时先查这条,回 Make 重新建一次 Notion 连接、重新授权就好。排查顺序建议先查授权再查模块,十次里八次是授权过期。
三,Jina Reader 有免费额度,个人场景通常够用。可它毕竟跑在别人的服务器上,要拿去做重依赖的生产级采集,先掂量自己的量级,量上来了再考虑自建抓取方案。给客户交付前把话说清楚,免费额度的边界在哪,超了之后走哪条路,别等额度烧完了再补课。
回到开头那堵墙。RSS 负责告诉你有新东西,Jina Reader 负责把东西完整搬回来,ChatGPT 负责嚼碎了讲给你听,Notion 负责收好。四个角色各干各的活,一条链就通了,从人肉搬运到自动落库,中间差的从来不是技术,是有人把这几个零件按顺序插到一起。
老雷的建议是拿这套架构当积木用,今天采集 OpenAI 的新闻,明天换个链接就是追踪任何一家公司的动态页,后五个模块原封不动。动手顺序也简单,先花十分钟把 Notion 库建好,再拿一条现成的 RSS 源把中间四步串起来验收,目标页面转 RSS 这一环留到收尾折腾。把任意网页变成干净全文这个能力,值得进每个交付工程师的工具箱。