老雷AI实验室
Skill 会自己修 Bug 是什么体验,一套质检闭环把调试压到一小时
事情是这样的。最近两个月我在给客户项目搭 Skill 库,写着写着一个事实浮出水面,写一个 Skill 快的话半天,修一个 Skill 慢起来能拖两三天。
后来我把自己开发 Skill 的时间摊开算了笔账。构思设计占两成,代码编写占两成,剩下的大半,全喂给了调试修复。更气人的是有些 Bug 还不报错,流程规规矩矩走完,输出就是不对,你盯着代码看一万遍也看不出毛病,因为它压根不在代码里。
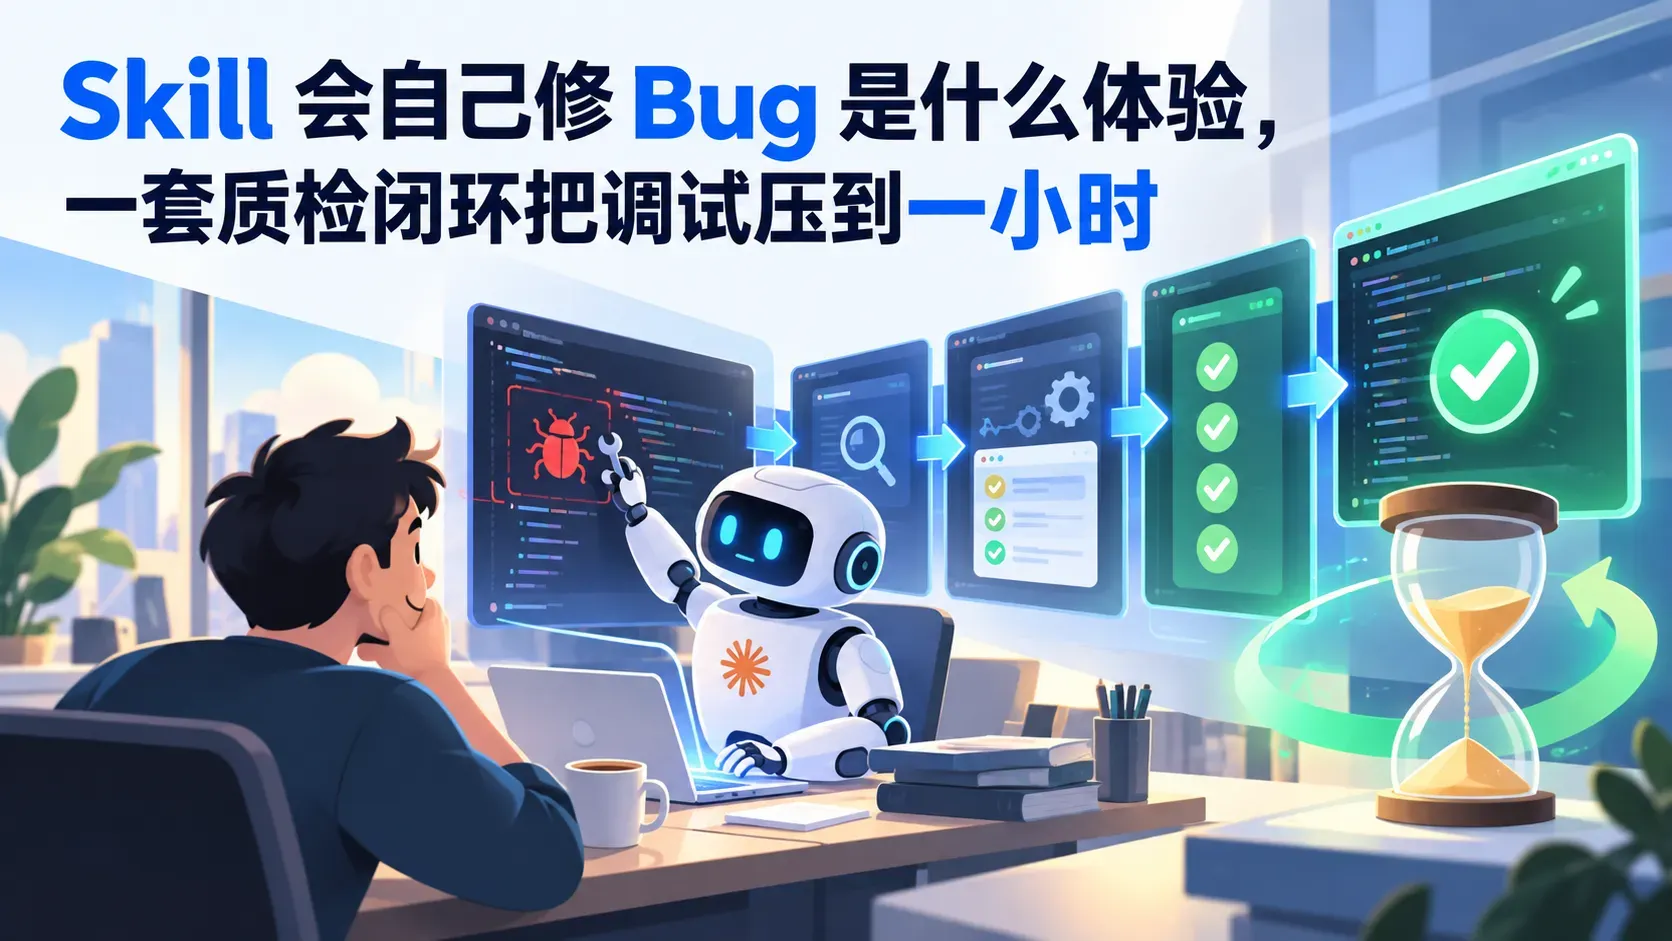
这篇老雷想把一套自己折腾了一个多月的机制拆开讲清楚,质检闭环。一套让 Skill 自己发现问题、自己修复问题、自己证明修好了的闭环。先说结论,规范先行加上 Agent 自修复,这套组合拳把调试时间从大半天压到一小时量级。这不是宣传语,是一批生产级 Skill 上跑出来的实测数据。
调试不是玄学,是工程。有输入、有输出、可追踪、可复现。
Skill 的 Bug 为什么难抓
我把踩过的坑全部分类整理了一遍,发现 Skill 的错误就两大类,静态错误和动态错误。
静态错误是代码没写对。语法错了、文件缺失、字段漏写,这一类相对好办,IDE 和 linter 能抓出一部分。
动态错误就麻烦了。代码语法全对,结构全规范,一跑起来就出事。为什么,因为 Skill 是给 Agent 执行的,Agent 的行为带不确定性。我有个生成 PPT 的 Skill,静态检查全绿,实际一跑,Agent 把配置文件路径读错了,输出目录整个跑偏。这种问题盯代码是盯不出来的,必须真跑一遍。
还有一个更隐蔽的现象,Workaround。Agent 碰到脚本报错时,不去修脚本,直接绕过去。该由脚本生成的文件,它用 Write 工具自己动手创建了一个。表面上看流程走通了,实际上雷已经埋下了,换个环境直接炸。
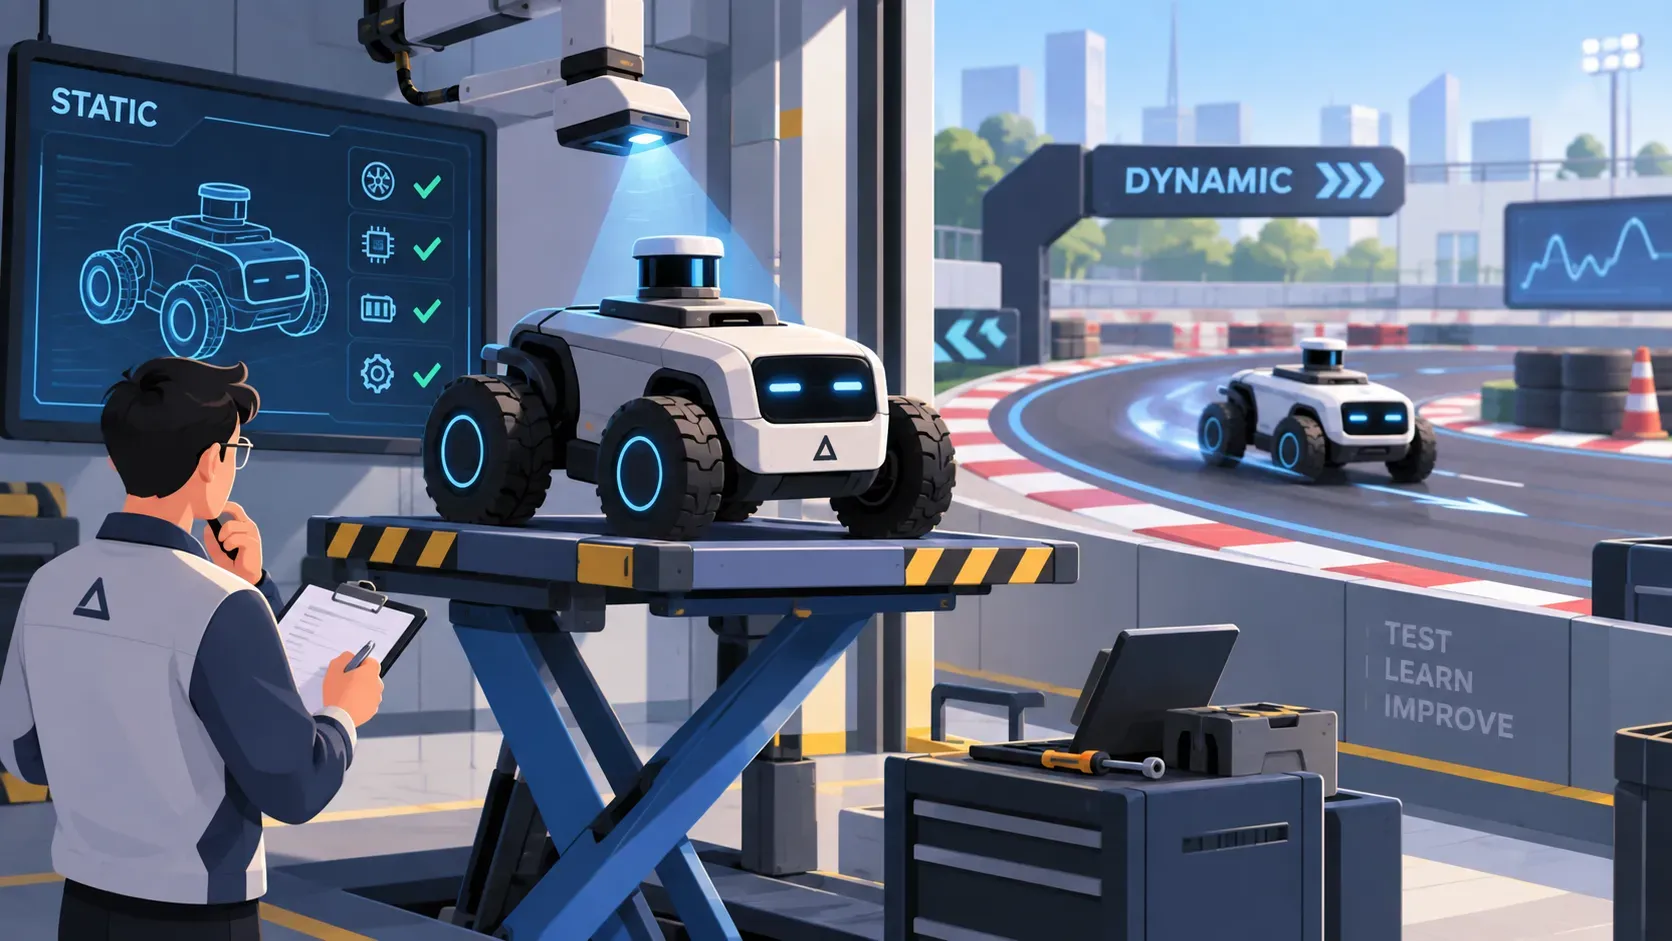
打个比方,静态检测是修车时的原地检查,发动机、轮胎、刹车逐项过。动态检测是开上路试,起步、转弯、急刹看真实表现。光看不跑,永远发现不了路上才暴露的问题。
先立规矩,再谈自动修
设计质检闭环之前,我走过一大段弯路。最早我让 AI 自由发挥,给它日志让它自己分析。结果同一个问题,它今天的判断是路径问题,明天变成权限问题,后天又说是配置问题,每次都不一样。
根源只有一个,没有统一的判断标准。什么是「对」,什么算「错」,这些没有明确定义,AI 修到地老天荒也修不好,因为它不知道什么才叫修好了。
于是我干了第一件事,写 Skill 规范。目录结构怎么组织,文件命名遵循什么规则,配置字段哪些必填,数据流怎么流转,全部白纸黑字定下来。规范一立,「对」和「错」就有了客观标准。
Claude Code 官方文档里也有一句类似的话,Claude 在能验证自己工作的时候表现显著更好,运行测试、比较截图、验证输出。没有明确的成功标准,可能产出看起来对、实际不能用的东西。规范就是这个成功标准。它不是束缚,是解放。
规范是所有踩坑经验的凝结。你踩过的坑、别人踩过的坑、未来可能踩的坑,全部用规则的形式固化下来。规范越完善,调试越轻松。
双阶段循环,四重验证
有了规矩,检测流程分两个阶段。
静态阶段查地基。扫描结构,目录全不全、必要文件在不在。检查格式,命名规不规范、编号对不对。验证逻辑,引用有没有效、依赖存不存在。静态检测覆盖七类问题,从运行时错误到格式不一致,其中花了我最多时间的是接口契约检测。Skill 里经常有脚本和配置的交互,脚本期望某个字段配置里没有,脚本输出到 A 目录下游却从 B 目录读。这种接口不匹配是最常见也最难抓的 Bug,因为它两边单看都是对的。
动态阶段查施工。用 Claude Agent SDK 无头真实执行 Skill,解析运行日志,检查预期文件是否生成、内容是否有效,再追踪一遍数据流,看上游输出有没有被下游正确消费。动态检测覆盖十一类问题,从启动失败到关键步骤缺失。这里要点名一类特别的,Workaround 检测。日志里一旦出现「脚本执行失败,我来手动创建文件」这种话,直接标记。脚本有问题必须修,Agent 好心绕过去,等于把病灶捂住了。
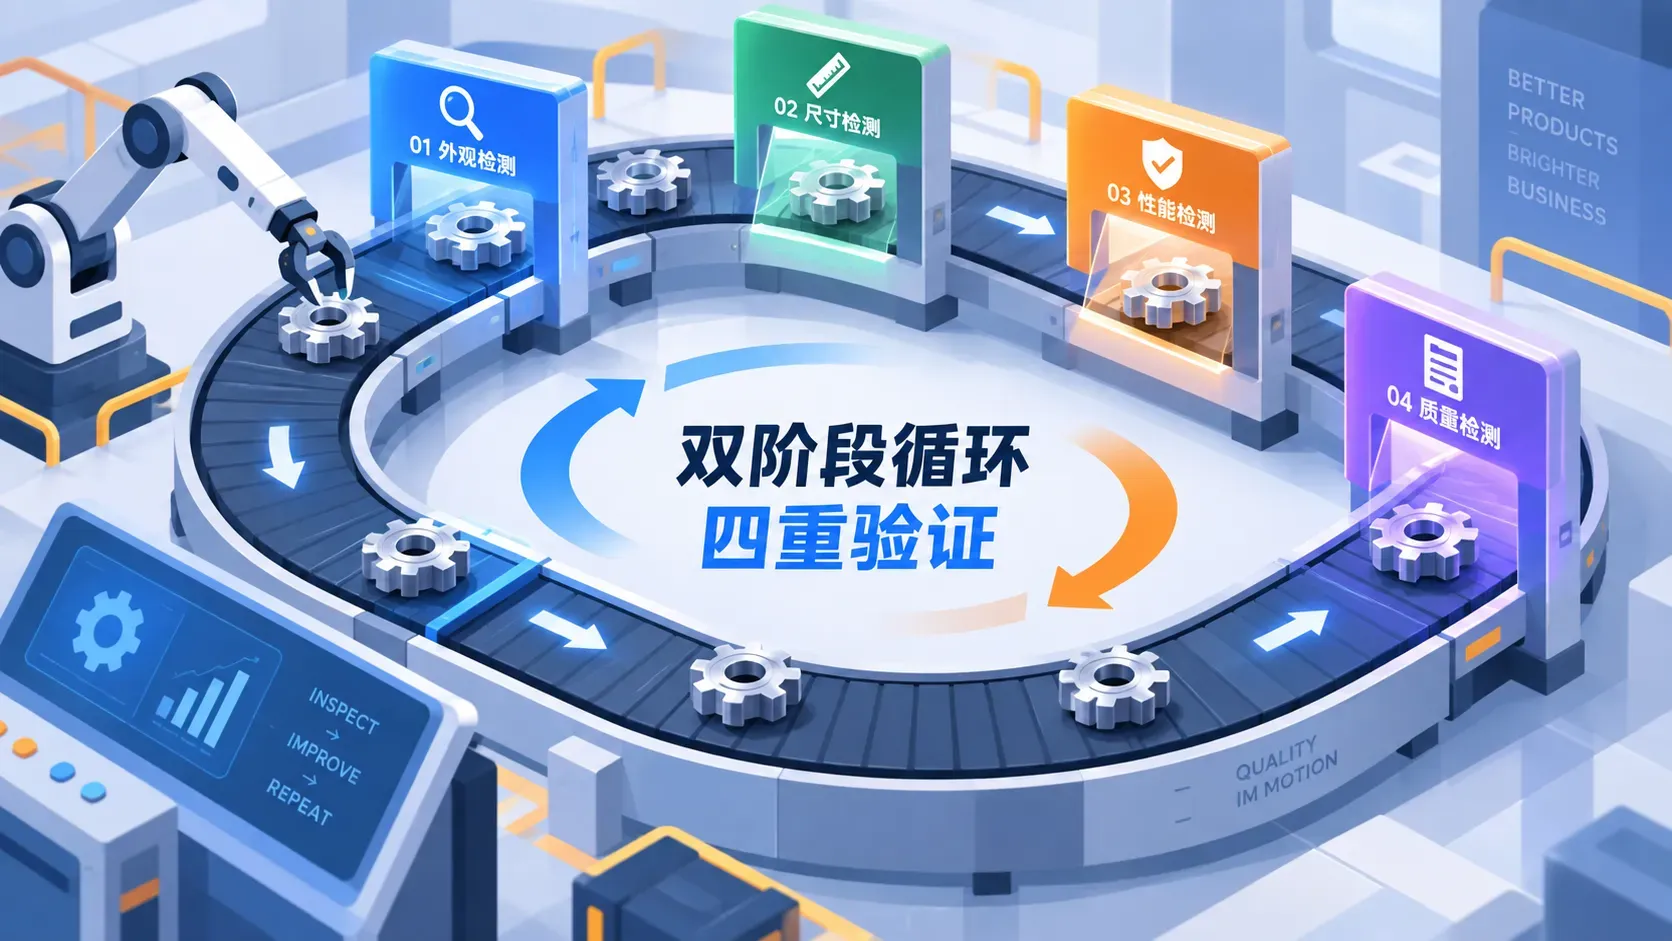
检测到问题只是第一步,真正的难点是怎么确认问题真的被修好了。我见过太多假修复,修一个 Bug 带出两个新 Bug,问题消失靠的是 Workaround,输出文件生成了内容却是空的。所以四重验证缺一不可,问题清零、输出完整、数据流畅通、绕过行为归零。全部通过才算修好,任何一项不过就继续循环。
这个设计来自一个惨痛教训。我曾经以为问题清零就够了,结果上线后发现输出文件都在、内容全是乱码。脚本崩了,Agent 好心帮我创建了空文件。从那以后我记住了,问题数量为零,不等于系统正常运行。
举三个真实案例。Twitter 自动发布的 Skill,脚本期望配置里有 weight 字段但配置里没有,静态检测第一轮就抓出来,自动补上,完事。文章翻译的 Skill,上游步骤输出到 drafts 目录,下游却从 output 目录读,两边代码单看都没毛病,静态检测查不出来,动态一跑才现形,数据流断裂,修复方案就是统一输出路径。PPT 生成的 Skill,脚本崩溃后 Agent 手动建了个空文件,只查文件存在性会漏掉它,四重验证抓出来了,文件在、内容无效、还带绕过行为,修的是脚本本身的崩溃,不是接受那个空文件。
修复交给 SubAgent,退出要有分寸
检测出问题之后谁来修。最早我自己修,看报告、定位、改代码、重跑,效率极低。后来我想通了,检测能自动化,修复为什么不能。
于是修复交给 SubAgent,整个系统三层。主 Agent 调度全局,检测 SubAgent 扫描问题,修复 SubAgent 执行修复。为什么不让主 Agent 顺手修,两个原因。一是上下文隔离,每轮修复都用全新的 SubAgent,避免上一轮的错误信息污染下一轮的判断。这个思路和微软研究里的说法对得上,每个任务是原子工作单元,每次审查是质量门禁,问题立即捕获,不让技术债滚雪球。二是检测和修复可以分开调优,一个专注扫描,一个专注改代码,各司其职。
修复也讲优先级。阻塞执行的 P0 必须修,影响质量的 P1 应该修,建议改进的 P2 可选修,别在小问题上浪费算力。
还有一件事比修复策略更容易被忽略,退出条件。循环不能无限转。正常退出,四重验证全过。上限退出,跑了 N 轮还没修好,输出报告交人工。无法修复退出,比如依赖了一个不存在的外部 API,Agent 修不了,如实报告。循环检测退出,连续两轮问题列表一模一样,说明修复陷入了死循环,及时止损。
能自动解决的自动解决,不能自动解决的清晰报告。这一句,是整个系统的分寸感。
我自己日常用的配置很保守,静态零轮加动态一轮。大多数问题在动态阶段才暴露,跑一轮拿全量日志,该修的修,比盲目空转五轮效率高得多。
边界在哪,怎么用起来
实测数据放三组。上线出问题的概率,从过去的四成左右降到一成以下。成本,一轮完整的静态加动态检测,两三万输入 token 加五千到八千输出 token,按主流模型定价一次约一到三毛美元,加上自动修复循环每轮多一万左右,相比手动调试的时间成本,基本可以忽略。还有依赖图,Skill 数量过十个之后,我额外维护了一张依赖关系图,改了哪个 Skill,自动触发下游 Skill 的回归测试。实测约四成的下游错误,根因其实在上游。没有这张图,你会在下游代码里排查一个根本不在下游的问题,一排查就是一下午。
坦率的讲,这套东西不是银弹。它对结构性错误和接口契约问题的检测效果很好,但输出质量这类主观判断它测不了。文章生成了、格式对、字数够,它能查。文章写得好不好,它查不了,这部分仍然要人把关。
老雷的建议是,别一上来就搭完整的双阶段循环,先让 Agent 养成写完代码跑一遍静态检查的习惯,稳定了再上动态检测和自修复。判断标准也简单,一个 Skill 超过两个步骤,或者带任何脚本组件,就值得投入动态检测。
老雷这些年帮企业做 AI 落地,可以负责任的说,拿这套思路去检查交付里的 Agent 系统,你的 Agent 出了错是靠人盯日志,还是有结构化的检测、修复、验证闭环,这一道分水岭,基本能看出交付是玩具还是工程。
写到这儿想起人体的免疫系统。免疫细胞每天在身体里巡逻,发现异常细胞就地处理,处理不了的发烧上报,把决策权交还给大脑。一个成熟的 Skill 系统,长的就是这个样子,检测是巡逻,修复是免疫反应,报告是发烧。
Skill 会自己修自己,不是科幻,是现在就能搭起来的工程。大时代啊,朋友们。