 老雷AI实验室
SSH 加 tmux,把一队 AI 派到别的机器上替你干活
晚上九点,你面前开着三个终端窗口。左边这个让 Claude Code 改接口,中间那个跑测试跑到一半,右边那批文件改名还没开工。三个活都不难,难的是你只有一双眼睛,切来切去,最后全靠脑子记哪个干完了、哪个卡住了。而这几个窗口,还全挤在同一台机器、同一个账号里。
很多人卡在这一步,第一反应是模型不够快、账号不够强。把瓶颈摊开看,慢的往往不是 AI,是你这个既派活又盯屏的中间人。我自己就当过很长时间这种中间人,三个窗口挨个喂,喂到怀疑人生。这篇文章讲的就是怎么把中间人撤掉一半,让一个主控 AI 替你调度别处的 AI,本机的、局域网里那台 Mac mini 的、云端某台 Linux 的,只要装了 AI 编程命令行,都能纳入调度,你只管开头派单、结尾验收。
三条路别走混
多 Agent 协作目前主流就三种做法,边界很清楚,选错路会白费劲。
第一种是 subagent,Claude Code 自带的分身。主力 AI 在本机派几个分身分担任务,适合同一个项目里需要上下文隔离的并行活,比如一个分身跑测试、另一个改代码。它的限制在三道坎上,分身全锁在本机,别的机器够不着;分身全是同一个工具,换不成 Codex 或 OpenCode;几个分身共用同一个账号的额度,开得越多烧得越快。
第二种是 MCP,把另一个 AI 包装成一个工具,调一次、拿一次结果。标准化程度高,适合精准调用某个 AI 的特定能力,比如让翻译 AI 处理一段文本。但每个想接入的 AI 都得单独配一层适配,想跨机器还要自己搭传输和运维,它天生不是为长时间托管设计的。打个比方,MCP 像打电话,问完就挂,你别指望电话那头替你守一晚上机器。
第三种是跨机器调度,这篇文章的主角。它不包装、不适配,用 tmux 给远端的 AI 挂一个常驻会话,主控像一个真人坐在那台机器面前,盯着它干、干到一半随时插话、它卡住了还能反过来问你。一句大白话,这不是调一下就走的工具,是托管一个一直在干活的 AI。
老雷的建议是把三种模式当成三把量程不同的尺子。subagent 解决的是一个项目里的上下文隔离,解决不了机器和额度不够用;MCP 解决的是一次标准调用,解决不了长任务守着跑。本机并行用 subagent,短调用用 MCP,跨机器、跨账号、跨工具的长任务,才轮到 SSH 加 tmux 出场。
没有黑科技,就两样老工具
一台电脑凭什么能操控另一台电脑上的 AI。答案朴素到有点扫兴,SSH 加 tmux,全是 Linux 和 macOS 自带的东西,没有额外框架要装。
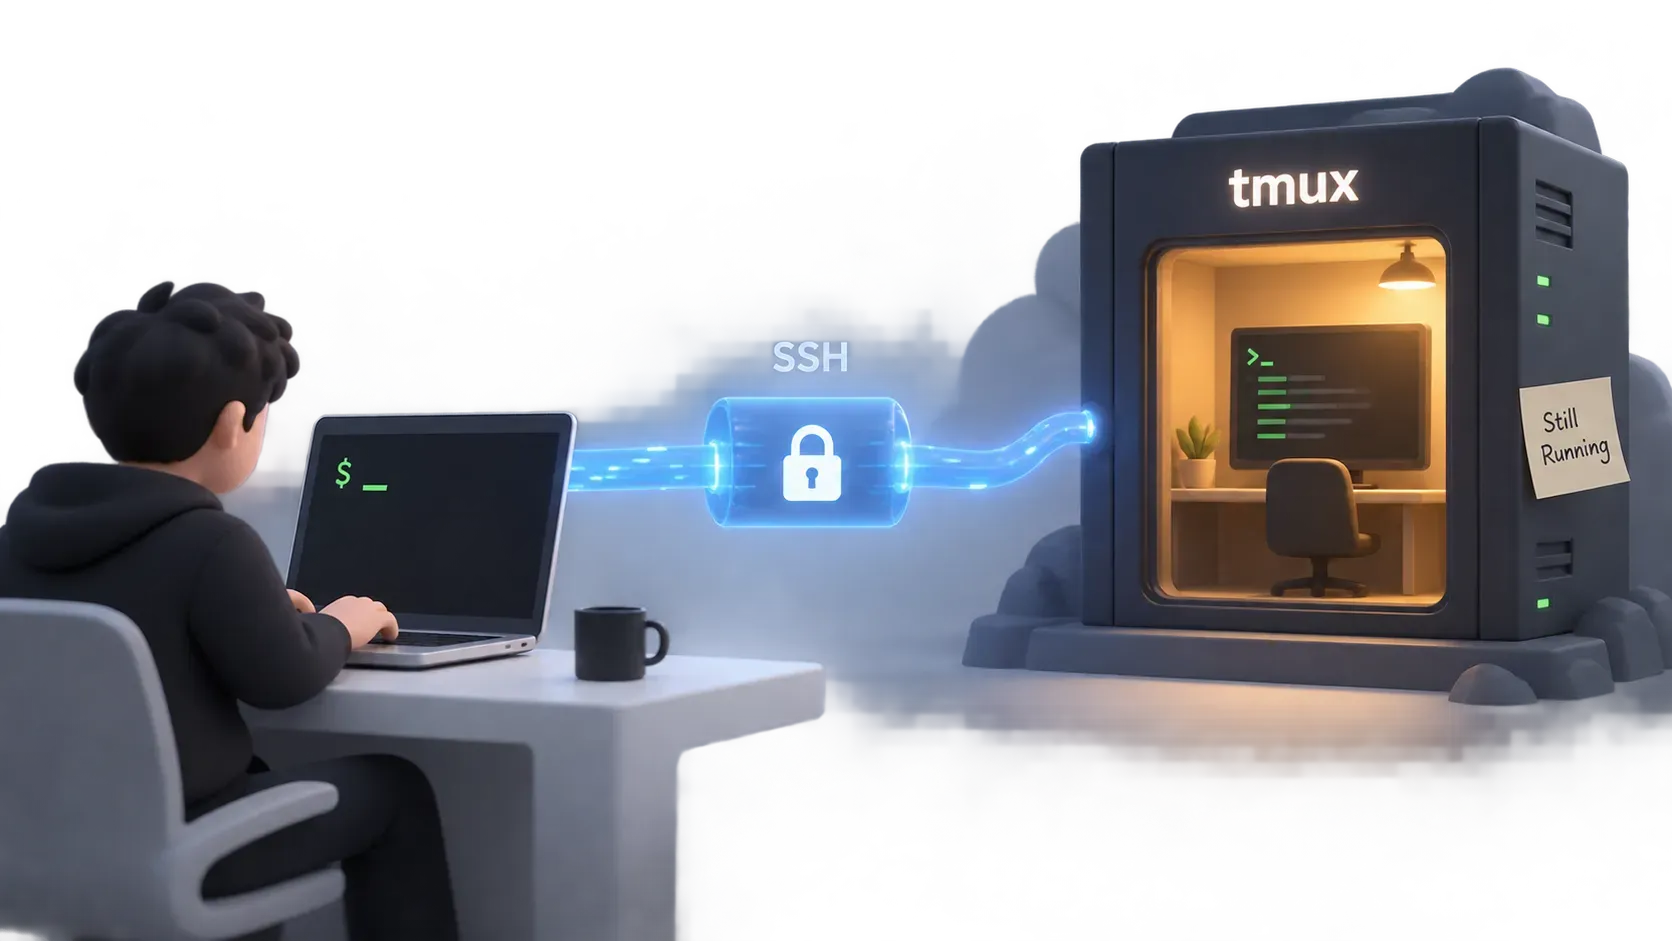
SSH 负责把手伸过去。它是一条加密通道,隔着网络在另一台机器上敲命令,程序员远程登服务器用的就是它。
tmux 负责让活不断。它是一个常驻会话管理器,你把它想成一个永远不关灯的房间,在里面开一个程序跑着,哪怕断开连接,程序照样活着,想看了随时连回去,进度一点没丢。
两个拼起来就三步。第一步 SSH 连上远端机器,相当于隔空坐到了那台机器的终端前。第二步在远端把 AI 编程命令行启动起来,放进 tmux 的常驻会话里,从此它的输入输出全被会话接管。第三步主控 AI 往会话里敲指令、从屏幕上读回应,远端那个 AI 分不清对面坐的是人还是另一个 AI。
它没造任何新东西,只是把人人都有的老工具串成一条调度流水线。Claude Code、Codex CLI、OpenCode,只要那台机器装好了工具、登录好了账号,连过去就能用,各家原本的登录态原样照搬。
为什么非要常驻会话。因为长任务最怕断线,跑到一半的仓库审查、写到一半的文档,一断就前功尽弃。挂进 tmux 的会话里,网络抖一下、笔记本合上盖,远端的活照常往前走,你晚点连回去看结果就行。这就是托管和调用的分水岭,调用在乎这一次快不快,托管在乎这一趟稳不稳。
顺带说一句,如果你在用 Claude Code 内建的 Agent Teams,它和这套东西不冲突。Agent Teams 的队友共享同一台机器和同一份额度,跨机器调度连的是不同机器上的独立账号,一个管机内协作,一个管机间派活,可以叠加着用。
四类活可以甩出去
对号入座,符合任意一条就值得搭。
手上碎活多、主力账号贵的。补注释、批量改名、跑测试这些不烧脑的任务,占着最贵的模型慢慢磨,是纯粹的浪费。
有闲置机器的。家里的 Mac mini、公司的测试机、云端的 VPS,装了 AI 编程命令行却只能晾着。
要同时推进多个独立任务的。代码审查、文档生成、数据迁移各自独立,串行排队太慢。
想把设计和执行分开的。主力 AI 专心出方案,执行交给另一批 AI 照图施工。
反过来,只有一台机器、一个账号、任务量不大,subagent 就够,别为用而用,工具是伺候活儿的,不是拿来供着的。
规模上有个社区实测出来的经验值,同时调度 3 到 5 个远端 AI 比较稳定,再多的话,任务拆分和结果合并的管理成本会明显上升。别问老雷是怎么知道的,活拆得不干净,收结果的痛苦比派活还大。关键从来不是数量,是你把活拆得合不合理。
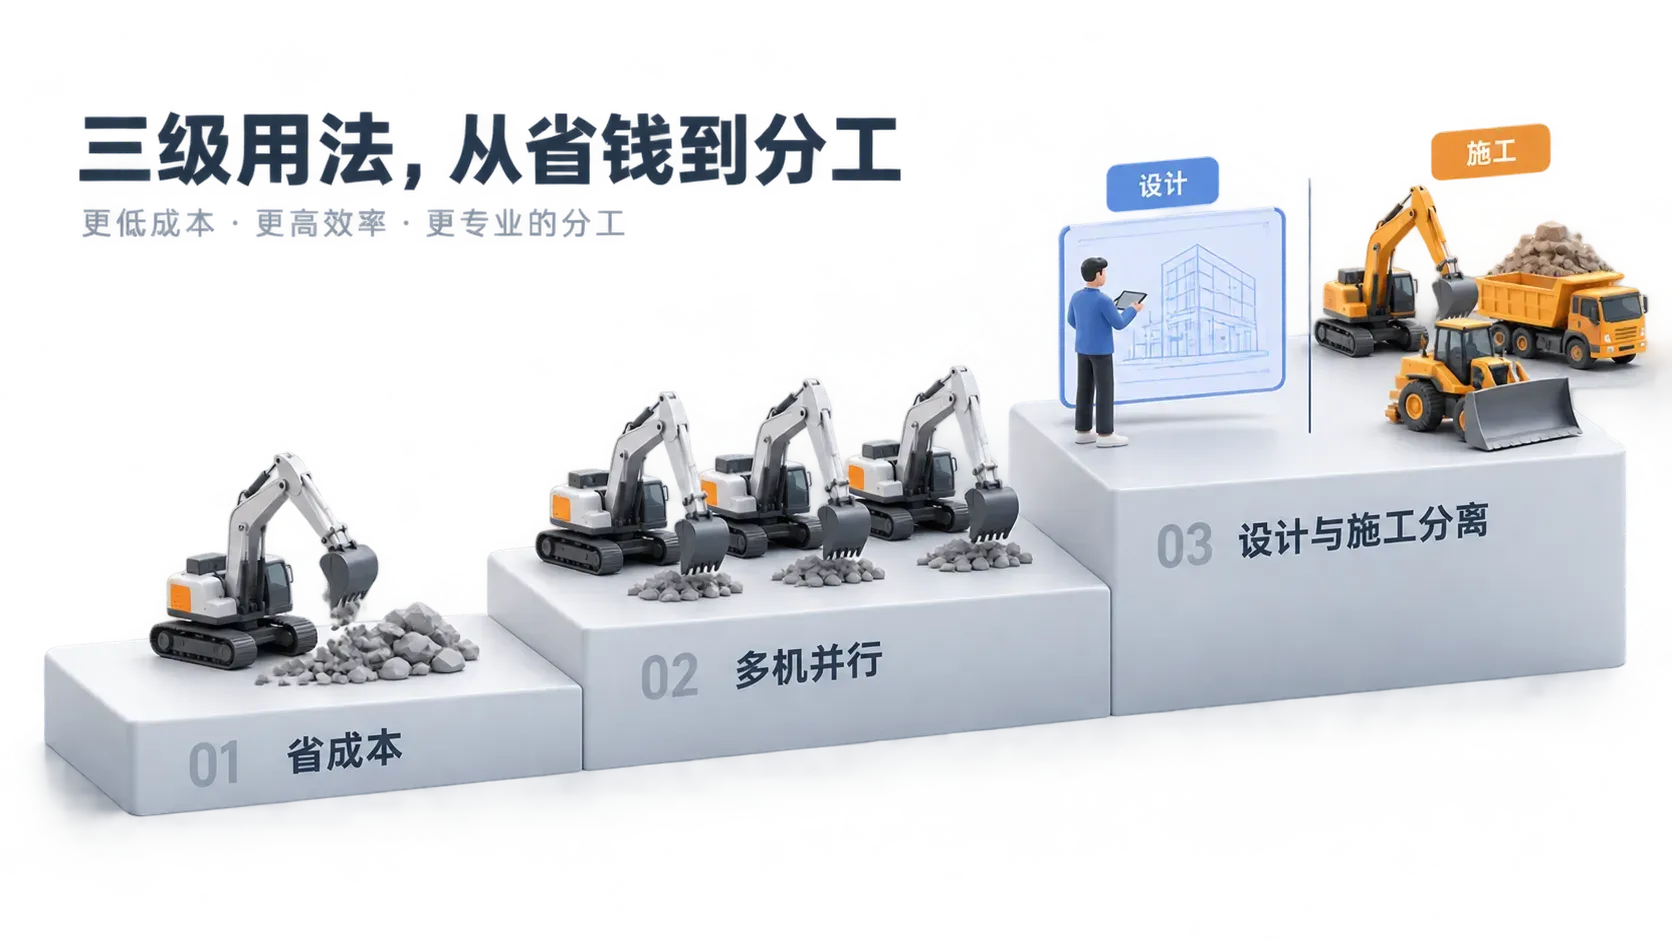
三级用法,从省钱到分工
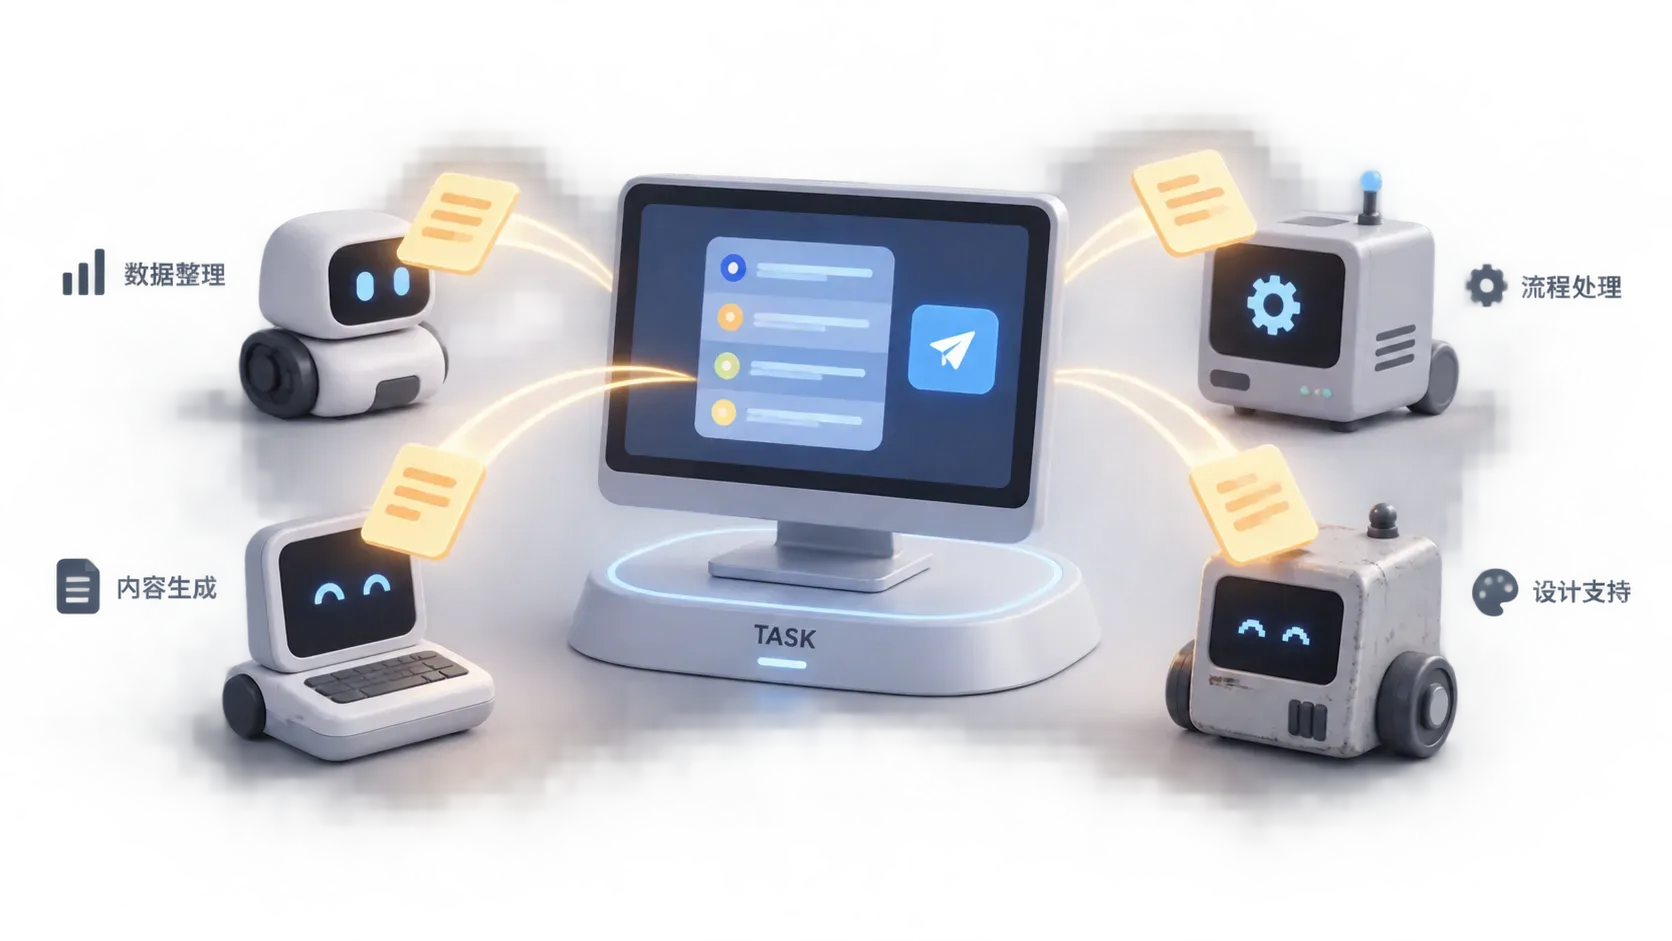
凡是你平时坐在命令行前一句句喂着干的活,几乎都能整批甩出去并行跑。批量补注释、批量改文件名、跑完整套测试、通读一个仓库做代码审查、根据代码反过头来写文档,全在名单上。三种用法是一道递进的台阶,一级比一级有意思。
第一级,省成本。把手上的活按难度分堆,补注释、整理格式这种碎活铺给便宜的基础款账号慢慢磨,主力腾出手啃重构和架构设计的硬骨头。这不是野路子,Claude Code 官方文档本来就建议按模型能力分级使用,简单任务用便宜快速的档位,跨机器调度只是用一条命令把这个建议自动化了。能省多少,取决于碎活的数量和两档账号的价格差,碎活越多、价差越大,这条路越划算。
第二级,满血协作。把便宜账号换成另一台满血的 Codex 或 Claude Code,性质就变了。一条命令把活交给另一台机器上的满血账号,再来一条命令把好几个满血任务一次铺出去,多台机器、多个登录好的账号同时下场。一台机器专门跑代码审查,一台专门生成文档,第三台啃重构,多个强 AI 各干各的、并排往前推。这时候你面对的不再是我和我的 AI,是我和我指挥的一队 AI。
第三级,架构分离。把想和做彻底拆开,主控 AI 只出图纸,写完整方案、做设计评审,照图施工整个交给外部的执行 AI,中间盯着进度、随时补指令、最后拿结果验收。动脑的评审用贵模型保证判断质量,重复的执行用便宜模型压成本。这套先规划再执行的分工在软件工程里是成熟做法,现在只是把施工队换成了 AI。
慢的那个从来不是 AI,是还在一句句喂、一个个盯的人。
起步清单
落地这件事,别想着一步到位,老雷给大家一个最小起步顺序,三个晚上就能跑通。
第一晚,挑一台闲置机器,确认 SSH 能连上,装好 AI 编程命令行并登录。第二晚,在那台机器上起一个 tmux 会话,把 Claude Code 挂进去,然后故意断开重连一次,确认活还在跑。第三晚,让主力 AI 顺着 SSH 往那个会话里派第一个真实任务,从批量补注释这类错了也不心疼的活开始,跑通派单、盯进度、收结果的全流程。
每一步给自己一个验收点。第一晚的标准是断开重连不丢会话,第二晚的标准是派出去的指令能在远端屏幕上看到回应,第三晚的标准是你全程没碰过远端键盘,活照样从派单走到了验收。三晚跑不顺就停在原地排错,别急着扩规模。
两个提醒。别一上来就把核心业务甩出去,先让不心疼的碎活替你把信任跑出来。也别贪多,先把一两台机器的链路跑稳,再往满血协作和架构分离走。
跑顺之后再加机器、加账号,往满血协作和架构分离走。投入产出有个简单的判断线,当你有两台以上的机器、两个以上的账号,跨机器调度的回报就会明显高于 subagent 和 MCP。因为真正吃掉你时间的长任务,通读一个仓库做审查、几十个文件批量重构,需要的都是一个托管着的、持续干活的 AI,而不是调一下就走的工具。
工具早就替你备好了,SSH 和 tmux 就躺在你的系统里。差的只是把第一个任务派出去的那个动作,派出去,你的第一队 AI 就开工了。