 老雷AI实验室
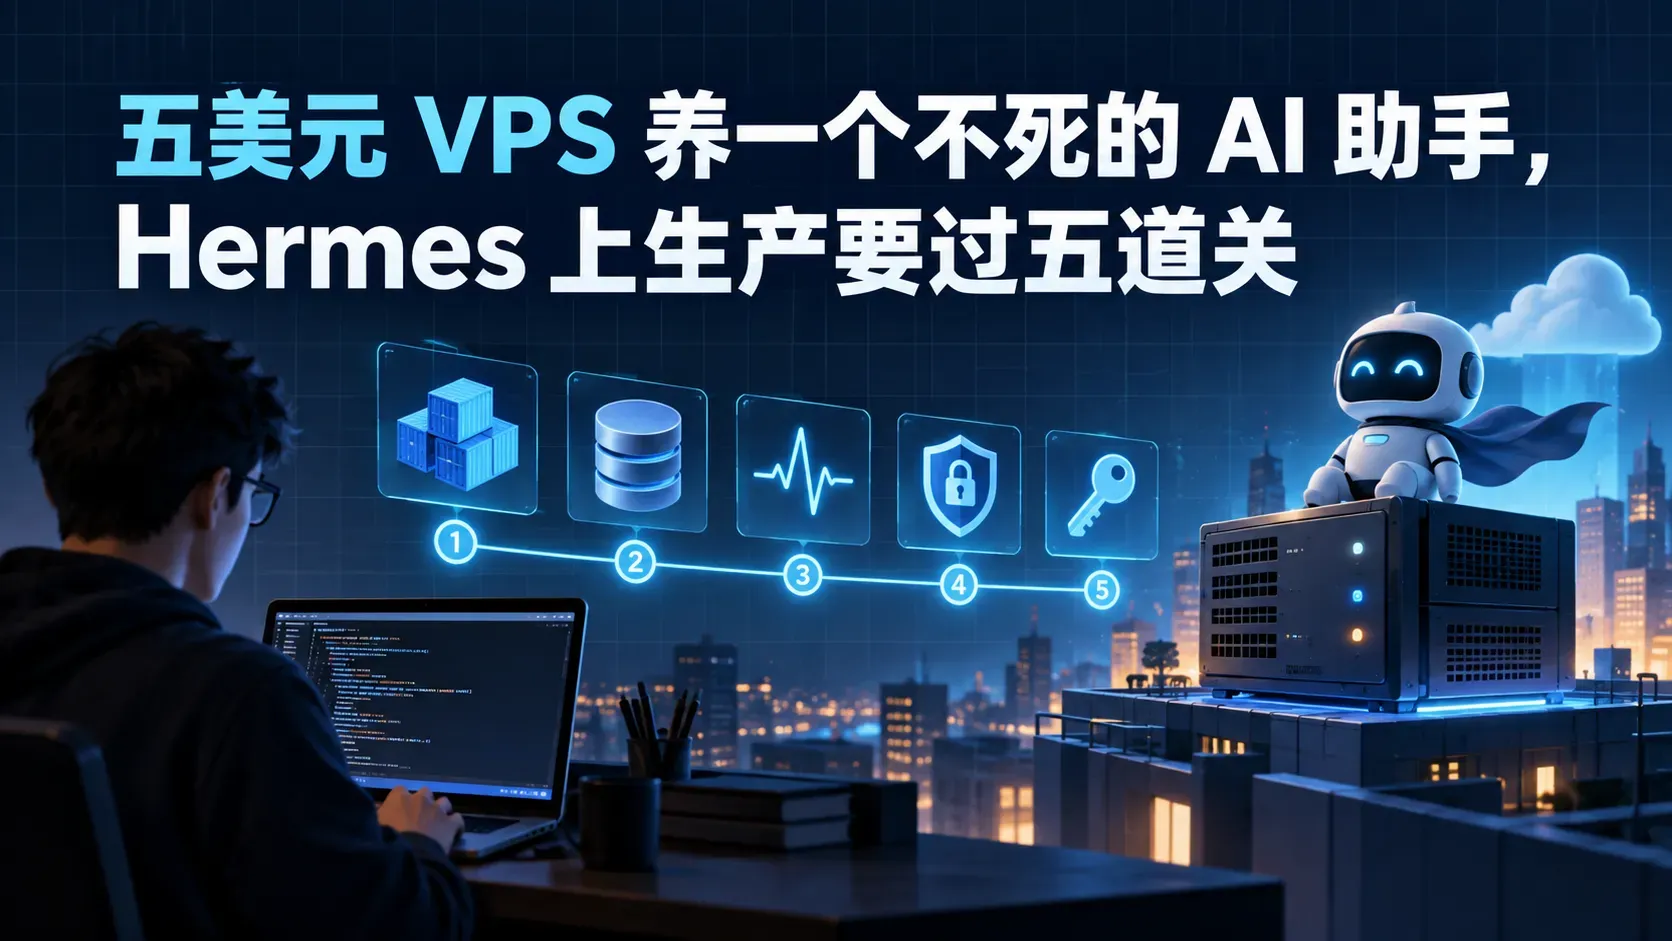
五美元 VPS 养一个不死的 AI 助手,Hermes 上生产要过五道关
在本地把 Hermes Agent 跑通的那一刻,多数人会顺手做一件事,让它就这么开着,然后合上笔记本。它本来还在消息平台里替你收发消息、跑定时任务,电脑一合,全没了。这个 Agent 的价值有一半在 24 小时在线,而本地机器给不了。
搬上 VPS 是唯一的正路,但配置向导跑完只是开始。容器怎么编排、数据怎么持久化、进程崩了谁来拉起、密钥放在哪、Dashboard 怎么暴露,每一环都有坑,这是我们实测过后才敢说的话。这篇按交付顺序把五道关拆开,命令都能直接抄,全部跑完大概半小时。
第一关,先分清两种玩法
Hermes 和 Docker 有两种完全不同的关系,官方文档开篇就区分,很多人还是会搞混。
第一种,Agent 本体整个跑在容器里。容器里有完整的 Python 环境、Node.js、Playwright 浏览器组件和 s6 进程管理器,你在 Telegram、Discord 发消息,容器里的 Hermes 处理,容器就是它的家。这是本文的主线。
第二种,Docker 只是命令的沙箱。Agent 在宿主机运行,配置里把 terminal.backend 设成 docker,它执行的每条命令都丢进一个持久化沙箱容器, rm -rf 这类危险操作破坏的是沙箱而不是你的机器。两种可以叠加,Agent 在容器 A 里,命令在沙箱 B 里执行,双层隔离。先把第一种跑通再考虑叠加。
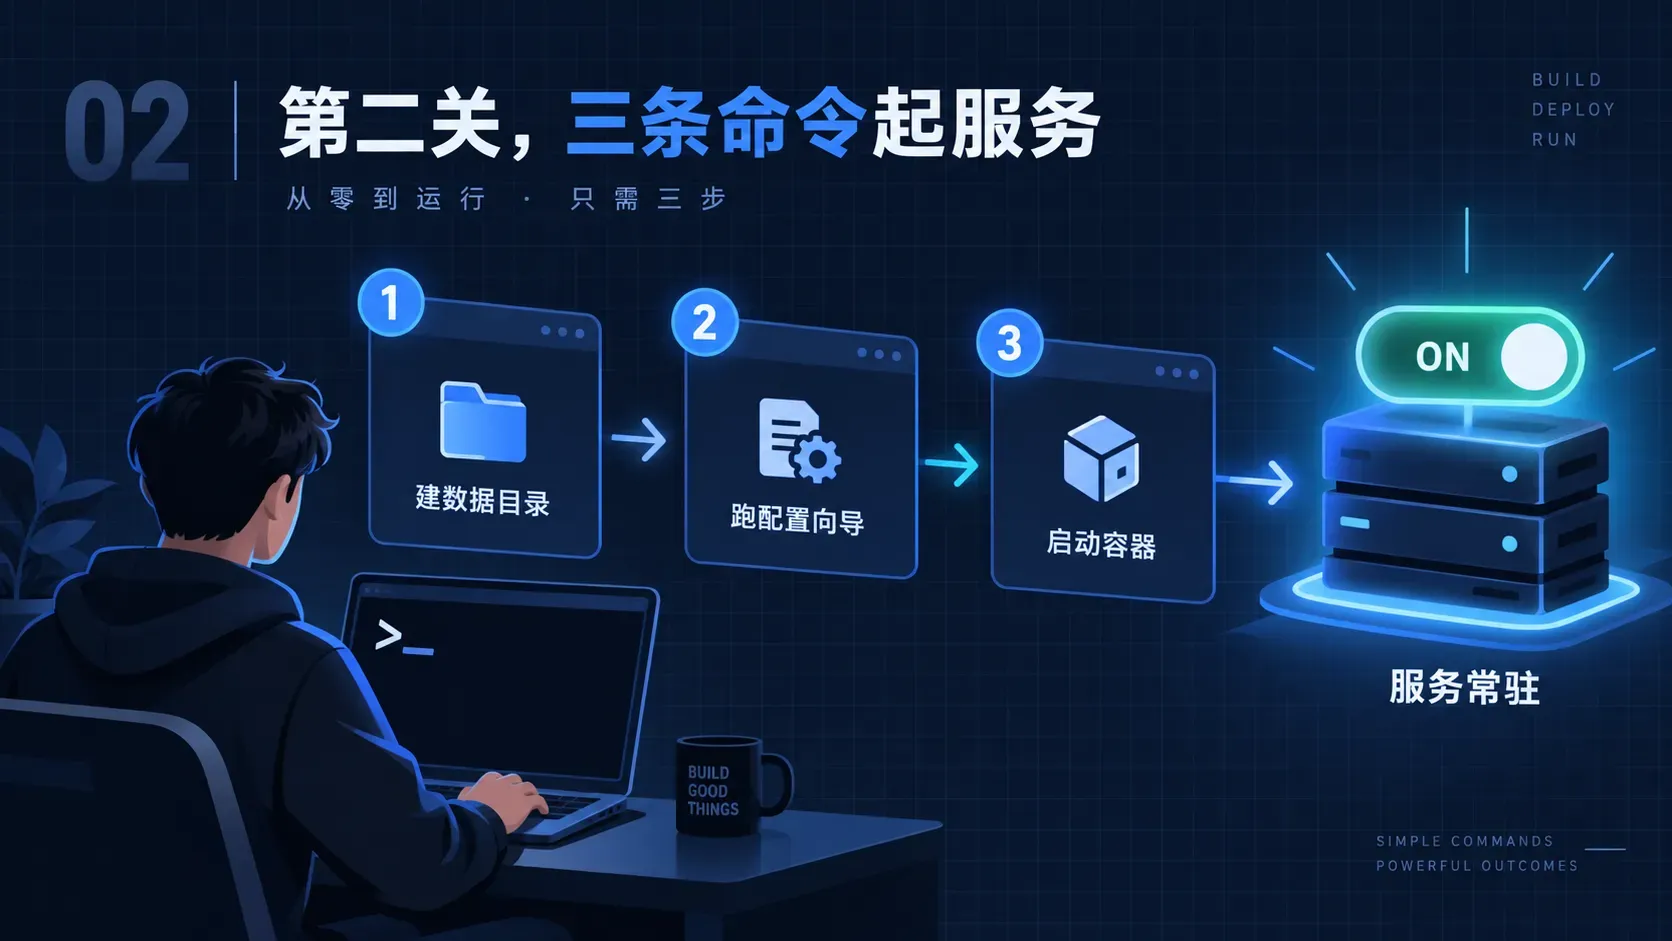
第二关,三条命令起服务
机器不用纠结。实测不跑本地模型时 Hermes 内存占用不到 500MB,模型推理全走 API 调用,OpenRouter、Nous Portal 这类,Agent 本身只做调度,像一个只传话的管家。最低 1 核 1GB 就能跑,要用浏览器自动化(开网页、填表单)建议 2 到 4GB。账很清楚,五美元的 VPS 加两到五美元的 API 费,每月七到十美元养一个全天候助手;拿 Oracle 的免费 ARM 实例,VPS 这一项直接归零。
mkdir -p ~/.hermes
docker run -it --rm -v ~/.hermes:/opt/data nousresearch/hermes-agent setup
docker compose up -d
第二条是交互式配置向导,填 API Key、选消息平台,密钥写进 .env,其他配置写进 config.yaml,建议这一步就把消息平台配好。--rm 让它用完即销毁,它唯一的任务就是往数据目录写文件。第三条才启动常驻容器。镜像底座是 Debian,Python、Node、Playwright、s6 全部打包在内,压缩包约 2.6GB,第一次拉取耐心点。
一个省钱的冷知识,Telegram、Discord 这类消息平台全部走出站长轮询,是 Agent 主动连平台,不需要任何入站端口。如果你不打算对外暴露 Gateway API,端口映射可以整个删掉,攻击面小一截。
VPS 的选择也有捷径。Hetzner 四块五一个月,性价比最高;Hostinger 的应用目录里有 Hermes 一键模板,选好计划自动装 Docker、部署容器,你只需要 SSH 进去跑一遍配置向导,全程不到十分钟。不想从头搭环境的,从模板起步能省掉一半命令。Oracle 的 Always Free 实例给到 4 核 24GB 内存,白嫖党直接封顶。老雷的建议是第一台上生产选五美元档把全流程跑顺,流程熟了再谈升配,别一上来就堆配置。
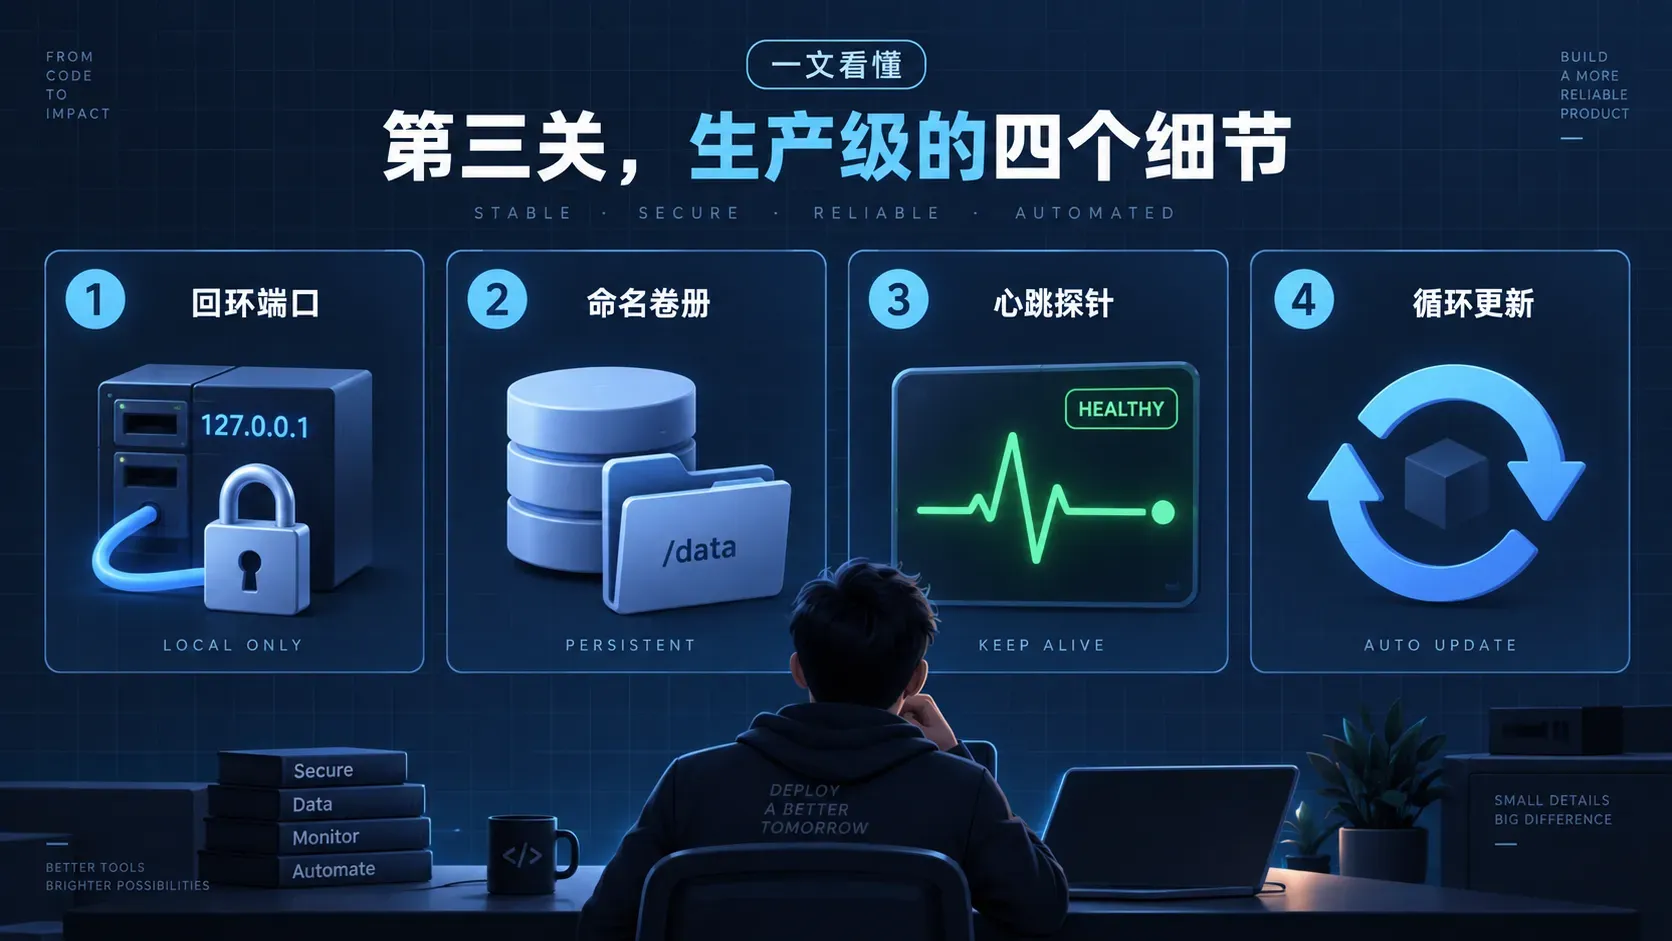
第三关,生产级的四个细节
最简配置能跑,离能睡安稳觉还差四个细节,全在 docker-compose.yml 里。
端口只绑本地回环。要暴露 API 就绑 127.0.0.1,公网入口交给 Caddy 或 Nginx 做 HTTPS 和认证,Dashboard 干脆只走 SSH 隧道。无认证的 Dashboard 绑到公网,官方直接拒绝启动,这道防线别绕。反向代理选型一句话,Caddy 自动申请续期证书,几行配置完事;Nginx 要自己管证书,还得把 proxyreadtimeout 拉到一小时以上,Hermes 的 SSE 长连接默认 60 秒就断,这是最容易漏的一个参数。
数据卷用 Named Volume。比直接映射宿主机目录安全,docker compose down 不会动它,只有显式带 -v 才会删。生产环境永远别敲那个 -v,一句话记住,手滑一次,会话、记忆、人格定义全部归零。
healthcheck 探活。每 30 秒探测一次 Gateway 的 /health 端点,连续三次失败 Docker 自动重建容器,配合后面的 s6 双保险。
Watchtower 自动更新。每小时检查一次上游镜像,有新版自动拉取、重建、清理旧镜像,你不用手动跑 pull。
数据目录是全部状态的唯一真值源,.env 密钥、config.yaml、SOUL.md 人格、会话历史、持久记忆、技能、定时任务全在里面。备份别偷懒,容器里一条 hermes backup 命令就能导出 zip 包,拿 cron 每天打一份,恢复用 hermes import 导回来。
日常体检也给你四条命令。hermes doctor 做全面自检,gateway status 看网关状态,docker stats 看实时资源占用,docker logs 加 tail 看最近日志。每天扫一眼,问题都在变成事故之前就被你看见。
第四关,让它永远活着
--restart unless-stopped 一个参数解决容器级崩溃恢复和 VPS 重启自动拉起,只有手动 stop 才停得下来。
容器内部还有一层。官方镜像用 s6-overlay 做一号进程,Gateway 进程崩了,s6 几秒内原地拉起,Dashboard 等其他进程完全不受影响,日志自动旋转。Docker 的 restart 是整个容器推倒重来,s6 是进程级的心肺复苏,两层各管各的。官方从早期的 tini 换到 s6 那次改造,一个 PR 改了四十个文件,就是为了把降权运行和秒级恢复一起做进去,你在镜像层面自动享受到,配置一行都不用改。
一条铁律刻在脑门上,一个数据目录只允许一个 Gateway 进程。两个容器指向同一个数据目录,轻则对话历史丢失,重则配置文件写坏。想跑多个 Agent,用多 Profile 模式,一个容器里建多个实例,命令就两行。
docker exec hermes hermes profile create work
docker exec hermes hermes profile create personal
work 连公司 Slack,personal 连私人 Telegram,各自配不同的模型和人格定义,s6 分别监管。每个 Profile 的日志单独落在 logs/gateways 目录下,启停也互不影响,加 --profile 指定名字就行。磁盘和内存只花一份,镜像和运行时全共享。要资源硬隔离的时候再拆成多个容器。
顺带一提不用 Docker 的裸机路线。Linux 上用 systemd 管进程,Restart 设成 always、RestartSec 给 10 秒,开机自启加崩溃恢复都有了;macOS 用 launchd,但有个小陷阱,每次重装网关服务会重新生成 plist,工作目录要手动修补回去。能上 Docker 还是上 Docker,少管一层进程。
第五关,安全加固和踩坑清单
Hermes 有自主执行命令的能力,安全配置比普通 Web 应用更要紧。官方是七层纵深防御,用户允许列表、危险命令审批、容器隔离、凭据隔离、上下文注入扫描、会话隔离、输入消毒,底下还有一个硬编码黑名单,rm -rf、fork bomb 这类命令就算开了 yolo 模式也绝不执行。你要做的第一件事反而最简单,把 .env 的权限改成 600,仅所有者可读写。
密钥多了以后还有一层烦恼,轮换。三台 VPS 各跑一个实例,API Key 一换就得逐台 SSH 上去改 .env,漏一台就是线上事故。Hermes 原生集成了 Bitwarden Secrets Manager,Web 端轮换一次,所有机器下次启动自动拉新值,bws 二进制首次使用时自动下载、版本钉死保证可复现。老雷给大家提个醒,这套机制容错做得不错,Bitwarden 拉取失败只警告一行,Agent 照常用 .env 里的旧凭据启动,密钥管理永远不会阻塞主服务。单机自用犯不上,多机集群值得接。
然后是踩坑清单,条条都来自官方文档和社区里真实发生过的故障,上线前照着排一遍,比自己摸索快得多。Dashboard 最稳的访问姿势是 SSH 隧道,本地一条 ssh -L 命令把远端 9119 端口转到自己机器上,浏览器开 localhost 看,公网上完全看不见这个入口。
坑一,别用 VPS 商的网页终端。某些控制台会把冒号渲染成分号、把 @ 错误替换,静默破坏挂载参数和 API Key,你还以为输对了。永远 SSH 连上去操作。
坑二,UID/GID 不匹配会报权限错误,环境变量把 HERMESUID、HERMESGID 设成自己的。坑三,浏览器自动化最吃内存,触发 OOM 就给容器限 4G 内存或者干脆关掉浏览器工具。坑四,SELinux 机器上挂载被拒,卷后面加 :Z。坑五,升级前先备份,然后 compose pull 加 up -d,数据卷保留,配置格式变了会自动迁移,Watchtower 用户等于全自动。
再给一个省钱变量的备注。Agent 不是每天都派重活的场景,可以算另一笔账,Modal 这类按秒计费的云函数,每天有效计算低于两三小时会比 VPS 便宜,超过就 VPS 划算。但常驻网关必须永远在线收消息,这类负载 Modal 不合适,别为了省小钱把在线能力省没了。想压 API 成本,把 Hermes 和 Ollama、vLLM 放进同一个 Docker 网络,容器名就是主机名,模型地址指向网络内的 ollama 容器,推理不出机器,代价是内存得跟上。
收尾过一遍清单。数据在 Named Volume 里吗。端口只绑回环了吗。.env 是 600 吗。SSH 操作的吗。备份的 cron 挂了吗。全过,这个 Agent 才算真的活着。
所谓 24 小时在线,不是把它跑起来,是让它想死都死不掉。
五美元一个月,换来的是一个不睡觉、不失忆、随叫随到的数字员工。也别把这次部署当成一次性的任务,这套配置的真正回报在半年之后,你的 Agent 记忆攒了半年、技能越装越全,它对你业务的熟悉程度是任何新员工都追不上的。把部署这道关过了,Hermes 才从你的玩具,变成你的同事。