 老雷AI实验室
先整理再扩大,Claude Code 上下文窗口的实操手册
一个真实场景。上周五我让 Claude Code 追一个跨了十几个文件的 bug,会话拖到晚上,它突然自己把前面的对话压成了一段摘要,然后把我下午强调过的一句「这个目录不要动」忘得干干净净,一路改了进去。回滚花了半小时,复盘花了一晚上。
问题不在模型笨,在我没管好它的工作记忆。这篇把上下文窗口的机制、1M 怎么开、什么时候该开、开了怎么管,一次讲清,全是能直接上手的动作。
先建立直觉。上下文窗口就是 Claude 这次任务能同时看到的全部材料,你贴的代码、对话历史、读过的文档、跑出来的日志,全摊在这一张台子上。官方管它叫工作记忆,和训练时学过的知识是两回事。
有个新手最容易忽略的事实,Claude Code 每开一个新会话都是一张白纸,它不记得你上次聊过什么。这次判断准不准,几乎完全取决于窗口里放了什么。所以管上下文不是锦上添花,是决定交付质量的头号变量。
默认窗口大约 200K token,装下一个中型模块的代码加一整段调试对话没问题。1M context 就是把这张台子扩到五倍大,一整个项目的代码、一长串报错日志、几份设计文档,可以同时摊开。
但先泼一盆冷水,1M 不是记忆库。会话一结束、一清空,里面的东西就没了。真正能跨会话留下来的,是你写进 CLAUDE.md 这类项目文件里的规则。别把窗口大当成它会一直记得。
1M 怎么开,四种账号四种开法
结论前置,1M 不是默认,默认是 200K。怎么开取决于你的账号。
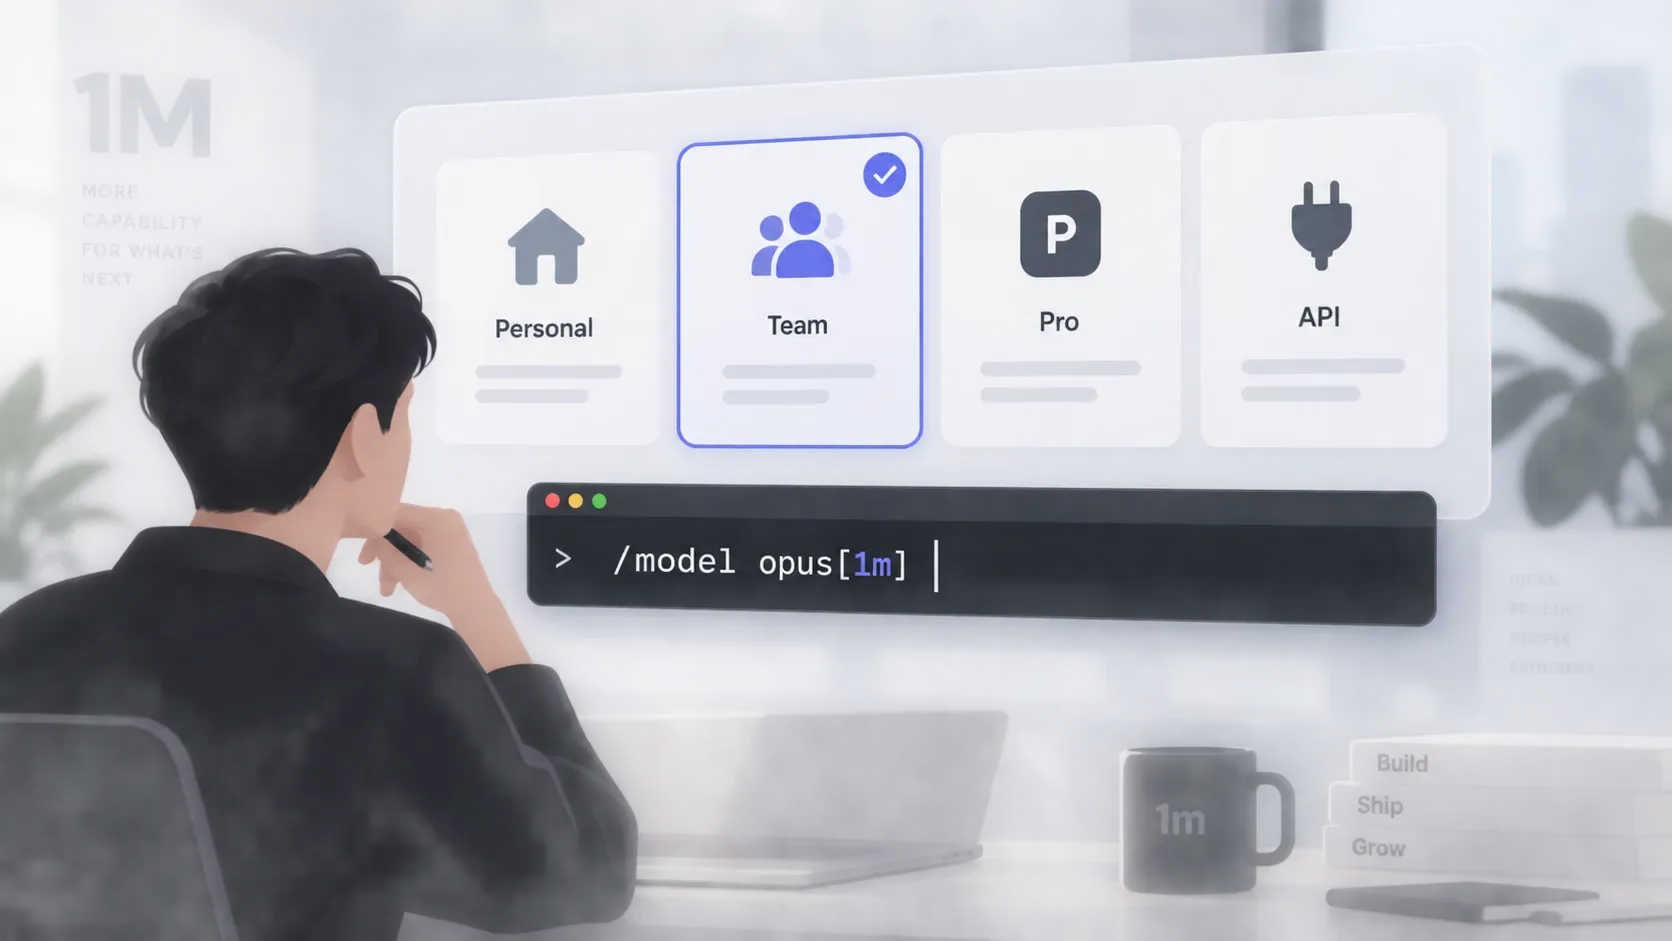
Max、Team、Enterprise 订阅,用 Opus 时自动升到 1M,什么都不用配。Pro 订阅,以及任何计划下想给 Sonnet 开 1M,都要先开通用量额度,一种额外付费的预付额度。API 按量付费则完整可用,模型后面带 1M 标识的直接就是。
手动指定的办法是在会话里跑这个。
/model opus[1m]
/model sonnet[1m]
[1m] 后缀就是个开关,告诉 Claude Code 这次用一百万窗口那一版,不改别的。想固定默认,用环境变量。
export ANTHROPIC_DEFAULT_OPUS_MODEL='claude-opus-4-8[1m]'
开没开怎么确认,跑 /status 看当前模型,或者打开 /model 选择器看有没有 1M 选项,没有就重启会话再看。想彻底关掉,设 CLAUDE_CODE_DISABLE_1M_CONTEXT=1,选择器里所有 1M 模型会被移除。
模型支持上,按官方文档,Opus 4.6 及更新版本和 Sonnet 4.6 有 1M 窗口,Sonnet 4.5 及更早的仍是 200K,具体以官方当前文档为准。
context rot,窗口越大反而越钝
这是整篇最该记住的一节。context rot,上下文衰减,是 Anthropic 官方文档里的正式术语,定义很直白,随着 token 数量增长,模型的准确率和召回率会下降。
更多上下文不会自动更好,整理放了什么,和窗口有多大同样重要。
为什么会这样,三个原因。材料一多,你最在意的那条约束容易被大段无关代码淹没。前面提过的条件、失败尝试、验收标准,在超长会话里会变得不显眼。四十万 token 之前的旧内容和最新这句话,还在竞争同一份注意力。
回到工作台就很好懂,台面换大了,你一兴奋把所有抽屉全倒上去,真正要用的那张图纸反而被旧便签盖住了。
老雷在这栽过跟头,早期做长任务习惯把整个仓库往里塞,结果它连入口文件在哪个目录都能认错。后来学乖了,多数时候问题不是窗口不够,是材料顺序不对。让 Claude 先读错误日志,再读入口文件,再读最近的改动,效果通常好过一上来把仓库全给它。顺序本身就是上下文的一部分。
Auto Compact 会续命,也会丢细节
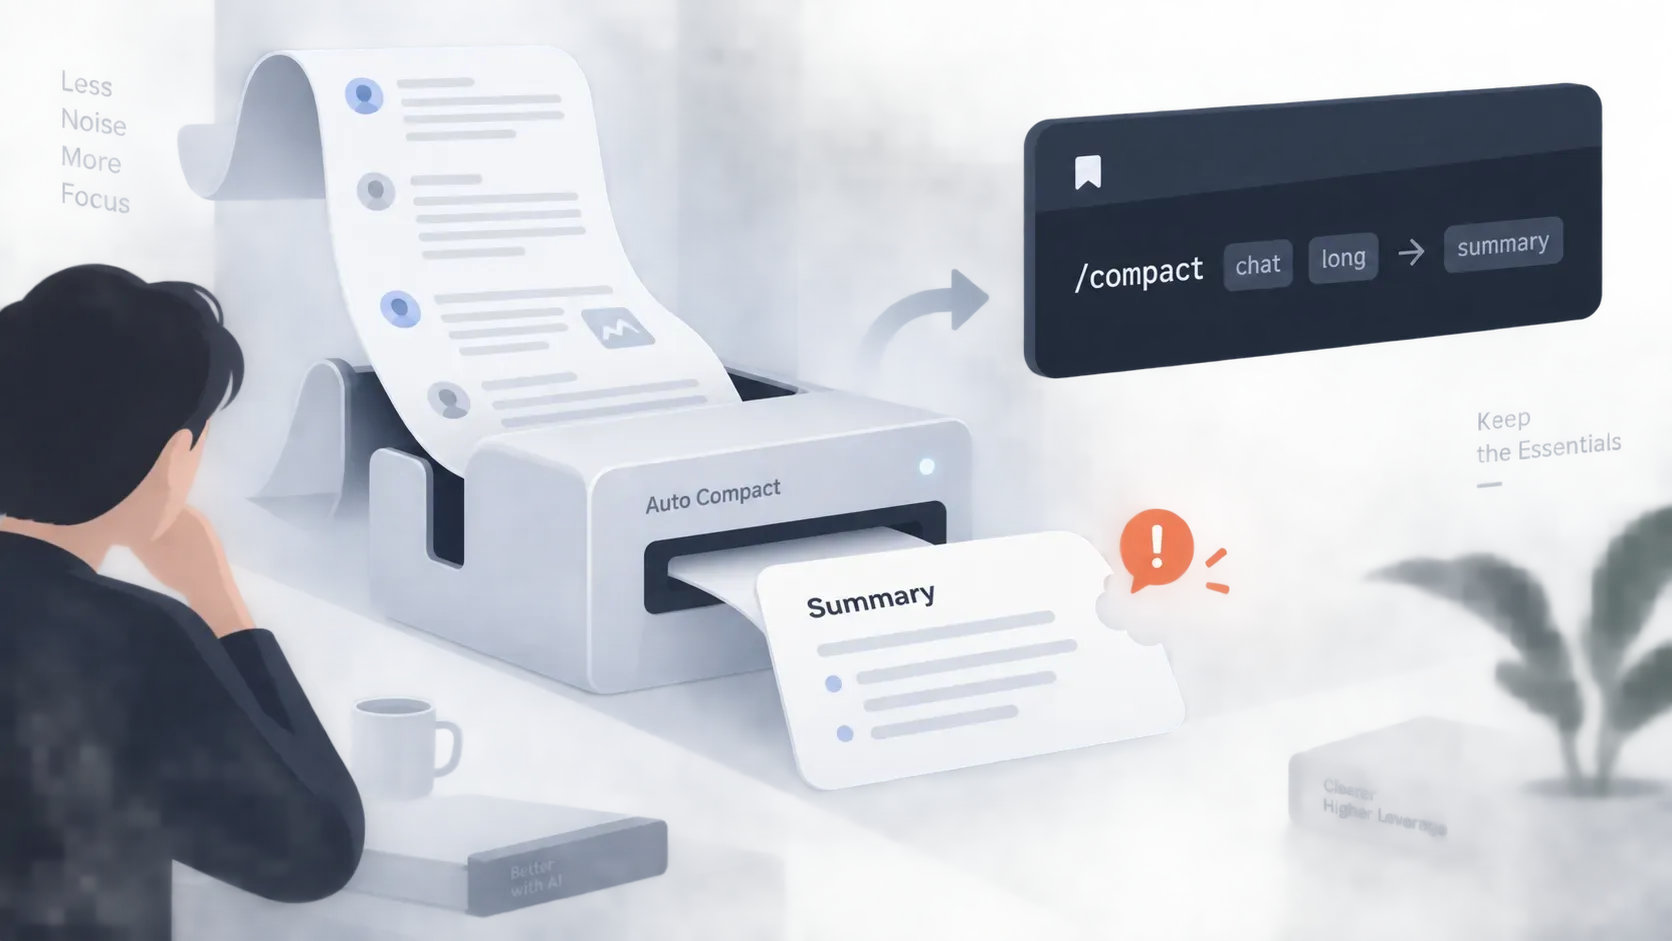
会话越聊越长,总会接近上限。Claude Code 的处理机制叫 Auto Compact,接近上限时自动把较早的历史总结成摘要,再拿着摘要继续干。好处是长会话不会突然中断,代价是摘要会丢细节。
丢的恰恰是最要命的几样。某个方案为什么失败的具体原因。你强调过的文件路径和目录边界。你口头交代的「这个不要动」。开头那个周五翻车现场,就是这么来的。
所以别把 Auto Compact 当保险箱,它不知道你心里最在意哪条。两个对策。
一是主动压缩,别等自动。长会话写到一半,自己跑一句带保留指令的压缩。
/compact 重点保留报错、文件路径和我说过不要动的目录
二是把偏好固化进 CLAUDE.md,让每次压缩都照办,比如写一行「压缩时重点保留测试输出和代码改动」。更稳的玩法是长任务分阶段,第一阶段只定位不改文件,第二阶段只做小范围修改,第三阶段只做验证,每段结束写几句交接,说清确认了什么、没确认什么、下一步从哪开始。
自动压缩之外,还有两个手动主力命令,名字像,作用完全不同。
/compact 把当前对话总结成摘要,保留要点后在摘要上继续,适合同一件事必须连贯做下去的场景。/clear 完全清空对话历史从零开始,CLAUDE.md、Skills、配置都还在,适合切到不相关的新任务,或者当前会话已经被带偏。
一个反直觉的经验,/clear 该用得比你以为的更勤。干净会话加一句清楚的提示词,往往比一个反复修正、越拖越长的会话靠谱。最常见的浪费是干完 A 任务不清场就接着干不相关的 B 任务,A 的残留既费 token 又制造 context rot,两头亏。
判断标准一句话,换主题就 clear,续主题就 compact。
什么时候才真的需要 1M
前面一直在劝退,那 1M 到底什么时候上。答案是任务需要连续保留一条很长的判断链时,具体四类。
跨很多文件追一个问题,错误日志、复现步骤、试过的方案一条都不能丢,被压缩掉就得重来。大项目重构,多个模块的约束和依赖要同时盯着。多 Agent 协作或长时间任务,材料不断累积,需要大缓冲兜底。审计、合同、长报告这类活,要随时回到原文定位某一句。
反过来,改一个小函数、查一个配置、改一段文案,默认窗口绰绰有余,开大了反而钝。老雷的建议是问自己一句,这次任务要不要一口气把一长串线索连起来推。要,切 /model opus[1m],不要,老老实实 200K。
还有一个不用动手就受益的改进值得知道。较新的几代模型,Sonnet 4.6、Sonnet 4.5 和 Haiku 4.5,具备上下文感知能力,模型自己能跟踪剩余 token 预算,对话开始收到总预算标记,每次调工具后收到剩余容量更新。以前干长活像没有油表的车,凭感觉猜还剩多少油,跑着跑着熄火,现在仪表盘上有数了,长任务里更能坚持做到最后。但油表不替代你整理材料,开去哪还是你定。
自动压缩和手动命令之外,还有一张更上游的牌。如果说 compact 和 clear 是整理已经堆上台面的材料,Subagents 就是从源头不让脏东西上台。
每个 Subagent 在自己独立的上下文窗口里干活,干完只把结果摘要返回主会话。主会话搭架构,派一个子代理去读五十个测试文件找废弃接口,它在自己的窗口里读完,回来只说一句十二个文件用了废弃接口,附列表。那五十个文件的内容压根没进你的主线。
这正好对症 context rot,读大量文件、跑测试、翻日志这类过程很长的探索留在子代理那边,主线只拿干净结论。判断什么该外包就一条,凡是过程很长、但你只要结论的活,交出去。
交付前后的两张清单
开工前对这张。当前账号默认是 200K 还是已开 1M,跑 /status 确认过。这次任务列了必读、可选、不要参考三类材料,没把无关的全塞进去。重要边界,哪个目录不能动、哪些结论不能猜,写进了任务说明或项目文件,不只靠会话历史。
收工前对这张。换不相关任务时用了 /clear,续同一件事用了 /compact。读大量文件、跑测试这类啰嗦活交给了 Subagents。长任务分了阶段,每段结束留了短交接。
五个高频坑再点一遍名。开了 1M 就不整理材料,正好反了,窗口越大越要标清哪句是结论哪句是背景。把 Auto Compact 当保险箱,细节会丢。换任务不清场,残留费钱又添乱。啰嗦操作全堆主会话,上下文瞬间被淹。以为自己需要 1M,其实只需要更好的材料顺序。
先整理,再扩大。1M 是兜底能力,不是日常目标。
节奏上也不用一步到位。第一周用默认 200K 跑通真实小任务,有意识地练 /clear 切任务、/compact 续任务,体会什么时候是窗口不够、什么时候只是任务说明没写清。第二周起遇到真正的长任务再开 1M,把脏活交给 Subagents。两周下来,你对「窗口里该放什么」的手感,会比现在强一个量级。