 老雷AI实验室
AGENTS.md 别憋大招,从十二行起步随项目长大
你给 Codex 交代过三遍,commit 信息要带工单号,它第四遍还是忘。跑哪个测试忘了,哪个目录不能动也忘了,每次开新对话都得从头交代一遍,像在带一个每天失忆的新实习生。
解药是一份叫 AGENTS.md 的文件。它是给 AI 编程代理看的指令文件,每次开对话自动读,省掉你重复交代的功夫。官方对它的定义干脆得很,一个简单、开放、用来引导编程代理的格式,会写 README 就会写它。Codex 认它,Cursor、Gemini CLI、GitHub Copilot 这些工具也认,一份文件多家通吃。
这篇按一份文件的真实生长顺序写,从第一份十二行怎么起,到三档边界怎么立、哪些规则不该写、仓库大了怎么分层、跨工具怎么共享,以及怎么让它不烂尾。
先搞懂它为什么有效
AI 编程代理每次开新对话,对你项目的了解都从零开始。昨天告诉它的规则,不在今天这轮对话的上下文窗口里。这是有意的设计,从头开始能避免历史错误一直跟着跑,代价是你得有一个每次自动加载的地方放项目规则。
这决定了往 AGENTS.md 里写什么只有一个判断标准,这条规则是不是每次开对话都要让 AI 知道。是,就写进去。只是这一次任务的临时要求,对话里说一句就行,别污染文件。
还有个容易想偏的问题顺手答了。README 已经写得很全,还要 AGENTS.md 吗。要。README 是叙事性的,写给人看,讲项目是什么、为什么存在。AI 需要的是命令式、可验证的守则,讲怎么跑命令、不能动哪里。两边各司其职,别互相重复。
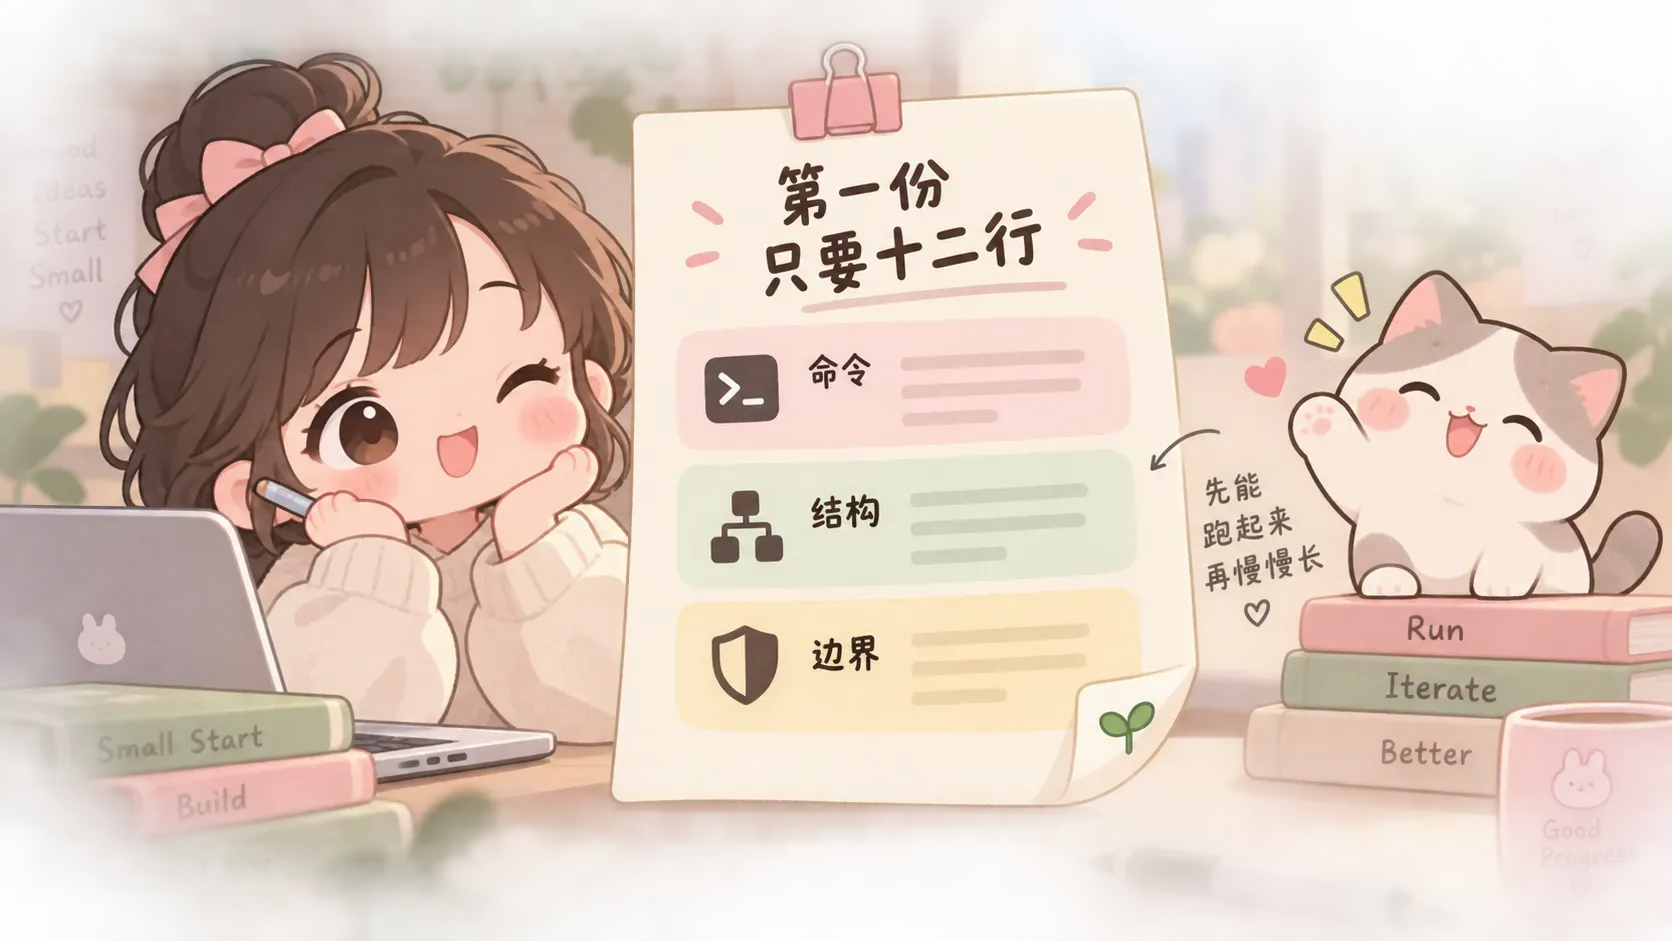
第一份只要十二行
新手最常见的第一反应,是憋着写一份覆盖所有情况的完整版,结果三天没动笔。方向反了,先上十二行能跑的,再随项目长。GitHub 工程师 Matt Nigh 分析过两千五百多份 agents 指令文件,结论就一句,最好的指令文件是迭代长出来的,不是一开始规划出来的。
十二行装三段。开发命令段,列出装依赖、跑测试、检查代码三条真实命令。项目结构段,标出源码目录、测试目录、自动生成目录,自动生成的那类注明永不手改。边界段,写明永不直接推送 main 分支、永不提交含密钥的文件。
就这十二行,至少挡住三类最常见的翻车,跑错命令、改错目录、乱推 main。老雷提醒一句,照抄结构可以,三条命令必须换成你项目的真实命令,AI 会把这份文件当事实读,写错一条它就按错的跑。
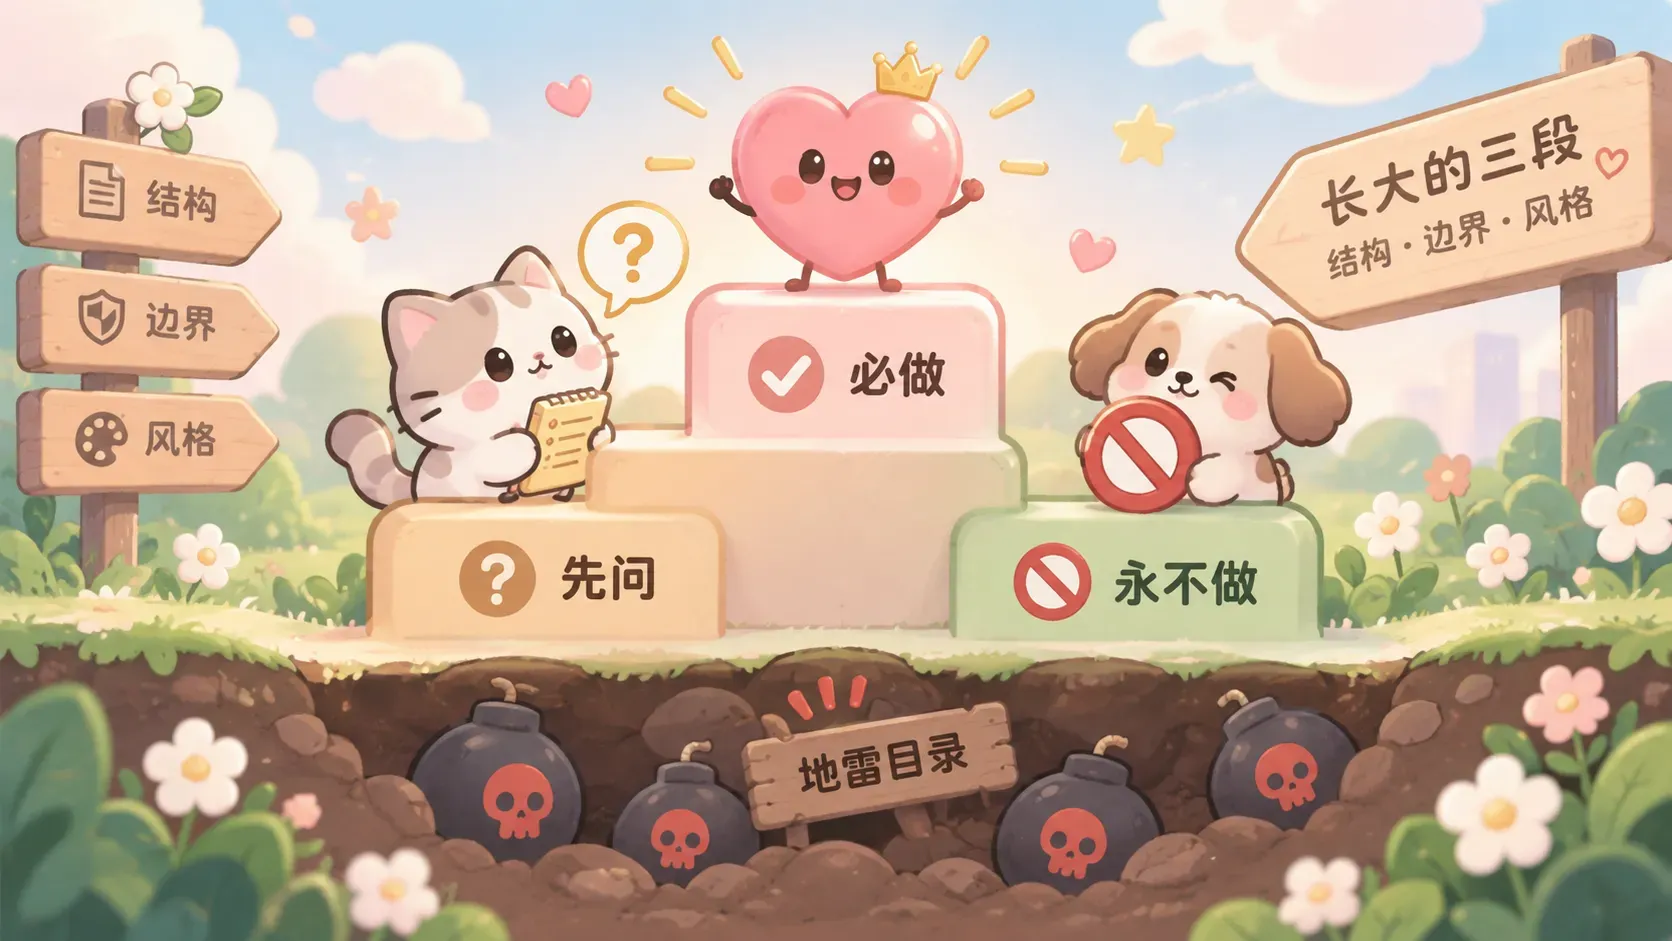
长大的三段,结构边界和风格
跑一两天你会发现 AI 还是越界,该问的不问直接改了,把自动生成的目录翻了个底朝天。这时候补三段。
项目结构段往细里写,重点不是列全每个目录,是标出地雷。src/generated、自动生成的 UI 组件这类「改了白改还会引发别的问题」的目录,AI 自己看不出来,必须你告诉它。
边界段是整份文件里判断密度最高的地方,写成清晰三档。必做档,每次提交前必须跑的检查命令、commit 信息的格式要求。先问档,增加新依赖、改数据库模型、动构建和 CI 配置之前,先停下来问你。永不做档,直接推 main、提交含密钥的文件、改自动生成的目录。每条都用命令式语言,能验证。AI 对命令的执行率远高于「最好别」「尽量别」这种模糊提醒,「注意代码质量」等于没写。前面引用的那份两千五百仓分析里,出现频率最高的有用约束也是最直白的那句,永不提交密钥。
代码风格段是新手最容易写跑偏的地方,HumanLayer 团队有句话值得逐字记住,永远不要派一个大语言模型去做代码检查工具的活。凡是 ESLint、Prettier 能自动检查修复的规则,缩进、引号、分号、import 顺序,一条都别写进来,又慢又贵还占上下文。AGENTS.md 该写的是工具查不出来的判断,比如状态管理统一用哪个库别再引入新的,数据库操作必须走哪个单例文件,业务错误用哪个自定义类。这三条 linter 永远管不了,因为它们要求懂项目背景。
顺手再补一小段测试约定,治「自以为干完了」的毛病。改完代码必须跑相关测试,全过才算完成。最关键的是这条硬约束,永不为了让测试通过而删除或跳过失败的用例,要删先问。这种破坏性偷懒一旦发生很难察觉,提前堵死。
模糊的提醒等于没写,能验证的约束才挡得住翻车。
仓库大了分层,工具多了靠导入
项目长成前后端分离的单体仓库后,一份根目录的文件就不够用了,前端要 React 的规则,后端要数据库的规则,混在一起互相打架。
Codex 的解法是层级合并。每次启动会话,它从全局目录开始找,然后从 Git 根目录一路向下走到当前工作目录,每一层各取一份,从根往下拼接,越靠近当前目录的内容排得越靠后、优先级越高。三份叠加,不是只读最靠近你的那份,仓库通用规则依然生效,子目录规则只在冲突时优先。前端改不到后端的规则,目录层级天然成了权限边界。
两个进阶机制记一下。同层目录里如果有 override 文件,Codex 在这一层只读它不读同层的常规文件,但上级目录的规则照常合并,它是取代本层,不是整条链全部作废。老项目用了别的文件名不想改,在 Codex 的配置里加一行回退文件名声明,旧仓库零改名接入。另外合并后的内容有大小上限,官方默认三十二 KB,超出被静默丢弃,几十行的文件碰不到它。真触顶了也别急着调大上限,那是治标,文件越长 AI 对每条规则的注意力越散,正解是通用规则留根目录、专属规则下沉子目录。
跨工具是个高频困惑。Claude Code 读的是 CLAUDE.md,不读 AGENTS.md,官方文档原文写得很清楚,agents.md 的支持列表里也确实没有它,这不是找不到时的回退,是根本不在查找路径里。同时用两家工具的做法有二。官方推荐在 CLAUDE.md 里用 @ 导入语法把 AGENTS.md 引进来,下面还能补 Claude 专属的指令。不需要专属内容就直接做一个软链,让 CLAUDE.md 指向 AGENTS.md,磁盘上一份真实内容,两边读的文件名不同、内容零漂移。注意方向,新手先建 AGENTS.md 再软链,别反过来,Windows 上软链要管理员权限,官方建议直接用导入。
当活文档养,让 AI 起草你拍板
写完归档是它烂尾的开始。这份文件是活文档,维护动作只有两个信号。AI 反复犯同一个错,犯到第二次就加一条规则。某条规则项目里已经不适用,删掉,否则 AI 还按旧的做。加了规则它还是忽略,就挪进永不做档让它更显眼,或者拆成更短的单句。
多短算短,有两个有出处的参照。HumanLayer 团队自己的根级指令文件不到六十行,主张指令越少越好。Anthropic 对 CLAUDE.md 的官方建议是控制在两百行以内,更长会消耗更多上下文、降低遵循度。两个数字指向同一件事,短的永远比长的好,维护的核心动作是删,不是加。老雷自己的习惯是把全局那份硬性卡在两百行以内,超出的一律下沉到具体项目,文件越是被逼着删,AI 每次读到的就越是此时此地真正相关的几十行。
能不能让 AI 自己生成这份文件。能,Claude Code 的 init 命令可以扫一遍项目出一份草稿,但出来的东西必须自己过一遍。命令可能是它猜的,看着合理但和项目真实命令对不上,这种错最坑,我拿到草稿会先把每个命令在终端里跑一遍,对不上当场改。草稿还容易堆套路话,把可能有用的全塞上,稀释你真正想强调的规则。正确姿势是 AI 起草当骨架,你核对每个命令的真实性,删掉空话,补上只有你知道的约束,哪个目录是地雷、哪条业务规则不能破。它是起草工,拍板的编辑是你。
收尾前带一句安全。安全公司 Pillar Security 在 2025 年披露过一类规则文件后门,攻击者在指令文件里塞 Unicode 隐形字符注入隐藏指令,因为这类文件的内容会直接进入 AI 的指令上下文。从陌生仓库抄 AGENTS.md 之前一定先看一遍内容,自己的这份变更走代码评审,把它当代码对待。
收个尾。第一份今天就写,十二行就够,装依赖、跑测试、检查代码三条命令,标出地雷目录,写上两条永不。之后每踩一个新坑,回来加一行;每季度回头删一遍,把不再适用的规则清出去。AI 从老犯错到越用越准,差的从来不是一份大而全的文档,是一份肯随项目一起长大的文件。