老雷AI实验室
给项目选 AI 语音,先查许可证再看音质榜
先听两段 AI 配音的想象实验。一段,你几乎听不出是机器,停顿自然,语气里还有情绪起伏。另一段,一开口就是熟悉的导航腔,每个字都标准,每个字都没有人味。
大多数人把差距归因于工具好坏。错了一半。真正的分水岭在选型,选错了技术路线,后面怎么换工具都是在错误的赛道上跑步。老雷帮企业做 AI 选型这几年,见得最多的浪费就是这里,模型选了半个月,路线一开始就是错的。
这篇不讲代码,只讲三件事,路线怎么分、筛子怎么设、名单怎么缩。给的是一张选型的决策地图。
先分清三条路线
AI 语音这块地图上,主流的板块有三个,外加一类集成套件。
第一条路,文本转语音,就是常说的 TTS。文字进,声音出,手机里的 Siri 和小爱同学背后都是它。早期的机器味来自拼贴,把预录的音素一段段接起来。现在的模型用神经网络直接学人类语音的波形,自然停顿、恰当语气甚至情感变化都能做出来。流程拆开看是两步,先像语言学家一样理解句子结构和韵律,再把分析结果画成声音的图纸,交给声码器合成音频。
第二条路,声音克隆。给几秒目标人的录音,模型从无到有生成这个人从来没说过的内容。做个性化配音、多语言内容,走这条。
第三条路,语音转换。注意输入变了,不是文字,是一段已有的源音频。做的事是换声,把 A 唱的歌变成 B 的音色,情感和节奏全保留。AI 翻唱、实时变声都是这条路,社区里最流行的是 RVC 这个工具,十到二十分钟的干净录音就能训出一个效果不错的模型,社区还沉淀了成千上万个现成音色。
三条路解决三个不同的问题。先问自己要做的是哪件事,再去挑工具,顺序不能反。
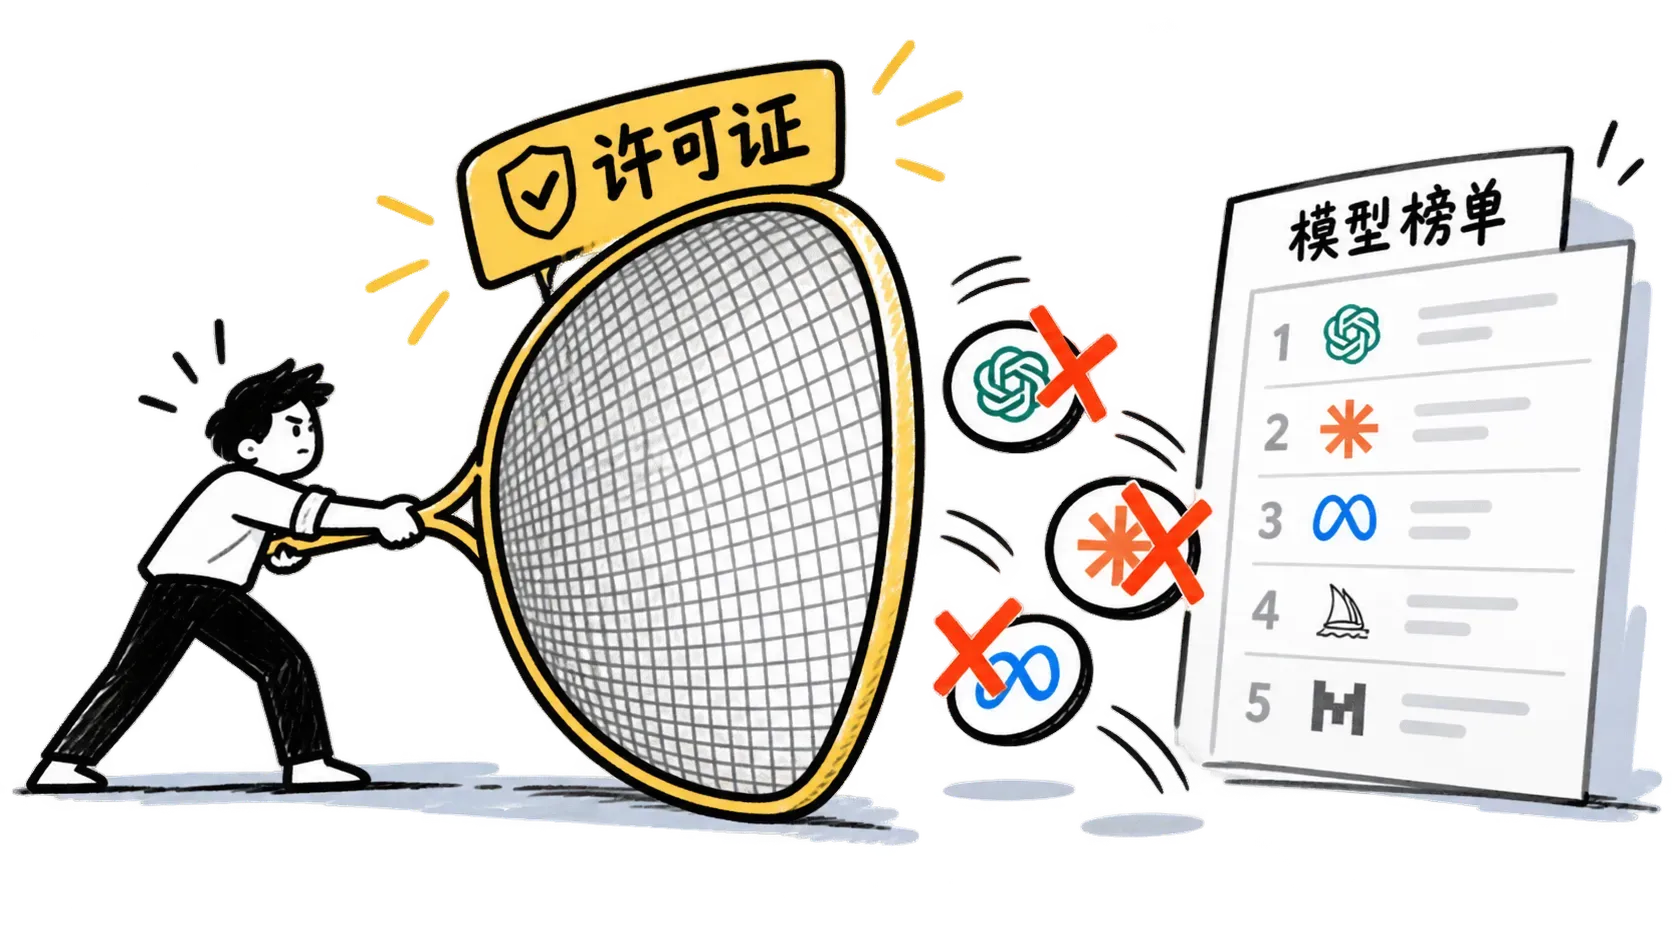
第一道筛子是许可证,不是榜单
这一条被太多团队忽略,老雷把它放在筛子的第一位。一个模型技术再强,许可证不允许你的用法,一切都是白忙。
这里有个最容易踩的深坑,同一个项目,代码和模型权重的许可证可能不一样。很多项目代码用宽松的 Apache 2.0,模型权重却挂非商业许可。GitHub 首页那个显眼的 Apache 徽章,可能只代表代码那一半。拿去商用之前,两个都要单独确认,这条应该写进每个技术评估的检查清单。
许可证大致分几档。MIT 和 Apache 2.0 可以商用,Apache 2.0 还额外送专利保护。CC BY-NC 系列明确不可商用,注意 Fish-Speech 和 F5-TTS 这两个明星项目的权重都挂的这个。AGPL 3.0 能商用但有传染性,你的代码也得跟着开源,ChatTTS 的代码就是这种。还有 CPML 这种自定义许可,XTTS-v2 挂的就是,不可商用。
拿着这把筛子过一遍榜单,会过掉几个名字,其中最扎眼的一个是 Fish-Speech,TTS-Arena2 榜单第一,情感标记丰富,社区口碑极好。但它的权重不可商用,做产品只能绕行,做研究随便用。还有一个隐性风险值得记一笔,XTTS-v2 背后的公司 Coqui 已经停运,项目没了维护方,这种模型哪怕许可证能过,长期押注也要掂量。
许可证不对,技术再强也是别人的技术。
商用阵营,挨个过一遍
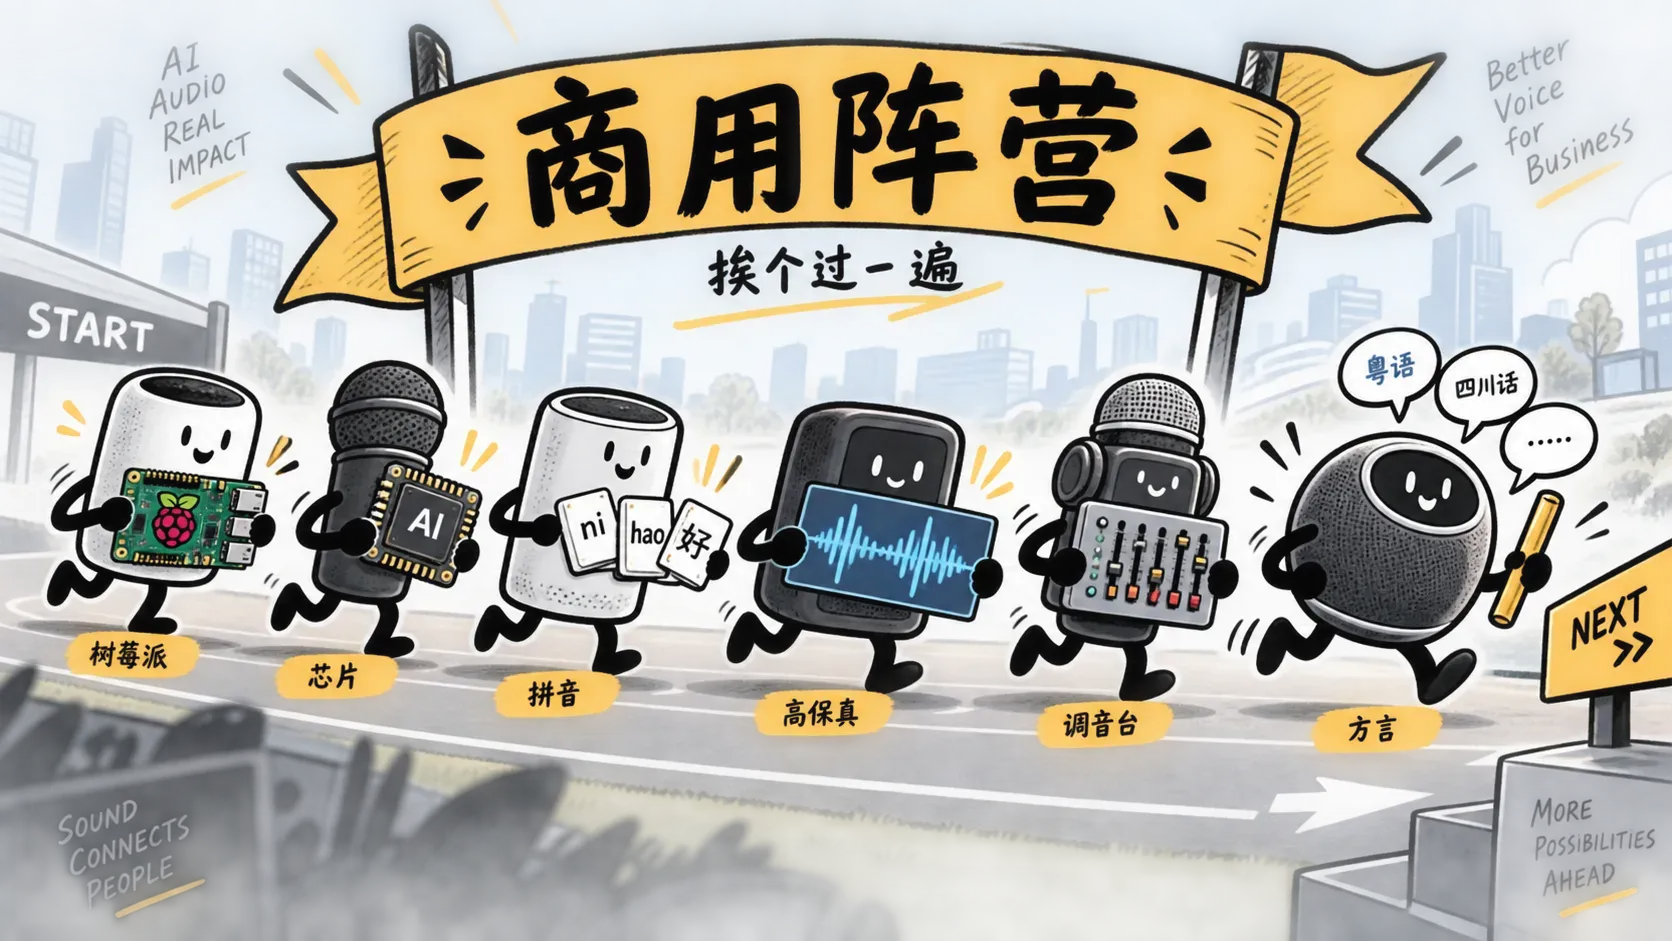
筛完许可证,商用的可选名单其实不长,六个能打的,按从边缘到主力的顺序过。
Piper,C++ 写的,树莓派都能跑,完全离线,MIT 许可。给智能家居和物联网设备配语音,它是性价比之王。
MeloTTS,CPU 上就能实时运行,中英混读,MIT 许可。服务器没有 GPU 的团队,先看它。
IndexTTS,B 站关联团队的出品,独创字和拼音的混合建模,专治中文多音字。项目面向中文用户、对发音准确性敏感的,它的位置没人能替。
MegaTTS 3,字节跳动的作品,参数只有 4.5 亿但克隆质量是顶级水准,中英双语,Apache 2.0。追求高保真离线生成,它是最强选项之一。
OpenVoice V2,MIT 完全可商用,绝活是克隆完音色还能调情感、口音和语速,等于给了配音一个导演台。拿自己的声音做有声书、每个角色情绪都不一样的场景,就是为它准备的。
最后压轴的是 CosyVoice 2,阿里达摩院出品,Apache 2.0 代码权重双商用。三项能力叠在一起目前没有对手,流式生成、150 毫秒首包延迟、支持粤语四川话上海话这些中文方言。做实时语音交互、AI 客服、直播场景,当前开源阵营里它就是默认答案。
顺带把声音克隆的预期校准一下。现在的零样本克隆,三到十秒高清录音就能到很高的相似度,背后的架构从自回归演进到流匹配和扩散,速度质量都是质的飞跃。但实测经验是,录音质量比录音时长重要,一段三秒的安静环境高清干声,往往胜过三十秒的嘈杂样本。要做克隆,先准备十到十五秒背景干净、发音清晰的语音,语速自然,别端着。还有一条红线,用名人声音做商业内容是法律灰色地带,商用项目只用自己的声音或拿到授权的声音,别赌。
开源还是买 API
名单缩完了,最后一层决策是部署形态。开源模型还是商业 API,答案不在音质上,开源在纯音质上已经追上来了,差距在三个看不见的地方,文档质量、服务等级协议和长期维护保障。
商业 API 的真正价值是版本锁定和向后兼容的承诺。做一个要长期运行的商业产品,开源模型可能在某次更新后出现不兼容,排查修复都得自己来,这种隐性人力成本在合同里看不见,账单上全是。
开源的杀手锏也有两个。一个是成本,部署在自己服务器上,长期运行的边际成本趋近于零。一个是数据隐私,所有音频留在本地,处理医疗录音、法律文件这类敏感内容时,数据不出服务器可能是决定性的选型因素。
实操上有两条成熟路线可以直接抄,老雷给客户做方案也是从这两条里挑。一条是混合策略,开发阶段用商业 API 快速验证方案,跑通后再迁移到开源自建,前期不浪费时间,后期成本可控。一条是双引擎,找个高品质的主方案再配一个低成本的免费备选,实测里有人用二十多万音色的 Fish Audio 商业版配微软 TTS 免费档,用户按预算自选,两条腿走路。中间还有个折中形态,SiliconFlow 这类国内算力平台提供按量付费的开源模型托管,不用自己买 GPU,按音频时长付钱,中小团队可以先从这里起步。
五步收口,一小时定案
把整套决策压成五步,照着走就行。
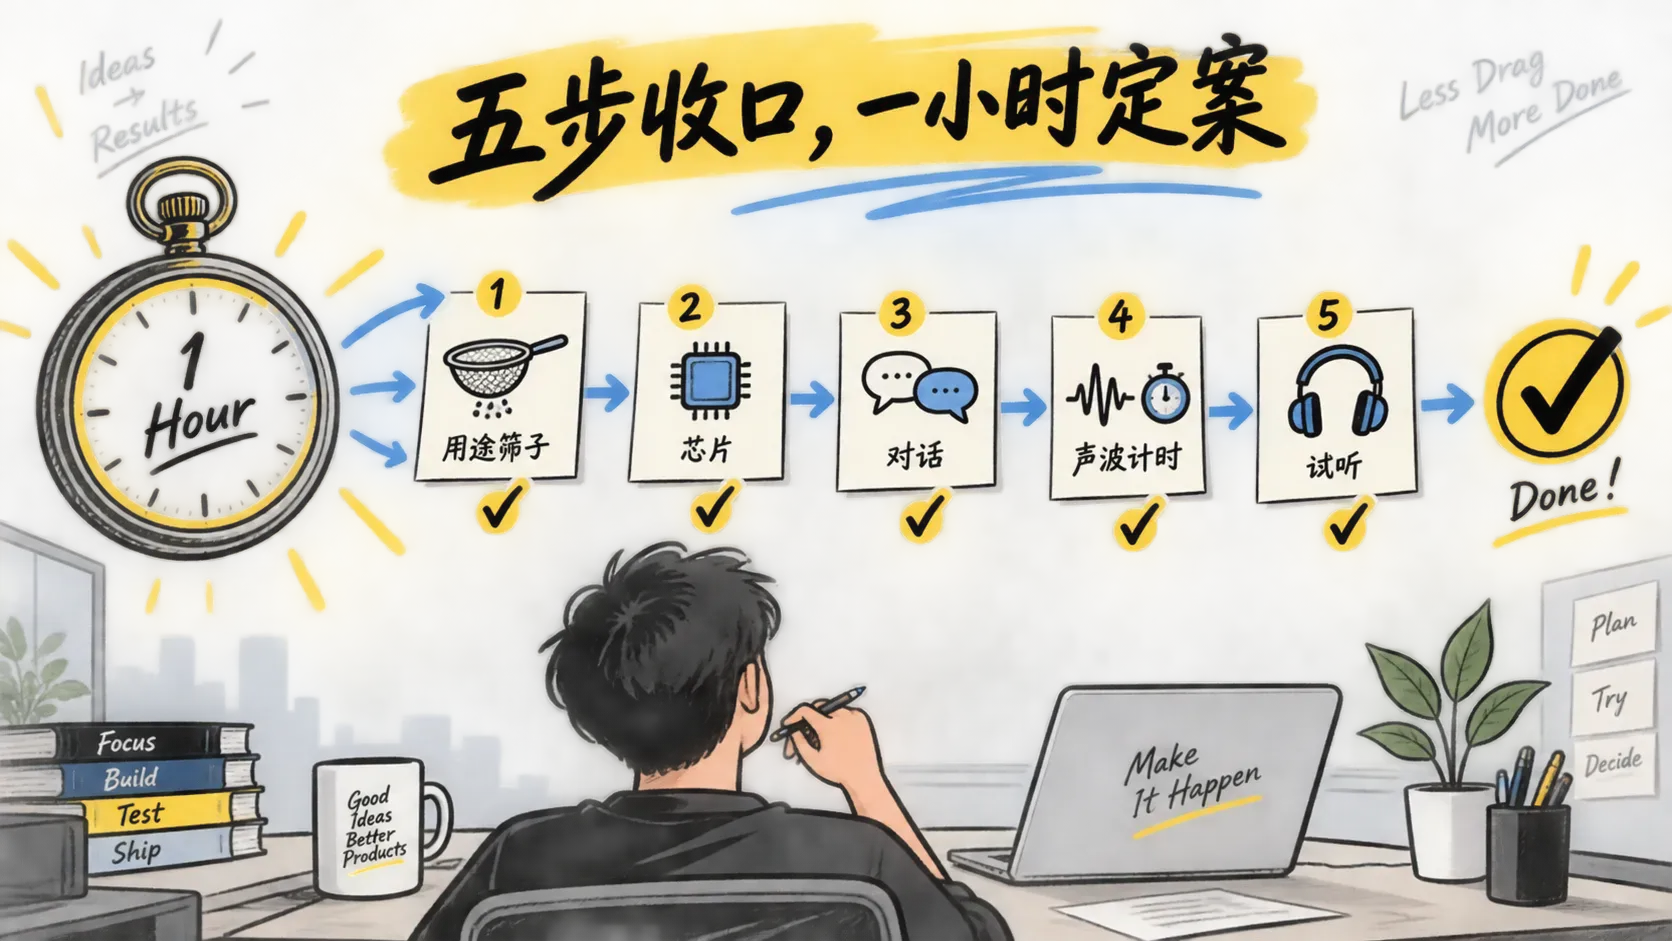
第一步,用途。商业产品直接用许可证筛,名单立刻缩到 CosyVoice 2、OpenVoice V2、MegaTTS 3、MeloTTS、IndexTTS 这几支。第二步,硬件。没有 GPU 就 MeloTTS 或 Piper,有 RTX 3060 以上的消费级卡,大部分模型都能跑。第三步,语言。中文多音字敏感选 IndexTTS,中英混读看 CosyVoice 2 和 MeloTTS,多语言需求注意 XTTS-v2 支持十六种语言但它不可商用。第四步,实时性。做实时对话,CosyVoice 2 的一百五十毫秒首包延迟是开源最快,做有声书这类离线批量,延迟不敏感,音质优先。第五步,实测。别只看论文和榜单,同一个模型在长句、短句、带数字、中英夹杂的文本上表现差异很大,拿你业务里最典型的文本去测,测出来的才是真的。
顺手提醒最后一公里,音频后处理。再好的模型生成的音频也不是成品,三件事要做,音量标准化,不同模型响度不一致,直接拼接听感很怪。降噪,某些模型句末带轻微电流音。格式转换,各平台对采样率要求不同。这套动作用 FFmpeg 能拼成自动流水线,不想碰命令行,Adobe Podcast 和 Descript 的在线增强也能顶。
还有一个趋势放在雷达上,端到端语音对话模型。传统的语音交互是识别、大模型、合成三段串联,每段都有延迟。新一代模型从语音进直接到语音出,GPT-4o 的语音模式已经演示了自然停顿和插话,开源社区的 Dia 也在跟进。要做实时语音助手,这个方向的权重该逐步加上。
最后给一个纪律,一小时原则。选型阶段给自己一小时,到点就定,立刻开始实验。选型追求的是够好,不是最好,模型的真实评价只有动手之后才形成,实验不理想再换,成本远低于在选型里无限纠结。
地图已经给你了,剩下的路要用嘴问出来,用耳朵听出来。
第一个实验,今天就跑。