老雷AI实验室
NCA Toolkit 实战清单,先把最小闭环跑稳再谈自动化
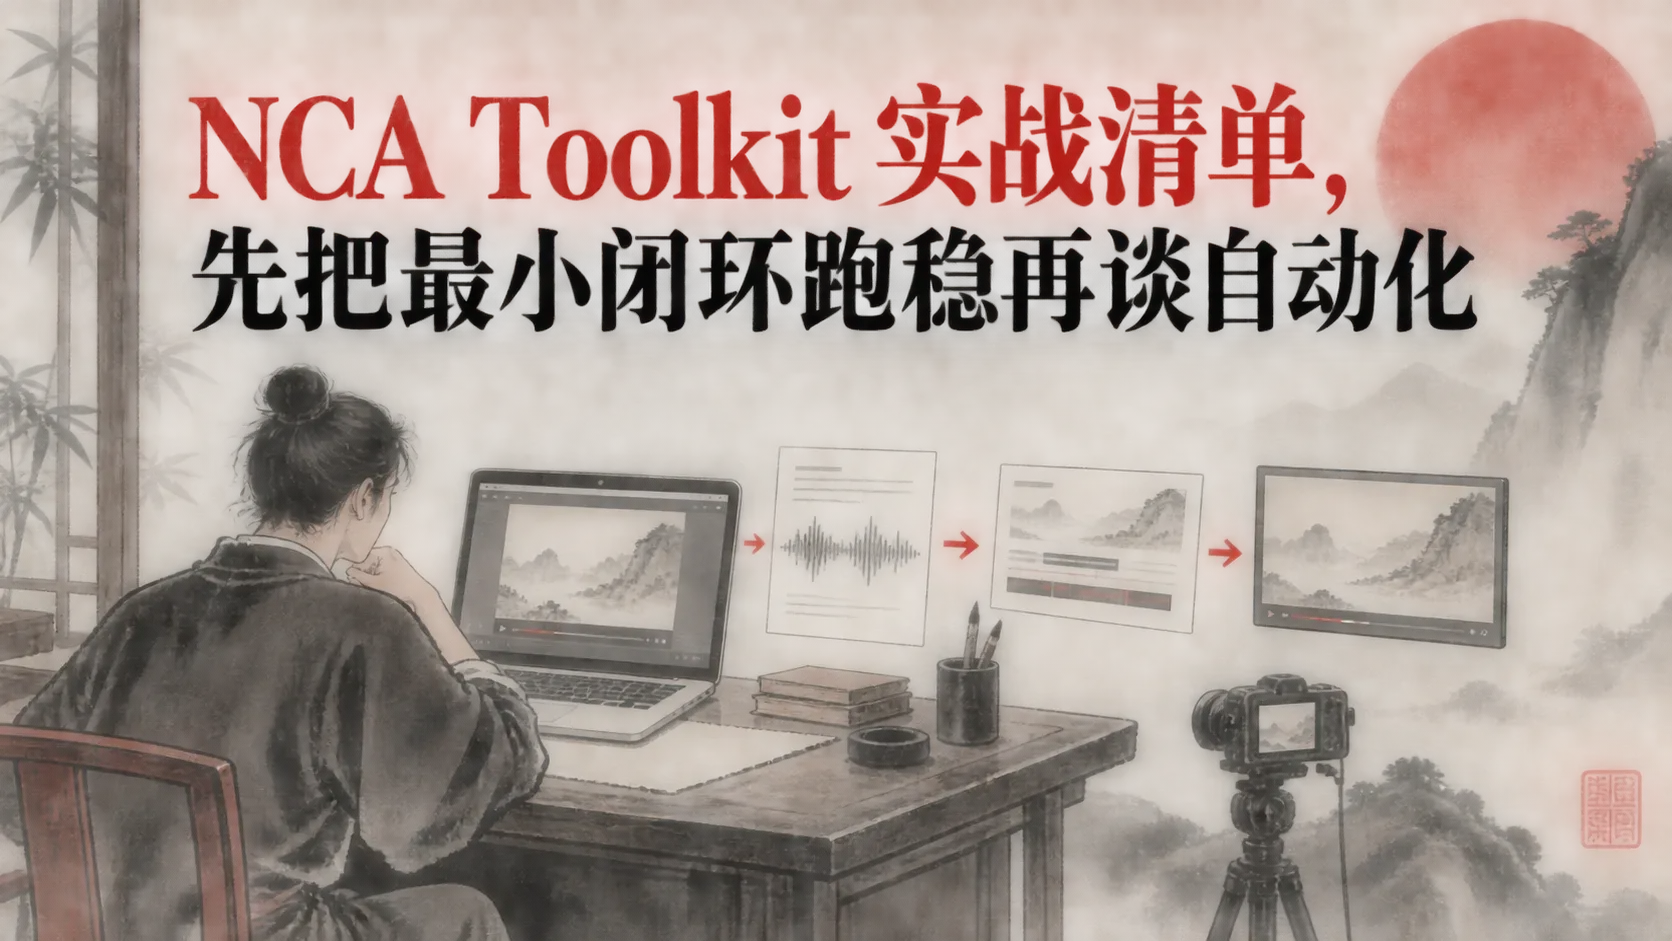
三个接口。/v1/toolkit/test、/v1/media/transcribe、/v1/video/caption。把这三个跑通,NCA Toolkit 你就算入门了,剩下那几十个接口,全是这三步的延伸。
没部署的朋友先去看安装,站内那篇 Cloud Run 部署清单接着用。这篇只谈用,谈怎么把它接进你的自动化工作流,以及哪些坑是源码里挖出来的。
先把身份说清楚。NCA Toolkit 是 Stephen G. Pope 在 GitHub 上开源的媒体处理 API 工具包,视频、音频、图片、字幕、转录、格式转换、云存储上传,全部封装成 HTTP 接口,n8n、Make、自建脚本都能直接调。它不是剪映、CapCut 那类可视化剪辑软件,也不是部署完就零成本的服务,软件开源,服务器、存储、带宽照常付费。
它的工作方式一句话就能讲完。你提交一个媒体 URL,它返回一个 job_id,处理完成后把结果文件放进你的云存储,回给你一个 URL。所有的接口,都是围着这个循环转的。
老雷把丑话说在前面,别一上来研究全部接口。这篇清单照做,三个任务跑通,你对它的理解就超过大多数只收藏不动手的人。
它真正值钱的地方,是把散在各家 SaaS 里的媒体处理能力,收进一个你自己可控的后端。
最小闭环,三个任务跑通再说
第一步,测环境。用 GET 方法请求 /v1/toolkit/test,请求头带上 x-api-key。这个接口会创建一个测试文件,上传到你的云存储,再把文件 URL 返回给你。它一口气验了鉴权、文件创建、存储上传三件事。这里失败的,别急着碰视频接口,先查 x-api-key 对不对、服务端 API_KEY 环境变量生没生效、存储桶在不在、服务账号有没有上传权限。
第二步,跑转录。POST 打 /v1/media/transcribe,请求体里给几个关键字段,media_url 放素材地址,task 设 transcribe,include_text 和 include_srt 打开,include_segments 先关,words_per_line 设 8 控制每行字数,response_type 新手先设 cloud,这样结果会变成 text_url、srt_url 这类文件链接,往 n8n 下游节点一挂就能用。再给 id 传一个自己的业务编号,对账查日志都方便。
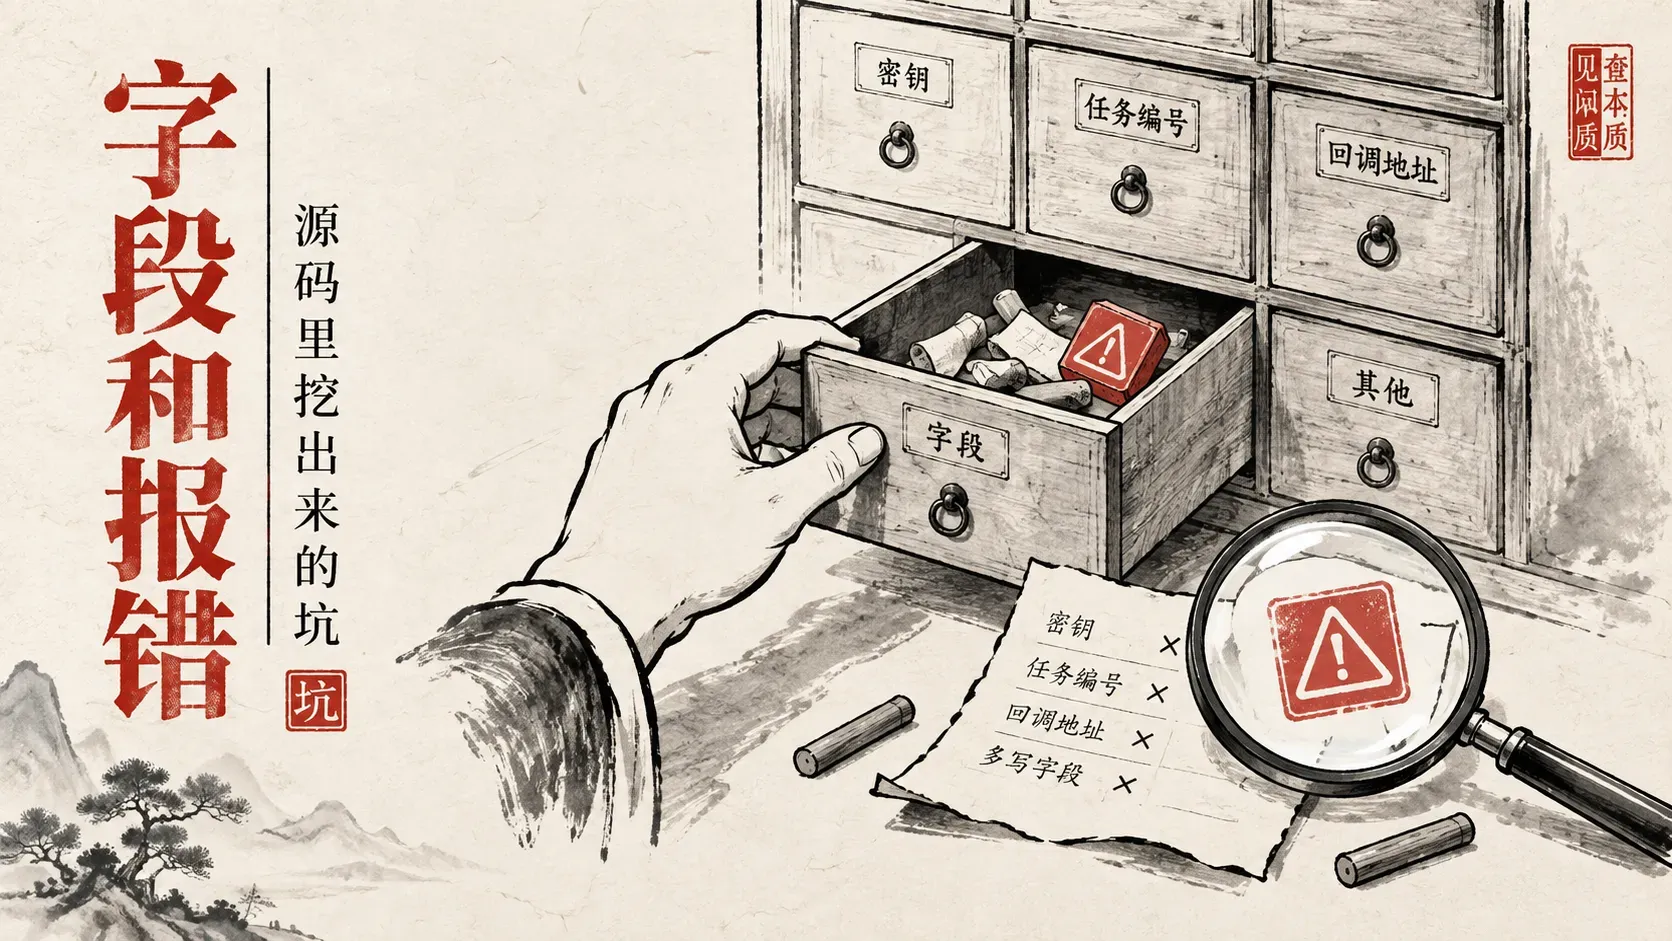
这里有个字段的坑,我对照 main 分支源码核过。官方文档个别位置写过 max_words_per_line,但当前转录路由 schema 收的字段是 words_per_line,而且接口普遍设置了 additionalProperties 为 False,多写一个不存在的字段不会被忽略,会直接给你甩回一个 Invalid payload。
第三步,烧字幕。POST 打 /v1/video/caption,video_url 给视频,captions 给字幕,这个字段可以传纯文本,也可以传字幕文件的 URL。样式在 settings 里配,style 用 classic,position 用 bottom_center,字号、字色、描边色都有对应字段,够用了。不传 captions 它也会自己从音频生成字幕再烧录,但我的建议是调试期先传一个确认能访问的字幕文件,把字幕生成和视频烧录这两件事拆开判断,哪步出问题一测便知。旧教程里的 subtitle_url 别再用了,当前 schema 收的就是 captions。
这三步通了,你手里就有了一条最短的可用流水线,后续的下载、剪切、拼接、缩略图,全是在这条线上加节点的事。
n8n 里拆成四段,别一锅炖
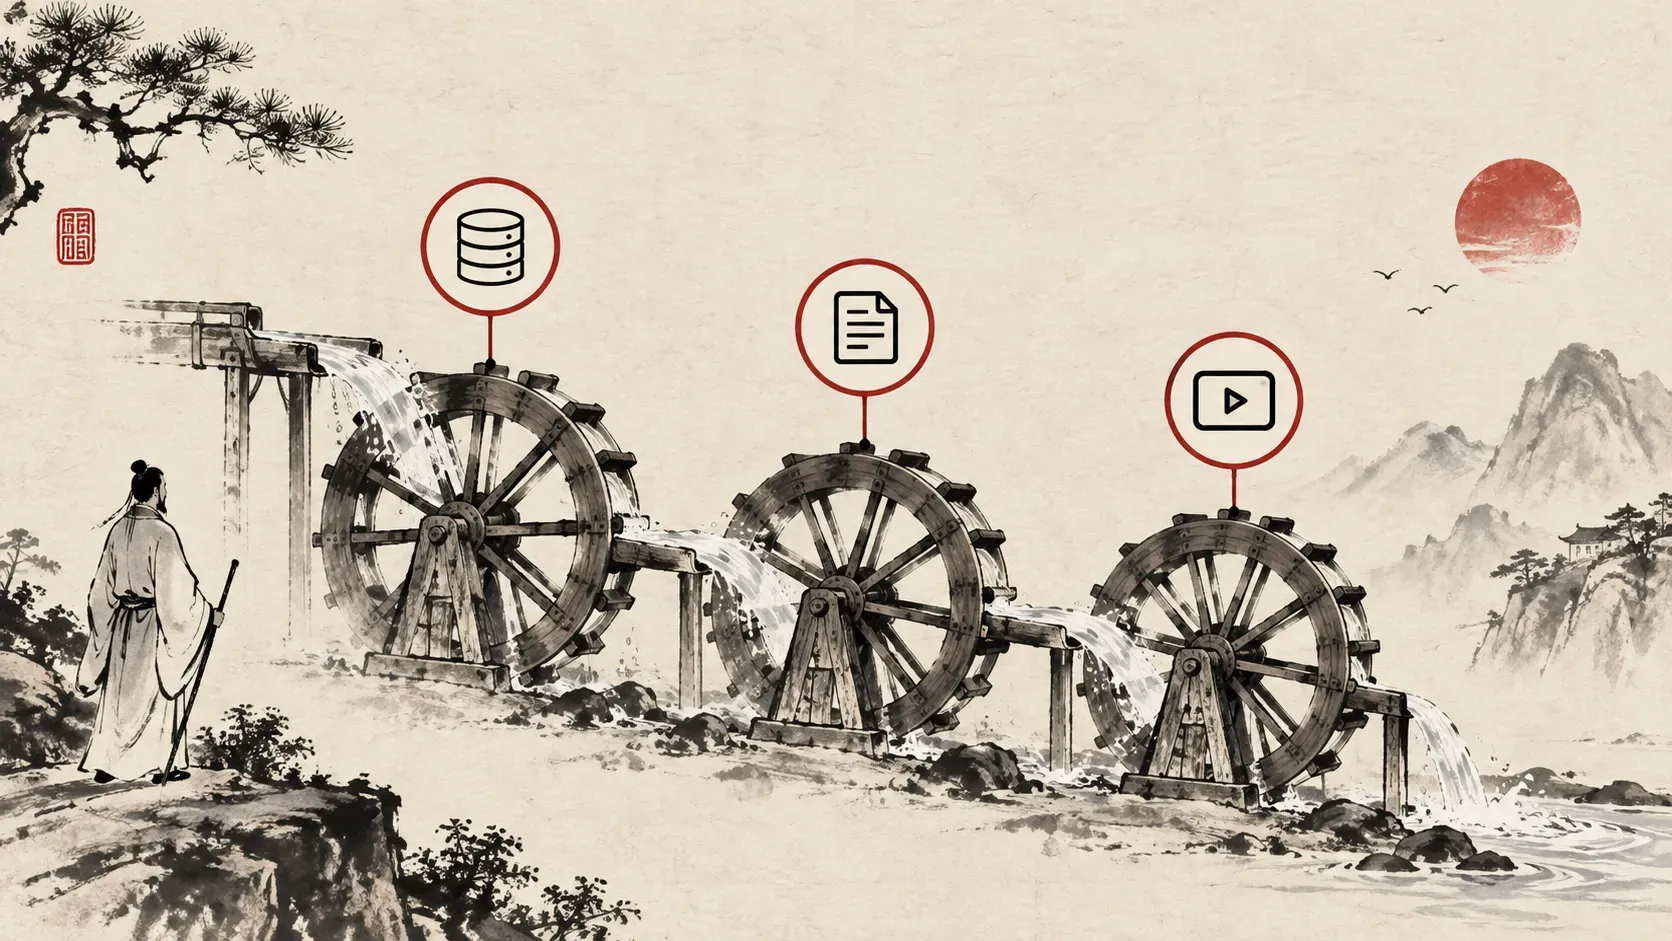
老雷见过把整套流程塞进一个大节点的工作流,炸的时候连从哪查起都不知道。稳的接法是拆成四段。
触发段。Webhook 收视频地址,或者表单提交素材链接,或者定时扫描对象存储,再或者从 CMS、Notion、数据库里读待处理任务,入口按你的业务挑。
处理段。HTTP Request 节点调转录接口生成文本和字幕,中间插一个翻译节点处理字幕文本,要求高的场景加一步人工校对,然后调烧录接口把字幕压进视频,需要音频就再补一个转 MP3 的调用。生产环境里,环境检查那一步可以省。
等待段。传了 webhook_url 的,用 n8n 的 Webhook 节点接回调,注意挂生产 URL,测试 URL 一关回调就石沉大海;没传的,把返回的 job_id 存下来,用 /v1/toolkit/job/status 轮询。每个等待分支都要配超时和失败分支,别让工作流无限等下去。
发布段。把最终视频 URL 写回 Ghost、Notion 或数据库,字幕、转录文本一起归档,然后通知人工审核。审核这一步别省,别让结果直接自动发布。
关键从来不是节点多,是每一步的输入输出都明确,哪步失败就只查那一步的请求体、响应和日志。
字段和报错,源码里挖出来的坑
这份清单我建议对着用,都是实测和源码里验证过的。
x-api-key 放请求头,不放请求体,这是 401 报错的第一嫌疑。id 和 job_id 不是一回事,前者是你自己传的业务标识,后者是 Toolkit 生成的任务 UUID,查状态用的是后者。长任务务必传 webhook_url,接口会先回一个 202 processing,真正结果走回调,或者你拿 job_id 去查。还有 task 设 translate 那个,在 Whisper 场景里是翻成英文,不是任意语言互译,做中文字幕老老实实先转录,再交给翻译节点,末了烧录。
报错速查对着看。400 Invalid payload 先查字段名,十有八九是多写了 schema 不认的字段。回了 202 却没下文,先查 webhook_url 是不是公网可达、是不是 n8n 的生产 URL,有没有被防火墙拦住。测试接口失败,优先查对象存储配置,那一步压根还没轮到视频处理,具体就五处,x-api-key 对不对、API_KEY 生效没、桶在不在、服务账号有没有上传权限、桶里的文件后续工作流访问不访问得到。烧录失败,确认视频 URL 和字幕 URL 在服务器端都能访问,浏览器打得开不代表部署环境下载得到,私有链接和过期签名链接都会栽。长视频卡住,先剪个 30 秒样片跑通再上正片,别拿两小时的片子测试部署。
接口目录,按需取用
闭环跑通后,按业务挑接口,别贪多。
基础检查这一组,/v1/toolkit/authenticate 验 key,/v1/toolkit/job/status 按 job_id 查单个任务,/v1/toolkit/jobs/status 看近期任务,排障全靠它们。字幕转录这一组,除了闭环里那两个,还有 /v1/media/generate/ass 能生成 ASS 字幕样式,要更细的字幕控制用它。
视频处理这一组,/v1/video/thumbnail 从指定时间点截缩略图,/v1/video/trim 保留一个时间段,/v1/video/cut 删掉一段或多段,/v1/video/split 按多个时间点拆分,/v1/video/concatenate 拼接,切片拼接的活儿基本齐了。音频和媒体这一组,通用格式转换、转 MP3、音频拼接、读时长分辨率码率的元数据接口、静音检测,都有现成的。
下载和截图这一组,/v1/BETA/media/download 底层是 yt-dlp,支持选格式、抓字幕、带 cookie,但平台风控、地区限制、年龄限制、登录态都会影响结果,别把它当成永远下得动任何平台的万能接口。网页截图走 Playwright,静态图还能转视频。老雷的建议是每组挑一个先跑,跑通的才有资格进工作流,一口气全上只会把排错面铺得很大。
高级能力这一组,/v1/ffmpeg/compose 用结构化 JSON 组合滤镜和输出参数,/v1/code/execute/python 直接远程跑代码。能力很大,写错参数的代价也大,安全面更得盯紧,新手头一个礼拜别碰。
部署放哪,边界在哪
先说它适合谁。经常做视频转字幕、提音频、切片、拼接、转格式,手工倒腾开始浪费时间的内容创作者;已经在用 n8n 或 Make,想把视频处理挂进工作流的自动化用户;不想同时订阅一堆媒体 API、也不想让核心素材全过第三方 SaaS 的团队。这三类人,这套工具值得一个下午。
学习测试期用 Google Cloud Run,上手快,跑通接口、存储和 n8n 调用足够了。但要长期处理长视频、大文件、高并发,更稳的归宿是 VPS 或专用 Docker 主机,媒体处理这活儿吃 CPU、吃内存、吃磁盘和网络。存储不绑 GCP 也行,它支持 S3 兼容存储,S3_ENDPOINT_URL、S3_ACCESS_KEY、S3_SECRET_KEY、S3_BUCKET_NAME、S3_REGION 一套配齐就能换。
官方 README 里点过两个限制。DigitalOcean 这类平台上请求超过 1 分钟就得靠 webhook_url 绕开代理超时,Cloud Run 对 5 分钟以上的长任务可能不稳定。部署时把几条规则钉死,API_KEY 用随机长字符串,LOCAL_STORAGE_PATH 指向空间够的临时目录、默认走 /tmp 但别指望它,GUNICORN_TIMEOUT 按任务长度调大、300 秒起步,MAX_QUEUE_LENGTH 默认 0 是不限制、生产环境按机器资源设上限,输入素材先传到你自己的对象存储再把 URL 给它,公开桶只放成品,临时文件和中间产物定期清理。
也不是人人都需要它。偶尔剪一条短视频的,完全不想碰服务器、API Key 和对象存储的,要精细人工剪辑和审美判断的,剪映、CapCut、Premiere 会更省事,别为了自动化而自动化。
先把部署和存储跑稳,再把工作流拆小,批量自动化排在它们后头。
写到这里,清单给完了。第一天的动作可以小到只有五步,传一个视频到对象存储,调转录接口生成字幕,人工或模型校对一遍,调烧录接口压进视频,把结果 URL 写回你的数据库。这五步今天就能跑完。
下一条视频素材进来的时候,让它走一遍你搭好的流水线,字幕自己生成、自己烧录、结果自己归档。第一次跑通那一刻你会发现,自动化的门槛从来不在工具,在你肯不肯把第一个最小闭环跑完。