老雷AI实验室
批量生产提示词的 Make 工作流,坑都替你踩完了
先给你一个数。手写一条合格的结构化提示词,角色、目标、约束、输出格式一项一项填,快的话半小时,慢的能磨掉一晚上。这是我们实测下来的节奏,不夸张。
一次交付,这样的提示词你要多少条?
更要命的是手写没法复现。同一个需求,张三和李四写出来长两个样,同一个人今天和明天写又是两个样,验收没法复现,交接没法延续,这是根子上的麻烦。
老雷这两年帮企业做 AI 落地,见过太多交付团队卡在同一个地方。工作流的架子半天就搭通,真正吃掉工期的,是大模型模块里那几十条提示词。一条一条手写,写到第十条开始糊弄,写到第二十条,质量已经没法验收。
所以问题从来不是「会不会写提示词」,是「怎么把提示词当零件来生产」。
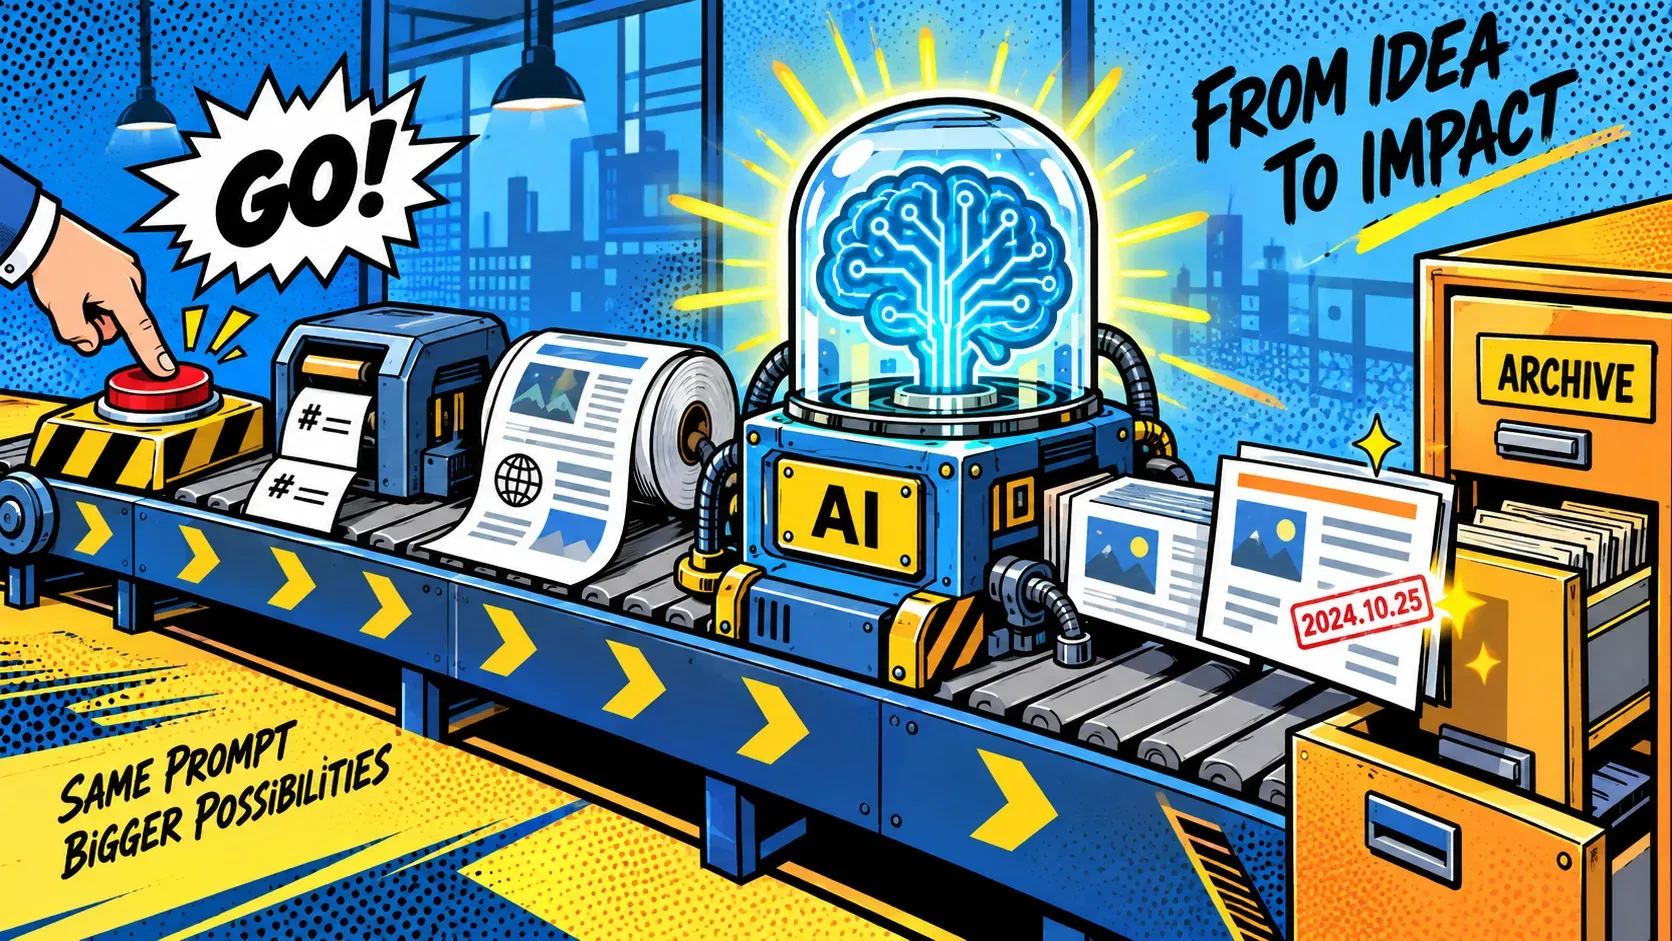
这篇文章拆的,就是老雷沉淀下来的那条提示词生产线。在 Notion 里点一下按钮,输入一句十来个字的需求,系统自动去互联网捞素材,调推理大模型写一条结构完整的提示词,解析、拼装、打上时间戳,存进知识库。人可以下班,机器在那儿出件。
先对齐,什么样的提示词算合格
去咖啡店买咖啡,你说「给我一杯咖啡」,店员多半要多问三句。你说「中杯美式,加两份糖,趁热,不要奶」,一次成交。提示词一个道理,区别是大模型不会多问你三句,它按它理解的来,错也照错。
合格的结构化提示词,拆开看就三块,主意图、属性约束、工作流程。往细里做,可以直接套现成框架,我常用的是开源项目 LangGPT,把角色定义、任务背景、关键概念、目标、技能、约束、输出格式、工作流程、初始化指令一项项列清楚,拼起来就是一份完整的岗位说明书。
为什么要费这个劲。因为在自动化工作流里,这条提示词的输出就是下一个模块的输入,它不稳定,下游全抖。
还有人觉得提示词这东西写到能用就行,何必框架化。账不能这么算。手写的提示词是个人手艺,人一走手艺就跟着走;框架化的提示词是产品,谁接手都能照着标准改。企业里要的是后者。
标准化才能自动化,自动化才能规模化。
这不是绕口令。验收的时候,客户不看你的提示词写得多漂亮,只看跑一百次是不是次次长一个样。
两条弯路,一条正路
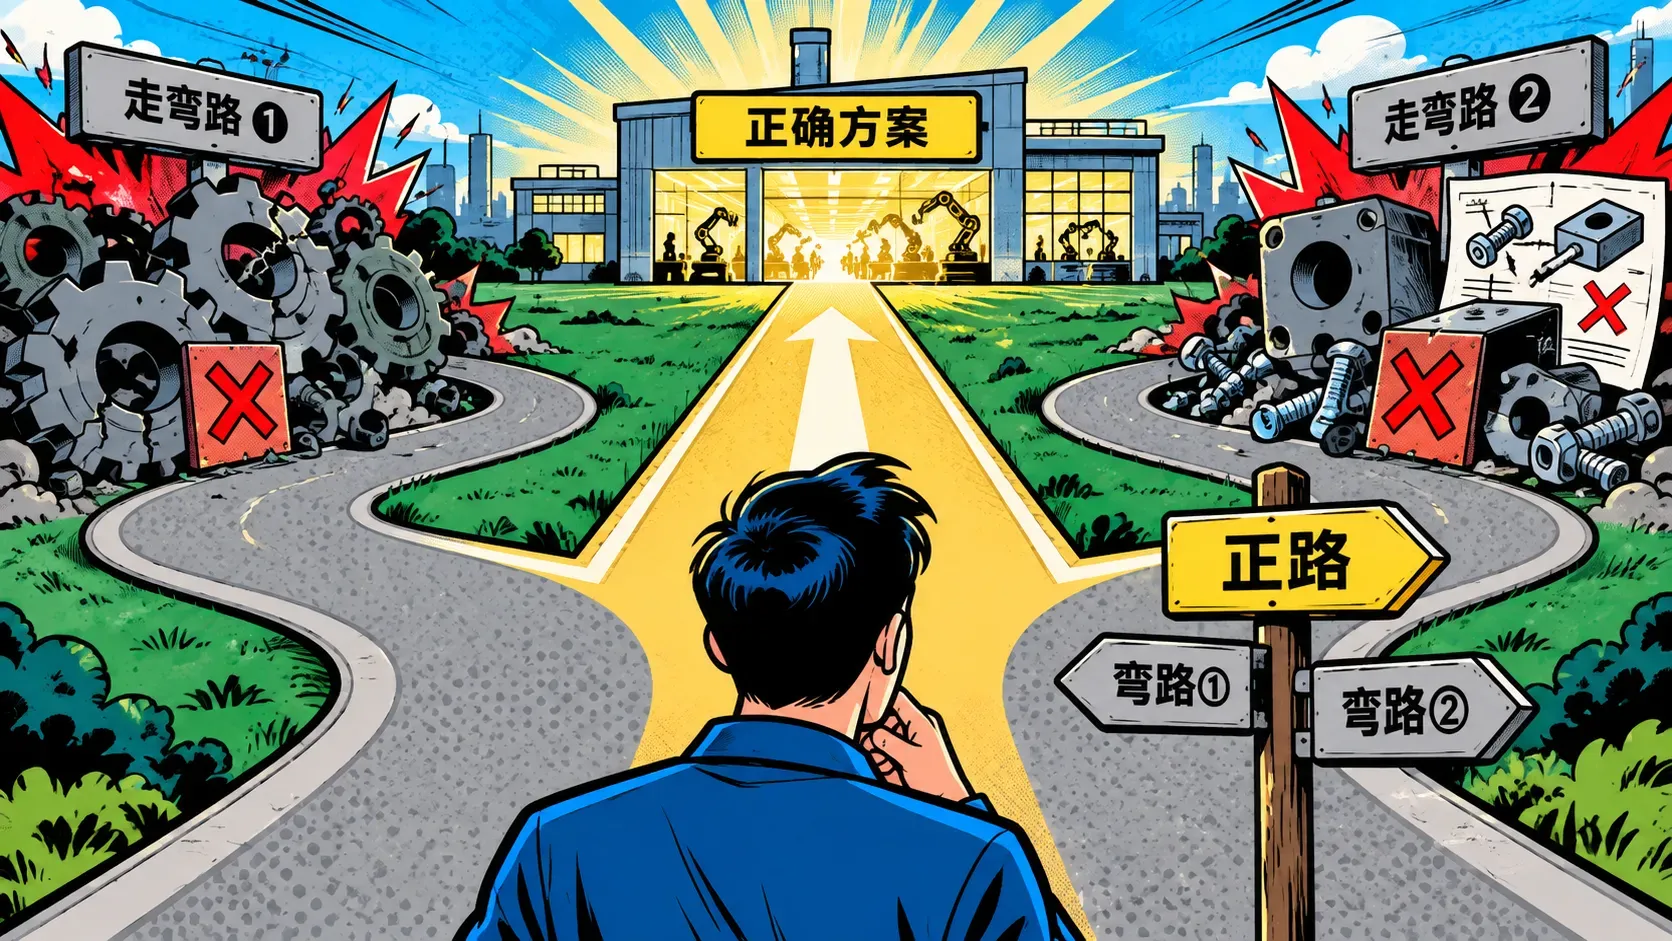
这条生产线不是一次设计出来的,前面废了两个版本,坑都替你踩过了。
第一条弯路,拿普通对话模型直接生成。你把提示词发给它,让它「帮我写一条提示词」,它不写,它直接执行。尤其你的提示词里带着输出示例的时候,模型会以为你要它扮演角色,呼哧呼哧把内容先给你输出了。任务没完成,它还一脸无辜。
第二条弯路,把框架拆开分别生成。角色一段、能力一段、目标一段,分开写再拼装。能跑通,但工作流复杂了一倍,各段之间没人负责协调,拼出来的东西经常前后打架,质量上不去。
这两条路看着都合理,所以格外费钱。前者坑在你以为模型懂了,后者坑在拼装那一刻才发现各段各想各的。判断一个方案行不行,别听它讲得多顺,跑十条看输出方差,方差一大,下游就没法接。
正路是第三条,用推理大模型。o1、o1-mini、DeepSeek R1、Gemini Thinking 这一档的模型,拿到提示词会先推理你的意图,分清楚你是要它执行还是要它改写,然后基于理解去创作。实测下来,输出统一,结构清晰,一步到位。整条生产线能不能成立,押的就是这个前提。
整条流水线,从一句需求到一条成品
正路定了,剩下的就是把五个环节串进 Make。按交付顺序讲。
触发端用 Custom Webhook 模块,钩子链接配进 Notion 的按钮字段,Make 侧开启数据到达立即触发。之后在 Notion 里点一下按钮,生产线就转,手机上也能点。
第二步,生成检索关键词。走 OpenRouter 原生模块,模型选 4o-mini,便宜稳定,任务是把用户那句需求翻译成中英文两路检索词,输出 JSON。这里有个容易漏的细节,这段指令要放在 System Prompt 里,不要放 User Message。一是系统提示词权重更高,二是以后要映射成 Notion 变量方便维护,三是复杂任务要渐进式给上下文,分步喂比一口喂稳。
第三步,去互联网捞素材。Make 现在内置了 EXA 原生模块,检索方式选 Keyword,结果数量给 3 条,Include Content 一定要打开,不然只回来链接没有正文,下游的大模型等于白等。三条结果用 Text Aggregator 按换行拼成一整段文本备用。
第四步是整条线的核心,推理大模型创作。还是走 OpenRouter,模型挂 o1-mini,预算紧就换 Gemini Thinking,免费,效果也在线。对话严格分三步,先发任务描述,等它回复收到任务;再发 EXA 聚合的素材,等它回复收到相关资源;第三轮才发提示词框架要求和生成指令。为啥要多此一举分三步,一口气把任务、素材、框架要求全塞给它,推理模型经常顾此失彼,要么漏看素材,要么抓错重点。拆成三步,每一步都让它回复确认,相当于强制它把上下文吃干净再动笔,质量就是这么一点一点稳下来的。配置上有两处要钉死,Automatic Fallback 必须关,防止请求被悄悄换成别的模型;Streaming 可开可不开,影响不大。还有,框架要求那一段提示词,一个字的变动都会影响产出,老雷当时反复调了很久才稳住,这一段别指望一次写对。
第五步,结构化收尾。推理模型的输出不保证是标准 JSON,再挂一个 o1-mini 把输出规整成结构化格式,过一遍 Parse JSON,角色、目标、约束这些字段就拆开了。收口用 Set Variable 按 Markdown 模板拼回一条完整提示词,打上时间戳,存进 Notion 知识库。
创作型和模仿型,路由上分两条路
实际交付里需求分两种。一种从零起一条新提示词,叫创作型;一种客户手里已经有一条参考提示词,想照着它的架子做条新的,叫模仿型。两条路在 Make 里用路由器分流,判断条件就一条,参考提示词字段是不是空的。空,走上路;有货,走下路。
模仿型的对话流程略有不同,而且藏着一个百试百灵的小技巧。先只把参考提示词发过去,附一句「下面是一个提示词示例,请先回复收到提示词示例」,等它真回了,再发新任务让它参照创作。先确认、再派活,这个预处理能确保模型理解你的意图是改写而不是执行,顺序反过来就翻车。这套确认机制其实贯穿两条路径,创作型那边的收到任务、收到相关资源,玩的也是同一个逻辑。
还有一点,模仿型路径不用开结构化输出。每个人给的参考框架都不一样,强转格式反而丢信息,原始输出直接存就好。
顺带把批量这件事交代了。需求本身就是 Notion 里的记录,记录天然就是队列,100 条需求和 1 条需求,对这条流水线来说只是排队长短的区别,触发和生成环节不用动。
交付前,把这几件事钉死
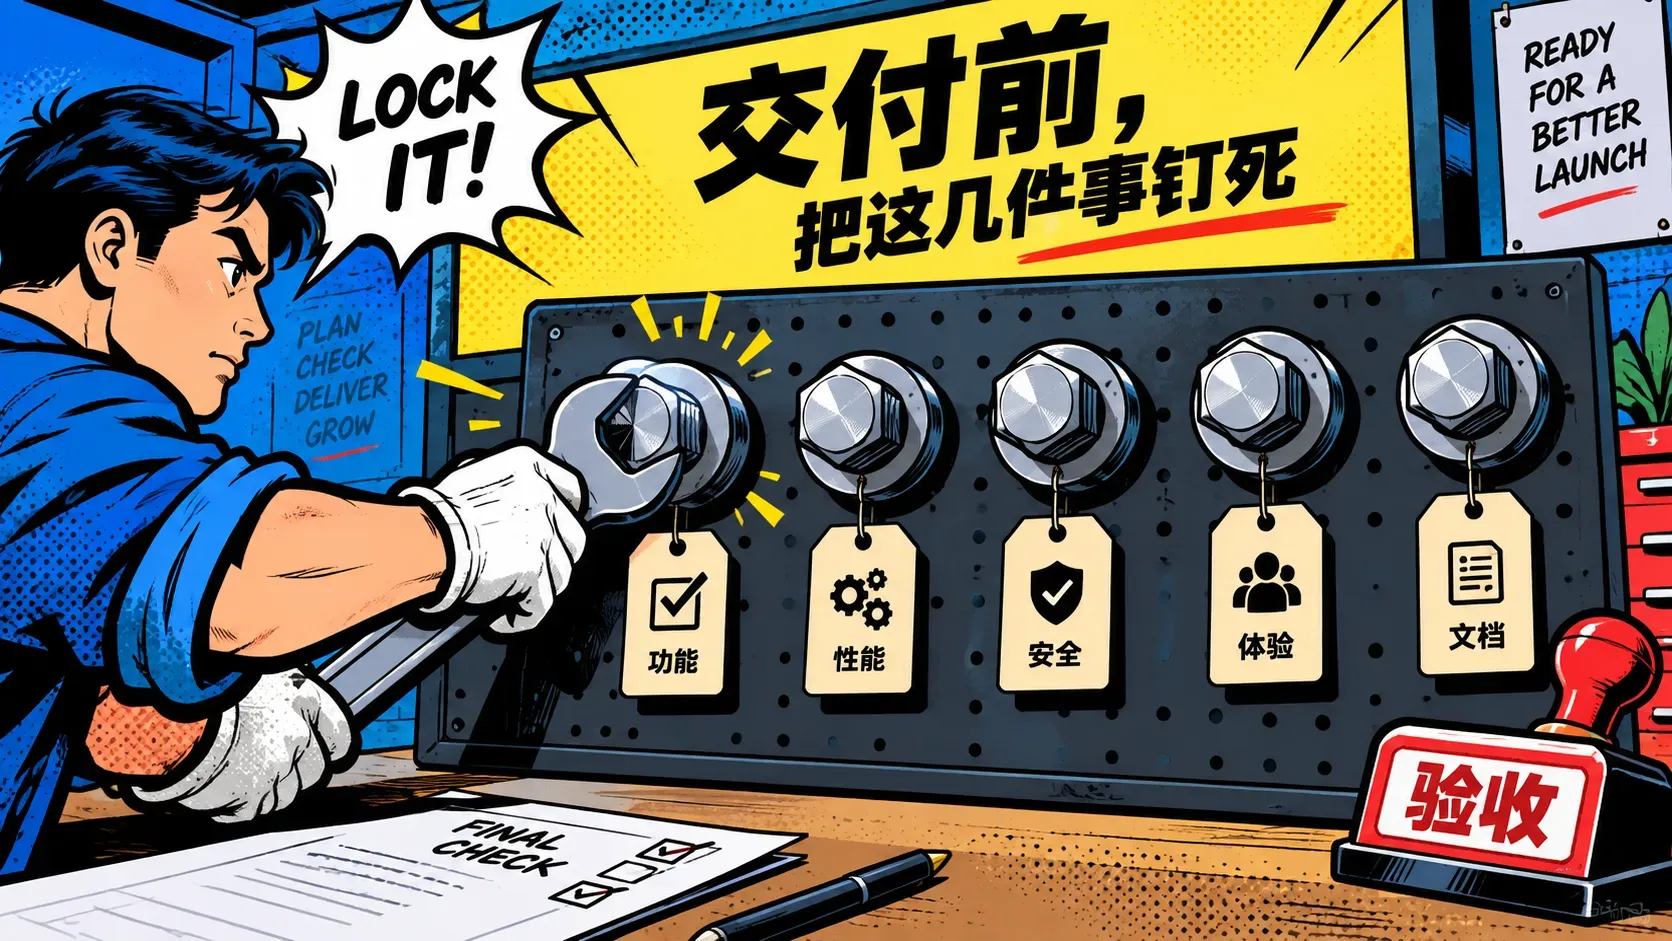
按老雷给团队定的自查单来,五件事。
Webhook 触发,在 Notion 页面上真实点一遍,确认数据到达即触发。EXA 配置,回看返回里有没有正文,只有链接就是 Include Content 漏了。Fallback 开关,去核心创作模块确认是关闭状态,这条最隐蔽,出了问题你还以为是自己的提示词写得差。推理过程,核心模型尽量选能看到思考轨迹的,验收时你能判断它是真理解了任务,还是在编。成本预算,用 o1-mini 跑,1000 条提示词的 API 费用大约几美元;换 Gemini Thinking 能压到零成本,代价是接受 Token 限额。
素材质量这个变量也要管。EXA 捞回来的东西不够好,先调关键词生成那条指令,让检索词更准;还不行,就把结果数量从 3 加到 5 到 10,多喂几口。
产出来的提示词也别让它们躺在库里吃灰。质量稳的,直接回填进各类自动化工作流当大模型模块的基础提示词;其余的按领域归档,下次同类需求先查库再造,重复建设能省一大半。
收个尾,说一句这套东西真正的价值。提示词库沉淀下来是团队的资产,换项目、换人,架子还在。分步对话、推理模型、素材检索、结构化输出,这套方法论里随便抽一条,都能搬去别的生成场景。这套东西跑下来我最大的感受是,提示词这件事门槛不在技巧在工程化,会写一条的人不少,能让它稳定量产的,才是真正的交付能力。
做交付的都懂,客户买的从来不是某一条提示词,是「你有一套稳定出件的办法」这件事本身。