老雷AI实验室
刷信息两小时记住三条,RSS 加自动化把这事儿治了
先问一个扎心的问题,你每天花多少时间刷信息。
微博看一眼,公众号翻一翻,行业群爬一层楼,再刷刷短视频,两个小时过去了,真正记住的有价值信息可能就三条。个人这么刷是浪费时间,企业这么刷就是拿工资买噪音。竞品上了什么新功能,行业出了什么新政策,海外有什么新技术动向,全靠有人恰好刷到、恰好记得、恰好转告,这条链路漏掉的比抓到的多。
问题的根子不在人不勤快,在信息获取的方式本身就是被动挨打的。而治它的工具老得超出你想象,RSS,1999 年就诞生的协议,这两年因为跟 AI 自动化撞出火花,正在变成企业搭信息情报线的地基。这篇把这套东西讲透,从概念到选型到自动化流水线,全是能落地的。
RSS 到底是什么
RSS(简易信息聚合)一句话解释,就是网站内容的更新提醒服务。
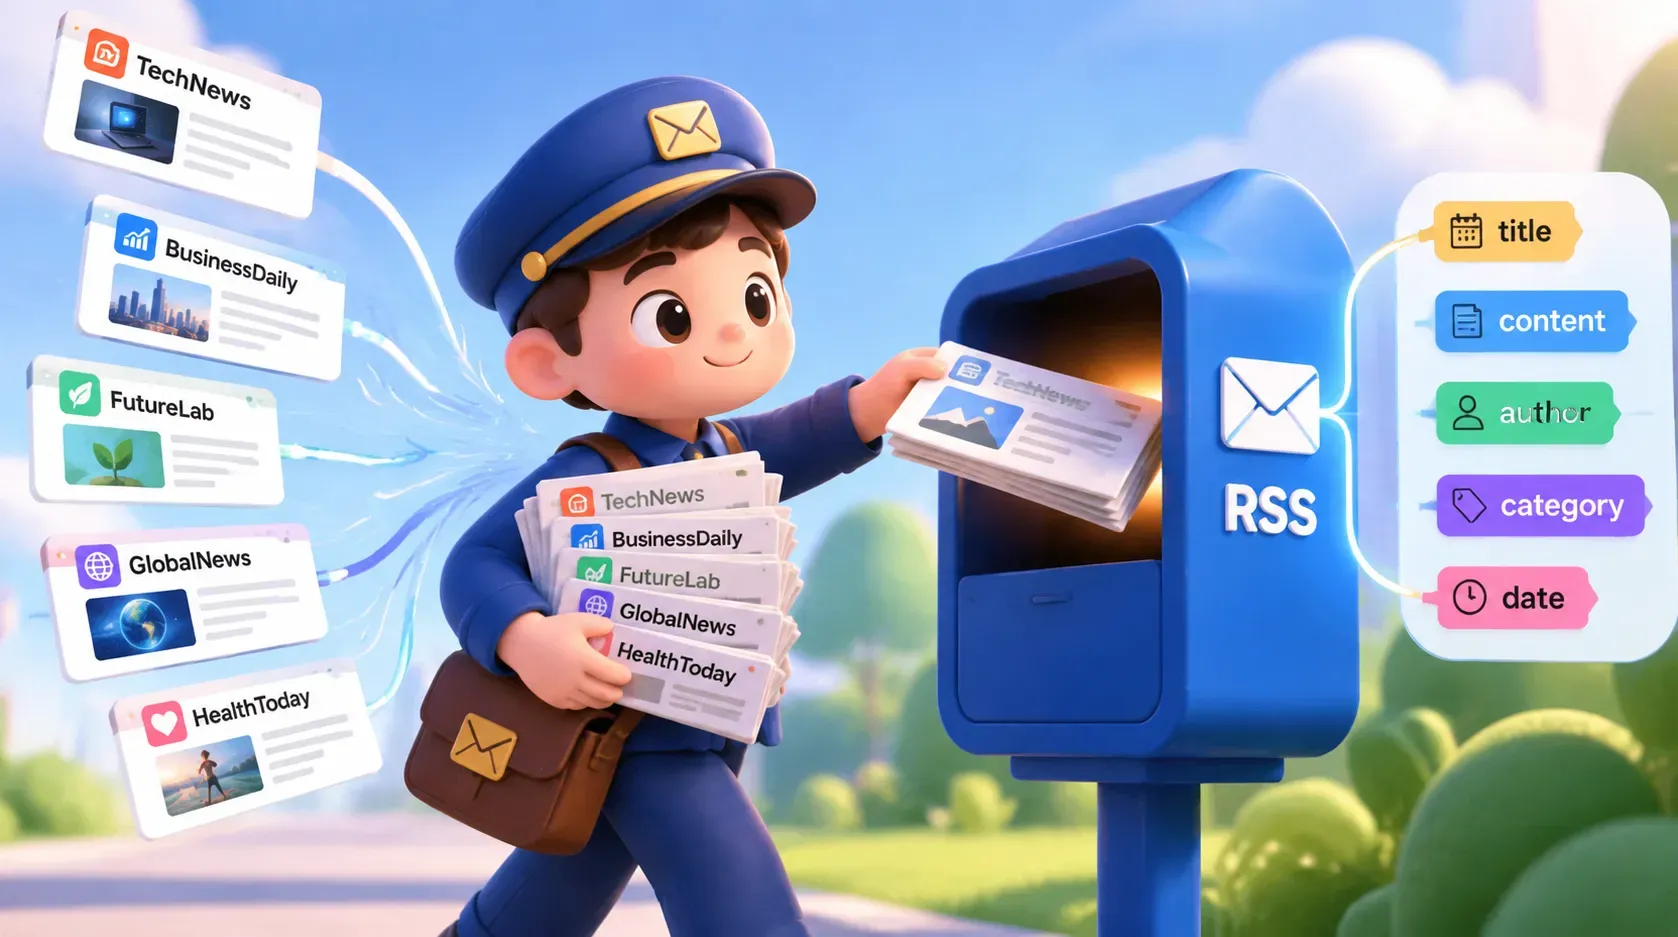
过去你想看报纸,得自己去报摊买。订阅报纸之后,邮递员每天把最新的送到你家。RSS 就是互联网版的订报纸,你告诉阅读器自己关注哪些网站,阅读器自动把最新内容送到一个界面里,不用挨个网站刷,更不用被算法推荐牵着走。
它有四个特点,对企业每一个都值钱。
高效,一个界面看完所有订阅源的更新。精准,只收你订的内容,没有信息茧房。隐私,不用注册账号,没有行为追踪。最值钱的是第四个,持久。RSS 是去中心化协议,不依赖任何单一平台活着。Twitter 改名 X 那次,多少人的关注列表被打乱,而通过 RSS 订阅的内容一条没丢。平台兴衰无常,你的情报源列表稳如老狗。
还有一条经常被忽略的技术红利,RSS 的数据天然结构化。标题、链接、发布时间、正文,每个字段都有标签标记,程序可以直接读取处理。这让它成为自动化工作流最顺滑的数据入口,比爬网页省一个量级的解析功夫。
顺便交代一下它的身世,因为这解释了为什么现在才轮到它翻红。RSS 1999 年诞生,博客年代跟着火过一波,2013 年 Google Reader 关闭,大家以为这协议死了,转头扎进算法推荐的怀抱。十年过去,算法茧房越织越厚,企业想主动掌控信息入口的需求反而回来了,加上 AI 自动化工具成熟,RSS 这个结构化数据源正好接上。老东西没死,只是等来了配套的下游。
算法推荐决定你看什么,RSS 决定你看什么。一字之差,主动权换手。
阅读器怎么选,按需求对号入座
工具不贵,按团队情况挑。
新手起步用 Feedly,学习曲线最平缓,免费版够用,AI 辅助过滤是亮点,订阅源超过五十个的用户能省不少浏览时间。要强的规则过滤换 Inoreader,可以设「标题包含某关键词且来源不等于某站」这种复杂条件,精准筛选,Pro 版每月 6 美元。Apple 全家桶用户可以看 Reeder,买断制,阅读体验一流。预算卡死就用 NetNewsWire,开源免费,简洁够用。
真正值得单独讲的是 Miniflux。它是个自托管方案,装在自己服务器上,免费,极简。更重要的是它带一套完整的 REST API,你的自动化工作流可以直接调它的接口拿最新文章做后续 AI 处理。老雷的建议是,如果 RSS 只是用来看,前面的托管产品随便挑,如果打算把 RSS 当企业情报线的入口接自动化,自建 Miniflux 是最灵活的底座。
订阅源的管理有一套朴素但有效的方法。分层,必读层控制在十个以内,每天必看的行业头部;扫描层二十到五十个,扫标题,感兴趣的点开;备选层不限量,用来发现新话题。再配一条铁律,每月清理一次,连续三十天没点开的源直接退订。信息源的质量永远比数量重要。
找不到 RSS 源,万物皆可 RSS
新问题马上来了,很多网站根本不提供 RSS,怎么办。
按成本从低到高试四招。先翻网站页脚找橙色波浪图标,正经媒体和博客基本都有。找不到就在域名后面加 /feed、/rss、/atom.xml 试试,一大半网站直接命中。再装个 RSSHub Radar 浏览器插件,它能自动检测当前页面有没有可用的 RSS 源。最后的大杀器是 RSSHub,一个开源项目,能给几乎所有平台生成 RSS 源,微博、知乎、B 站、小红书、Twitter、GitHub 仓库更新,全都有现成路由。你想监控的 B 站 UP 主、竞品的 GitHub 动态,拼一条路由地址就是一条 RSS 源。
RSSHub 可以用公共实例,但老雷给企业提个醒,做竞品监控或者涉及商业敏感信息时,订阅请求会经过第三方服务器,该自建就自建。成本不高,一台最低配 VPS 每月五到十美元,Docker 部署十分钟搞定,跑几十个监控源毫无压力。
接上自动化,才是 RSS 的完全体
前面都是铺垫,RSS 真正的威力在跟自动化工具结合之后。
n8n 有 RSS Feed Trigger 节点,监控指定源,有新内容自动触发工作流,内置去重,不会重复处理。Make.com 同理,RSS 模块能跟几百个其他服务连线。以 n8n 为例,六个企业最常用的场景,每个都是一条现成思路。
场景一,自动情报采集。RSS 触发,关键词过滤,Jina Reader 提取全文,写入 Google Sheets 或 Notion 数据库,行业动态自动入库。
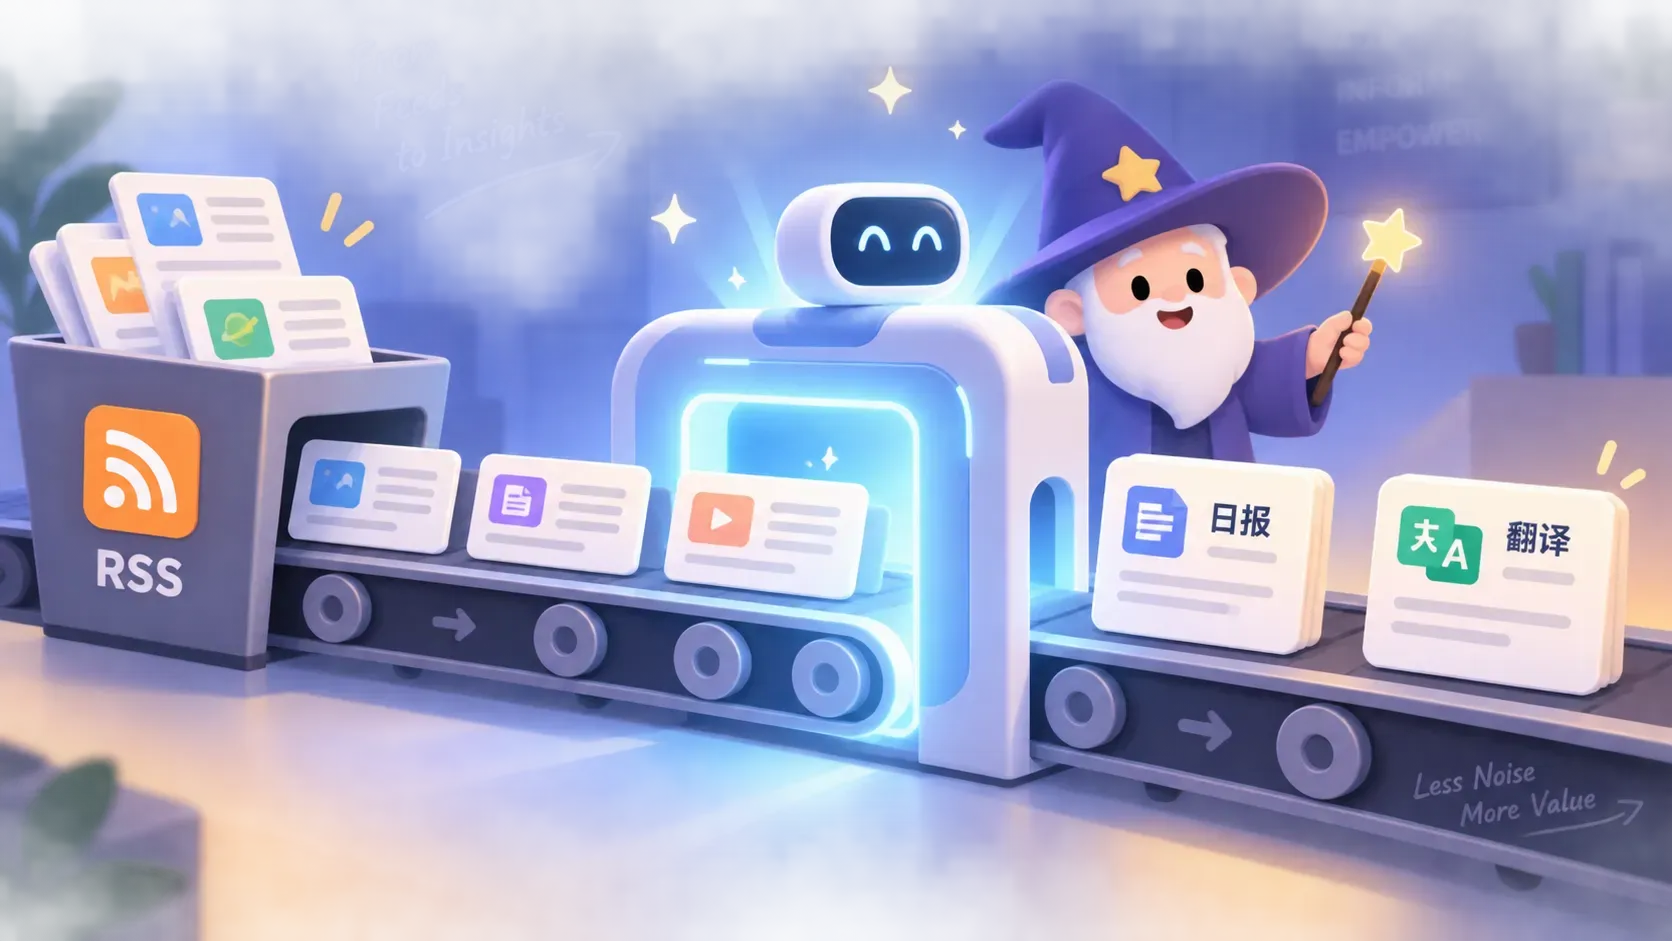
场景二,AI 日报。多个新闻源汇入,AI 生成每日简报,定时发邮件或飞书群。团队里没时间刷信息的人,早上摸鱼三分钟看完要点。
场景三,竞品监控。订阅竞品动态源,设关键词规则,命中即通知。竞品一发新功能公告,销售和产品这边分钟级知道。
场景四,跨语言情报。订阅英文源,AI 翻译成中文再格式化,推送到内部群。追海外技术趋势不用再硬啃英文网站。
场景五,内容评分。AI 给每篇新文章按相关性打分,高分推送,低分静默归档。从人肉刷变成只看高价值内容。
场景六,社交媒体代发。RSS 有更新,AI 生成适配文案,定时发到企业账号。这个场景慎用,发布环节留人工审核更稳。
拿场景三展开一条具体的搭法,竞品监控流水线。在 n8n 里建三个节点,RSS Feed Trigger 订好竞品的动态源,检查频率设十五分钟一次。中间接一个过滤节点,只放行带特定关键词的条目,比如产品名加发布字样。末端接飞书或企业微信通知,命中的条目连标题带链接推给对应群里。全程零代码,触发器自带去重,同一篇文章不会重复轰炸。搭完这条线的时间,不够你开一次会,但它往后每天替你盯着竞争对手。
采集、加工、分发,RSS 管入口,自动化管流转,AI 管加工,三层叠完就是一条企业情报流水线。
三个坑,提前绕开
这套东西不难,但有几个坑几乎人人会踩,提前说。
第一个坑是格式不统一。有的源把正文放在 content 字段,有的放在 description,有的两边都有但内容不一样。不做兼容处理,就会出现一部分文章抓出来是空白的。解法是工作流里加一个条件判断,先查 content,有就用,没有回退到 description。一个小分支,省掉无数莫名其妙的空白输出。
第二个坑是全文源越来越稀缺。很多源只给摘要或前几段,AI 摘要和翻译拿半截内容加工,质量必然打折。解法是在工作流里加一步全文抓取,Jina Reader 或 Firecrawl 都行,把 URL 还原成完整正文再交给下游。
第三个坑是单点失效。任何单一 RSS 源都不该成为关键信息的唯一渠道,源挂了你的情报线就瞎了。重要信息源做双保险,RSS 订阅之外再配一层 Google Alerts。另外记得定期导出 OPML 备份,那份文件是你全部的订阅资产,别传到公开网盘上,也别随手分享出去。
至于实时性,RSS 靠定时检查,通常有几分钟到几小时的延迟。对情报场景这完全够用,又不是做高频交易。
收个尾。这套体系的架构说穿了就三句话,用 RSS 聚合信息源,用自动化工具做流转,用 AI 做加工。三层叠起来,同样三十分钟,覆盖的信息量是刷社交媒体的三到五倍,而且每一篇都是你定义的重要,不是算法定义的热闹。
今天就能做的第一步,装一个阅读器,订上五个最关心的源,再装个 RSSHub Radar 插件。当你发现信息开始主动找你,而不是你追着信息跑,就回不去了。