老雷AI实验室
五百个词条进去,一千五百张卡片出来,小红书知识卡片的批量产线这么搭
先给你算笔账。
做小红书知识分享类账号,真正的瓶颈很少是文案,是图。一张知识卡片,调排版、选配色、填内容,手再快也得十几分钟。日更要三张图,光做图就能吃掉半天,写文案反倒成了顺手的事。
更憋屈的是,这半天干的全是重复劳动。同一套排版,昨天用今天用,变的只有卡片里那百来个字。人肉干着机器该干的活儿,这才是最难受的地方。
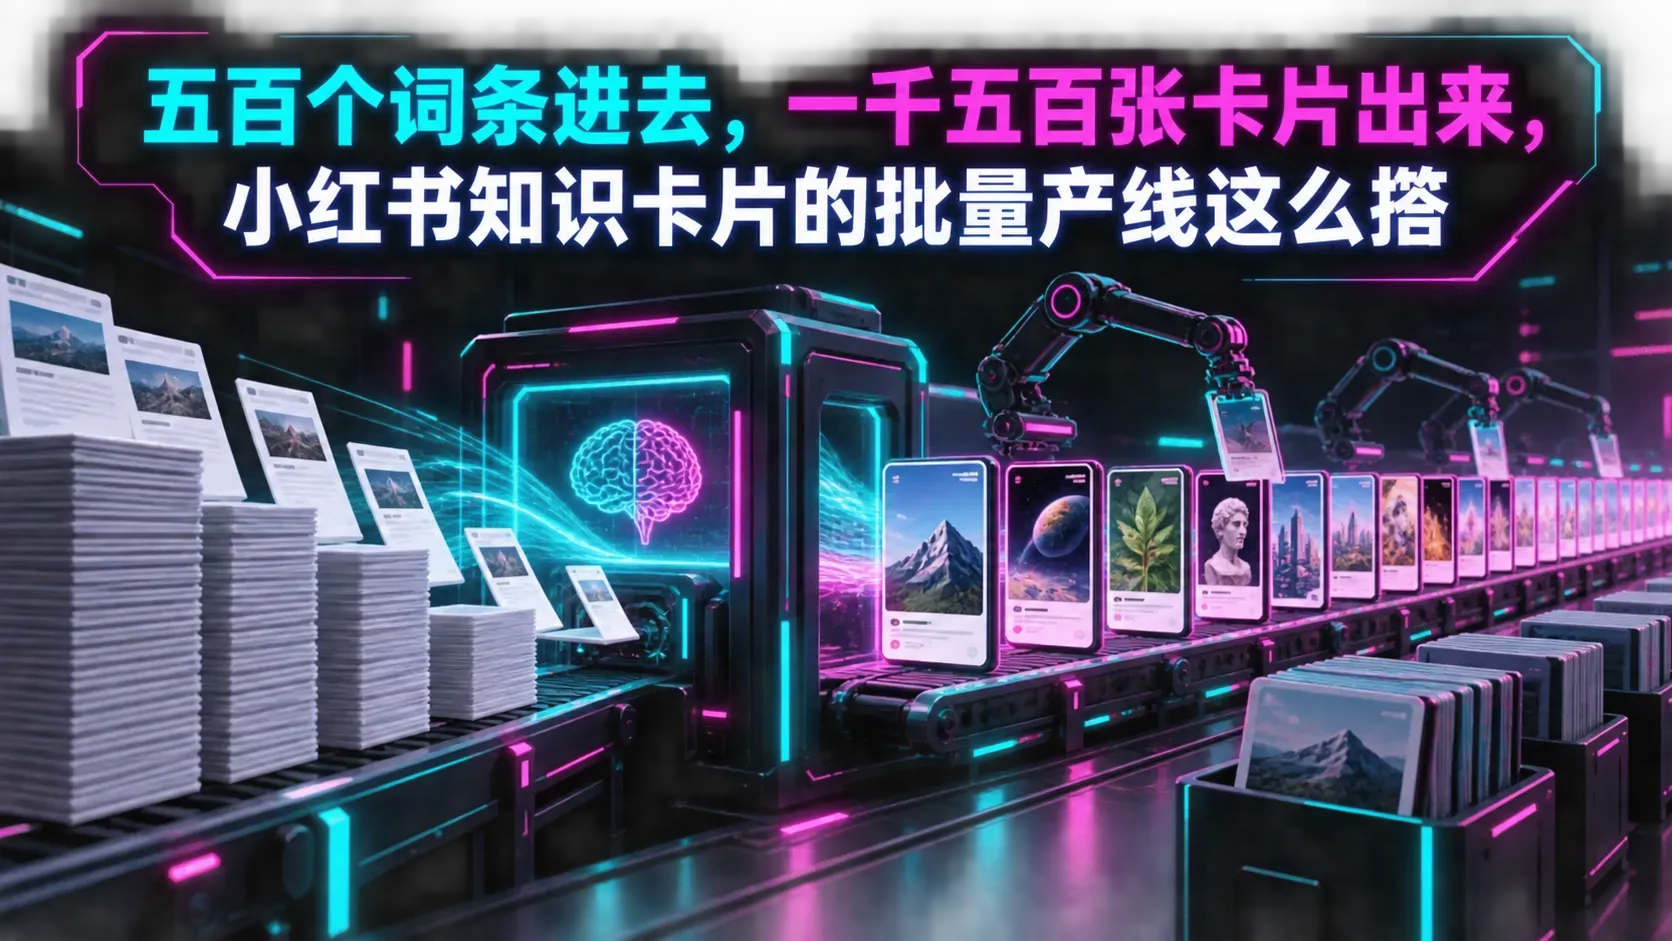
我们把各种批量方案实测了一圈,留下来的是这么一套,用 Make 把「网页采集、结构化提取、大模型写内容、HTML 渲染出图、图床归档」整条链路串起来。对着经济学人网站的财经词汇页跑了一次,五百多个词条,吐出一千五百张高清卡片,全程没人打开过作图软件。
想通的那句话其实特简单,知识卡片就是模板加结构化数据。模板不变,变的只有里面那几十个字。固定模板配变化数据,这正是自动化最擅长吃的活儿。
这篇把整条产线拆开给你看,每一步怎么配、坑埋在哪,按交付的顺序讲。
数据掰不开,后面全白搭
自动化的前提是流程化,流程化的前提是规范化,规范化的前提是结构化。这话听着绕,拿例子一掰就开。
经济学人的财经词汇页,五百多个词全挤在一个长页面里。不处理,它就是一坨文本,机器下不了手。把每个词拆成「名称加解释」两个字段,它就变成数组,能遍历、能批量、能套模板。
结构化不是技术洁癖,是批量产线的入场券。
老雷接批量出图的活儿之前,都会先看一眼数据能不能拆成一条条独立的记录。能拆,产线成了一半,拆不了,先回去改数据源,别急着搭流程。
拆开之后的好处特别实。五百个词不再是半篇文章,是五百条独立数据,每条都能单独生成一张卡。Make 的 Iterator 拿着数组逐条过,批量这件事才真正落地。
顺带说一句,知识卡片类内容天然是这套打法的最佳试验田。账号里别的选题可能各有各的形态,卡片不一样,它天生就是「一个版式填一万次」的东西。你手里要是有一个做到一半的知识账号,回头看一眼,八成一半的图都长一个样。
提取就两条路,按页面脏净选
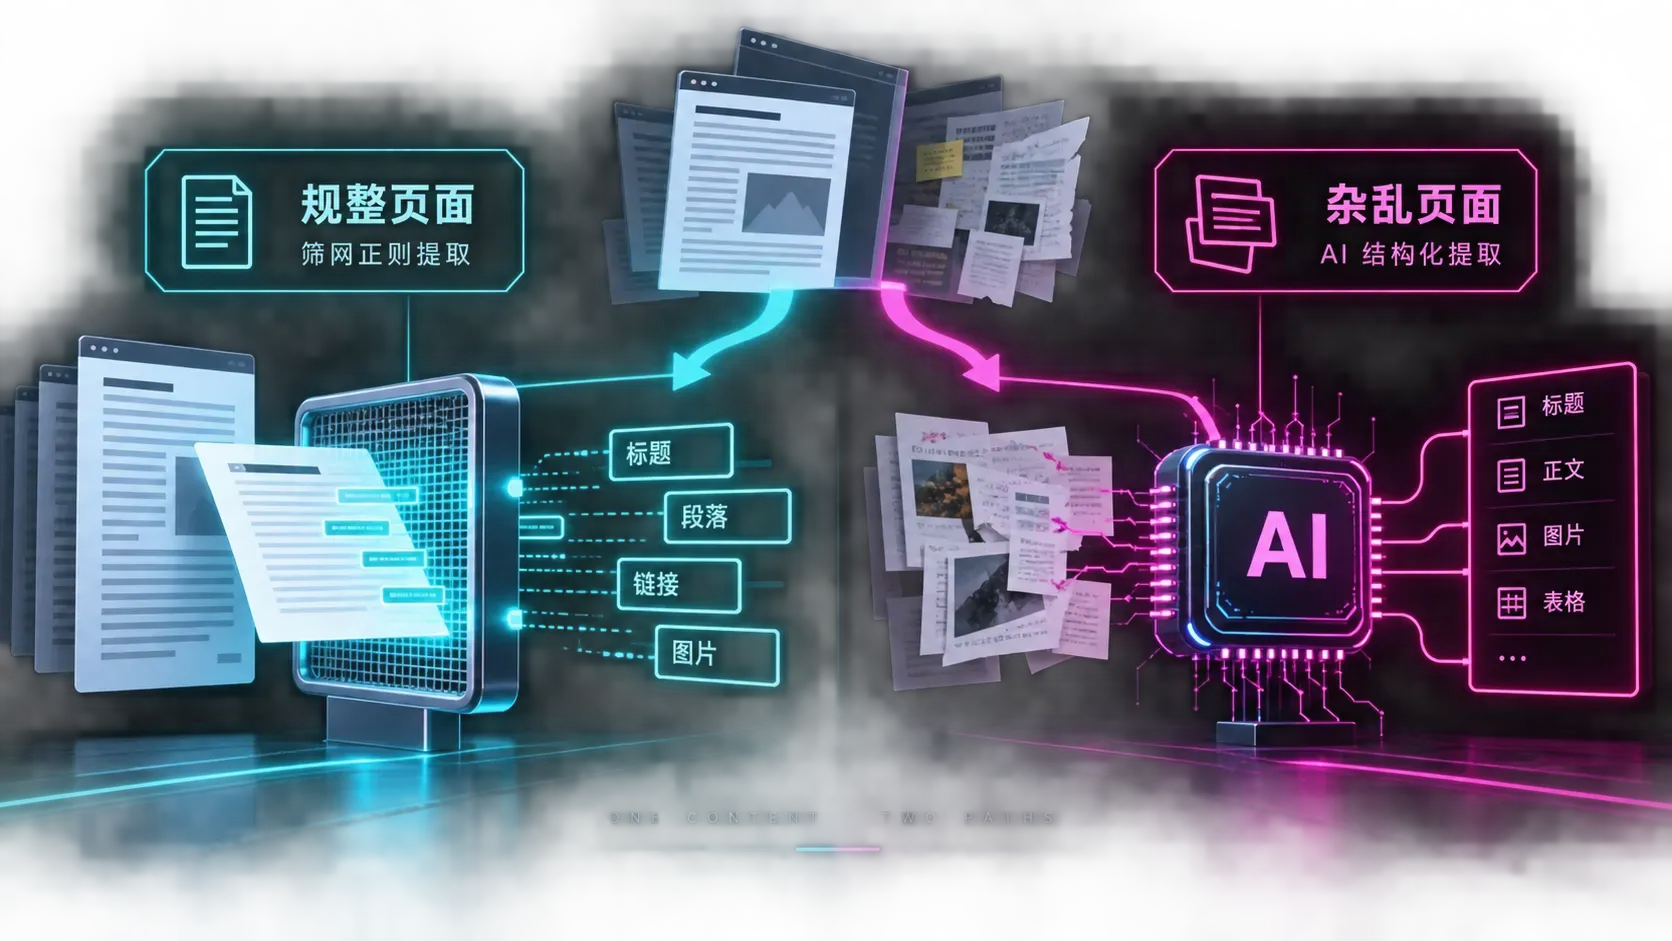
第一条路是正则表达式,老办法,分三步走,找特征、搭表达式、测表达式。
找特征,先看页面的数据长什么样。财经词汇页有个规律,每个词和它的解释之间隔着两个空行,这个双空行就是切口。
搭表达式不用自己写。把样例文本和需求丢给大模型,告诉它每个词条后面跟两个换行,帮我把名称和解释分别捕获出来,它直接给你能用的正则。「让大模型写正则」这个用法本身值得单独记一笔,正则这种语法高度收敛、对错立判的东西,恰恰是大模型最擅长的活儿,你只需要会描述需求。测表达式拿在线工具跑一遍,确认匹配没问题再进 Make。
Make 里的实际操作是两个 Match Pattern 模块串联。第一个用 ^.{1560}([\s\S]*) 截掉页头那 1560 个字符的杂讯,第二个用 ^([^\n]+)\n\n([^\n]+)(?=\n\n|\Z) 按双空行分割,第一组捕获词汇名,第二组捕获解释。Global 和 Multiline 两个开关都要打开。
实测结果,507 个词条全部提取正确,每个词条独立成一个 Bundle 往下走。
第二条路是 Firecrawl 的 LLM 提取,新武器。它有个基于大模型的结构化提取端点,不用写正则,HTTP 请求里直接说,从这个页面提取所有词条,输出 Term 和 Definition 两个字段,它返回结构化 JSON。实测提取 A 开头的 21 个词条,全对。
有个细节,不限定范围让它整页硬提,数据量太大可能超时,按字母分批提更稳。
怎么选?页面规整、结构规律明显,正则又快又省。页面脏、结构乱,直接上 Firecrawl,多花点调用费换省心。
顺带根治一个老大难。配 Firecrawl 的 HTTP 请求时,别手动拼 JSON,用 Make 的 Create JSON 模块。点添加数据结构,把 API 文档里的样例 JSON 粘进去,Generate 自动生成字段,后面把上游模块的输出映射进去就完事。换行符、空格、双引号这些能毁掉 JSON 结构的字符,模块自动处理。以前 HTTP 调大模型十次报错八次坏在格式上,这个模块上了之后基本绝迹,别问老雷是怎么知道的。。。
产线全貌,四个阶段串起来
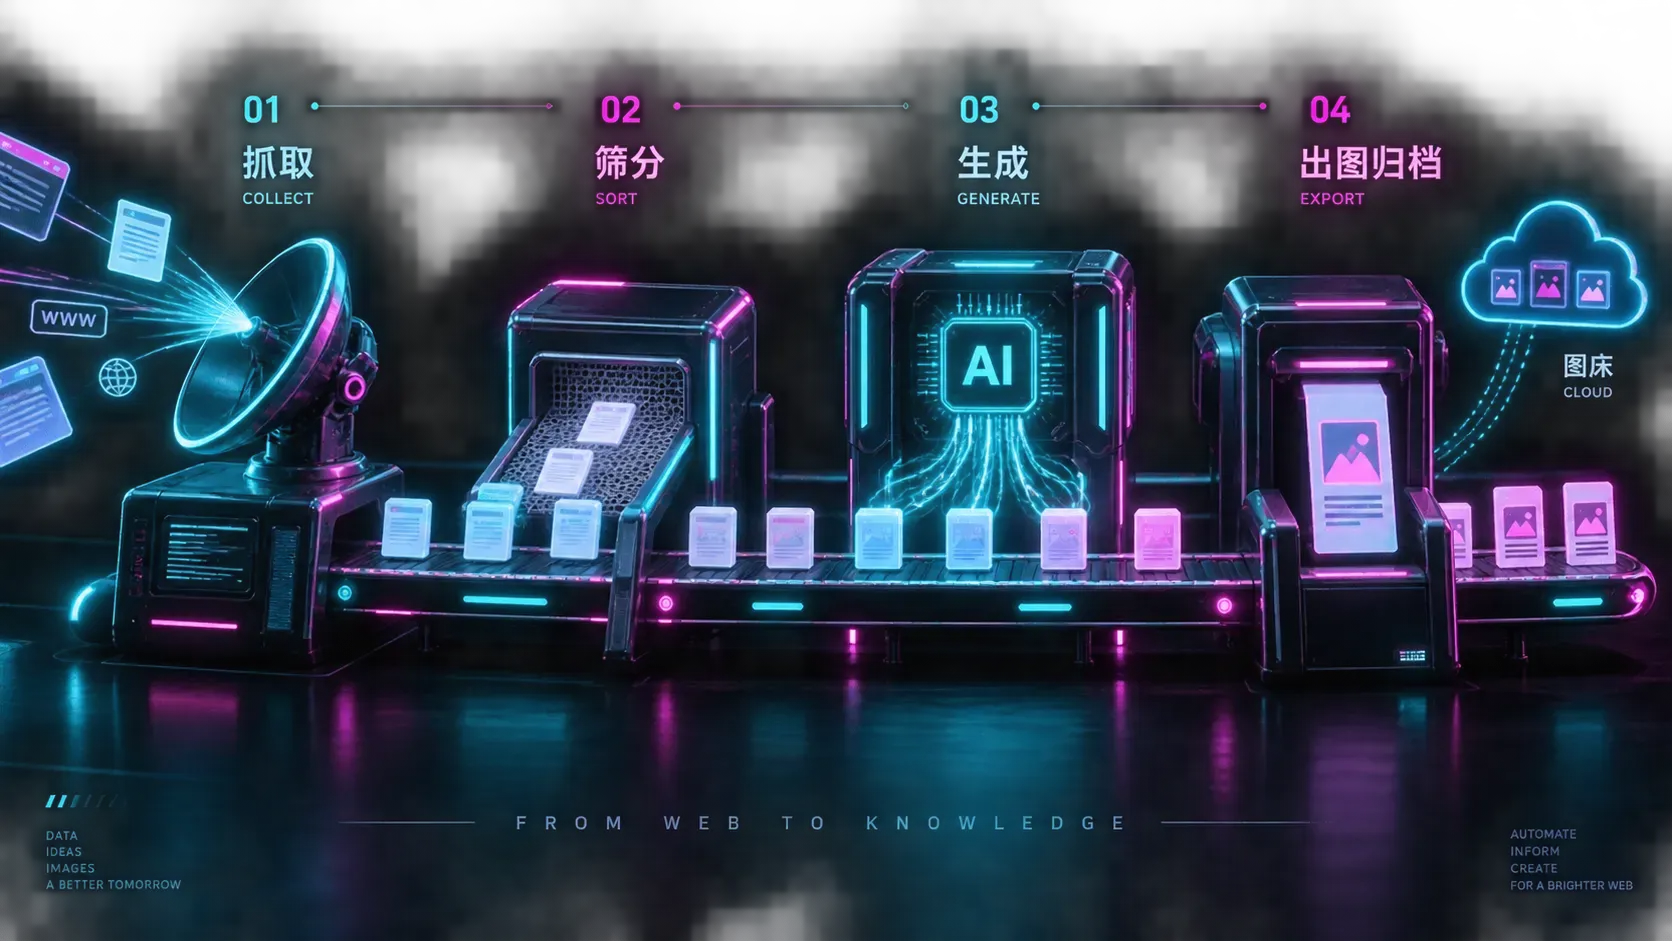
整条工作流四个阶段,模块连完是这样的。
数据采集,Basic Trigger 输入词条页的 URL,HTTP 模块调 Jina Reader API 抓整页,返回的 Markdown 里就是全部词汇数据。
数据提取,两个 Match Pattern 串联,先截页头,再按双空行切,前面讲过,不重复。
内容生成,每个词条用 EXA 的 Search 端点检索 5 条相关新闻,检索类型选 Keyword,范围限定新闻类,Content 开成 Yes 才能拿到正文。EXA 返回的也是数组,用中括号加序号能定位到具体条目,比如 Title[1] 就是第一条新闻的标题。然后 GPT-4o-mini 上场,系统提示词给它「经济学科普作家」的角色,要求输出 JSON。User 角色喂三样东西,正则提出来的英文词条名、原始英文解释、EXA 检索的 5 条新闻标题和正文。输出字段包括中英双语词条名、中英解释、中英生活案例、中英新闻摘要,每段都限在 130 到 140 字。
图片输出,HCTI 渲染三张卡,解释卡、案例卡、新闻卡,三个 HCTI 模块各管一张。HTML 模板是固定的,把 GPT 输出的对应字段映射到 {{变量}} 的位置就行,字体大小、间距、背景图这些视觉效果全交给 CSS 管。生成的图转存 Cloudinary,收尾 Notion 建条目,标题、三张图链接、采集状态、笔记文案一次存齐,一条完整的小红书素材就落袋了。
HCTI 是把 HTML 渲染成图片的在线服务,免费额度每月 50 张,支持 4K。三个关键参数记好,Device Scale 设 2 出 4K 清晰度,Viewport 宽 1240 高 1660,这是小红书竖版的标准尺寸。调样式别在 Make 里盲调,先去 HCTI 官网的 Demo 页贴 HTML 和 CSS 实时预览,改一个数字马上看到效果,调顺了再搬回工作流。
Cloudinary 给 25GB 免费存储。HCTI 生成的链接有失效风险,必须转存一道自己的图床,这是交付前不能省的保险。
不会 HTML 和 CSS 也别慌,把卡片样式描述清楚丢给 Claude 或者 ChatGPT,让它生成一套模板,再去 Demo 页改数字微调,这条路我们已经替你踩通了。
字数是卡片的生死线
知识卡片的文本区域是固定大小,单段超 150 字就溢出,图直接废。
所以要做双保险。第一层在提示词里,每个字段明确限 130 到 140 字,解释、案例、新闻三段内容一个都不放行。第二层在 Make 里,加一个条件过滤模块,检查返回的 word_count 字段,字数达标才放行去出图。
还有个调试顺序建议,先用最长的字段去试排版。模板在 Demo 页里贴一段 150 字的极端样例,顶到边了就改字号或者留白,留出安全余量再上线。别拿平均长度的样例调版,那样调出来的模板天生脆。
字数不达标就不许出图,这条纪律比任何漂亮模板都保命。
老雷的建议是,这条过滤别嫌麻烦省掉。大模型偶尔就会超字数,一百张图里混几张溢出的,返工的成本比多加一个模块高得多。
交付前的六步清单
把整条线压成一页 checklist,照着走就行。
一是确认数据源,能拆成名称加内容两个字段才有得玩。二是选提取方案,页面规整用正则,页面脏用 Firecrawl 分批。三是 Create JSON 拼 Request Body,杜绝手拼。四是提示词里限死字数,后面跟上 word_count 过滤。五是 HCTI 三参数,Device Scale 2,Viewport 1240 乘 1660,样式先在 Demo 页调。六是图床转存加 Notion 归档,交付物落袋才算完。
光有步骤还不够,交付前每一站都得有个验收动作。Jina 抓回来的 Markdown,先搜一下词条名,确认内容真的在页面里。Match Pattern 跑完,看 Bundle 数量跟词条数对不对得上,我们那次是 507 对 507,一个不少。GPT 输出后确认 JSON 解析不报错,word_count 全部达标。图片出来抽查几张,重点看最长的那段文字有没有顶到边。Cloudinary 链接逐条点开验证,Notion 条目字段齐不齐扫一眼。整条链路过一遍筛子,才敢说这批货能交。
成本也交个底。HCTI 每月免费 50 张,一条笔记 3 张图,够做 16 条上下,刚起步的账号隔天发一条正好撑一个月。量起来再考虑付费额度,或者换开源的 HTML 转图方案。
这套逻辑完全不用锁死在财经词汇上,英语单词、编程概念、健康知识、考公常识,任何能找到数据源的知识场景,换一套模板和数据就能重跑一遍。
真正的门槛从来不是工具,是你能不能把手里的内容看成一份可以遍历的数据。想通这一层,作图这件事就从创作变成了生产。