老雷AI实验室
一条 RSS 喂饱两个平台,GitHub Trending 到图文成稿的产线
做一个内容号,最耗时间的往往不是写。找素材、翻译整理、排版、再给不同平台各改一版口径,这一整套下来,写作本身反倒成了最轻的环节。做 GitHub 开源项目推荐类账号的人尤其懂,每天盯 Trending 榜,翻 README,重组成中文图文,再顺手压一条小红书笔记,一个项目就能折腾掉半天。更磨人的是两个平台的口径完全是两套,长文要铺得开,笔记要压得短,同一份素材换两种讲法,写的人自己都嫌烦。
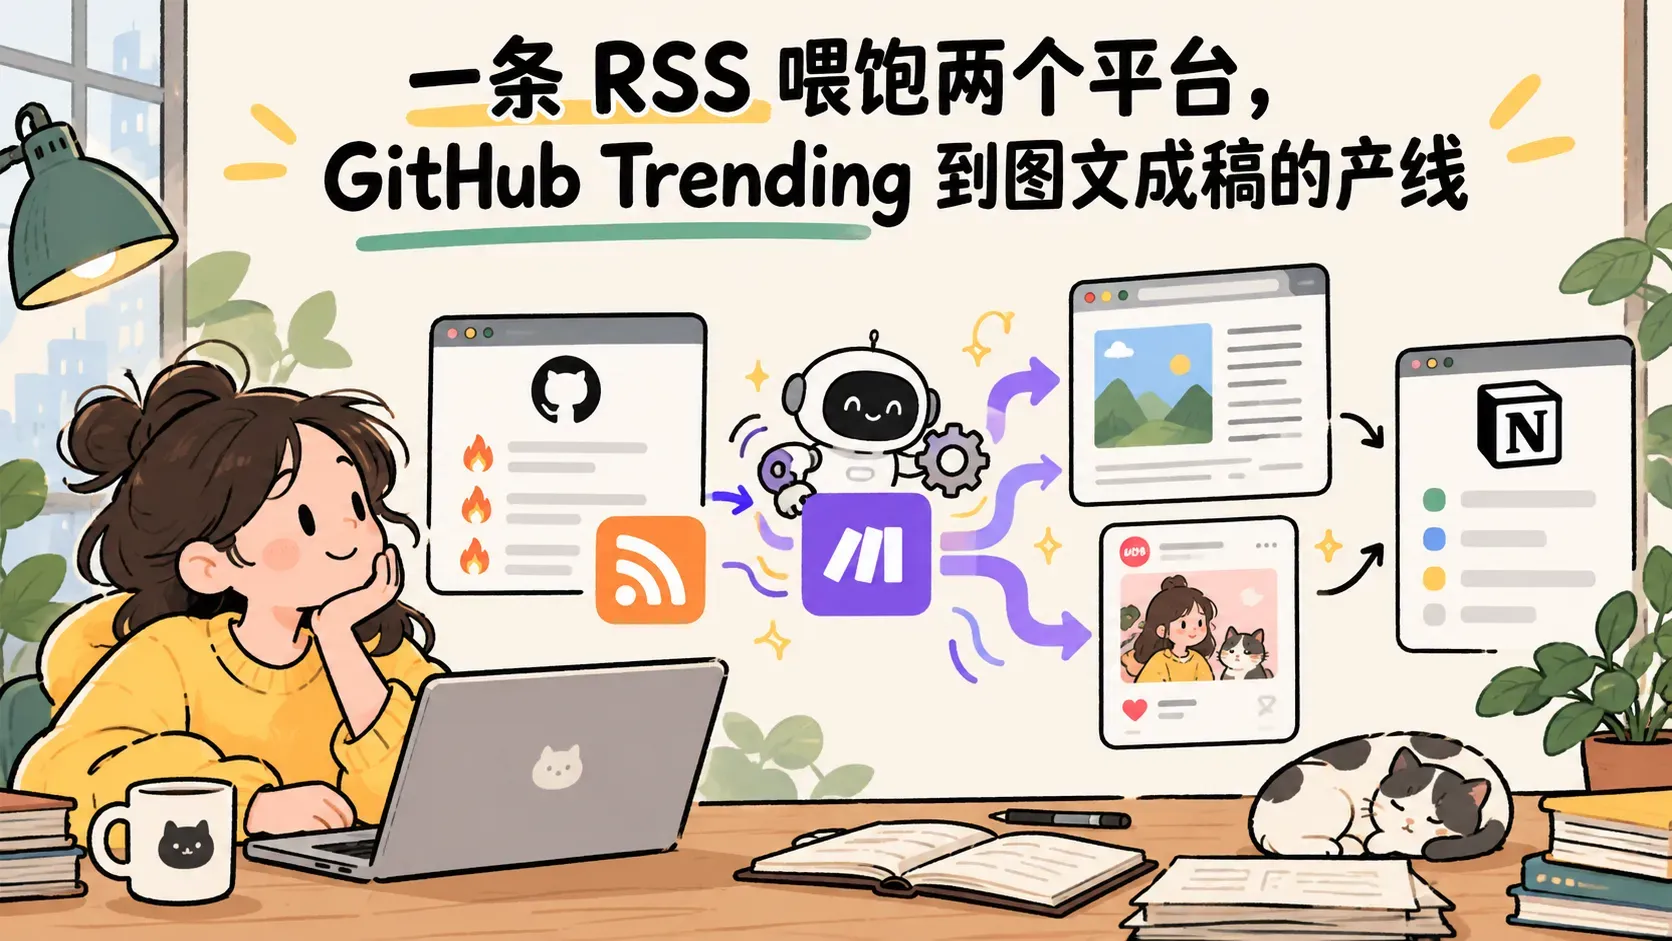
我后来把这条链路整个交给了自动化。一个 Make 工作流,RSS 抓 GitHub Trending,HTML 转 Markdown,ChatGPT 同时产出两千字以上的图文文章和一条小红书笔记,全部归档进 Notion。实测配置一遍 30 分钟左右,之后每天定时跑,无人值守,我的活只剩从库里挑稿。
这篇把它拆开,顺便讲讲背后那个四步框架,换任何领域都套得上。
一个账号的命,四步就定
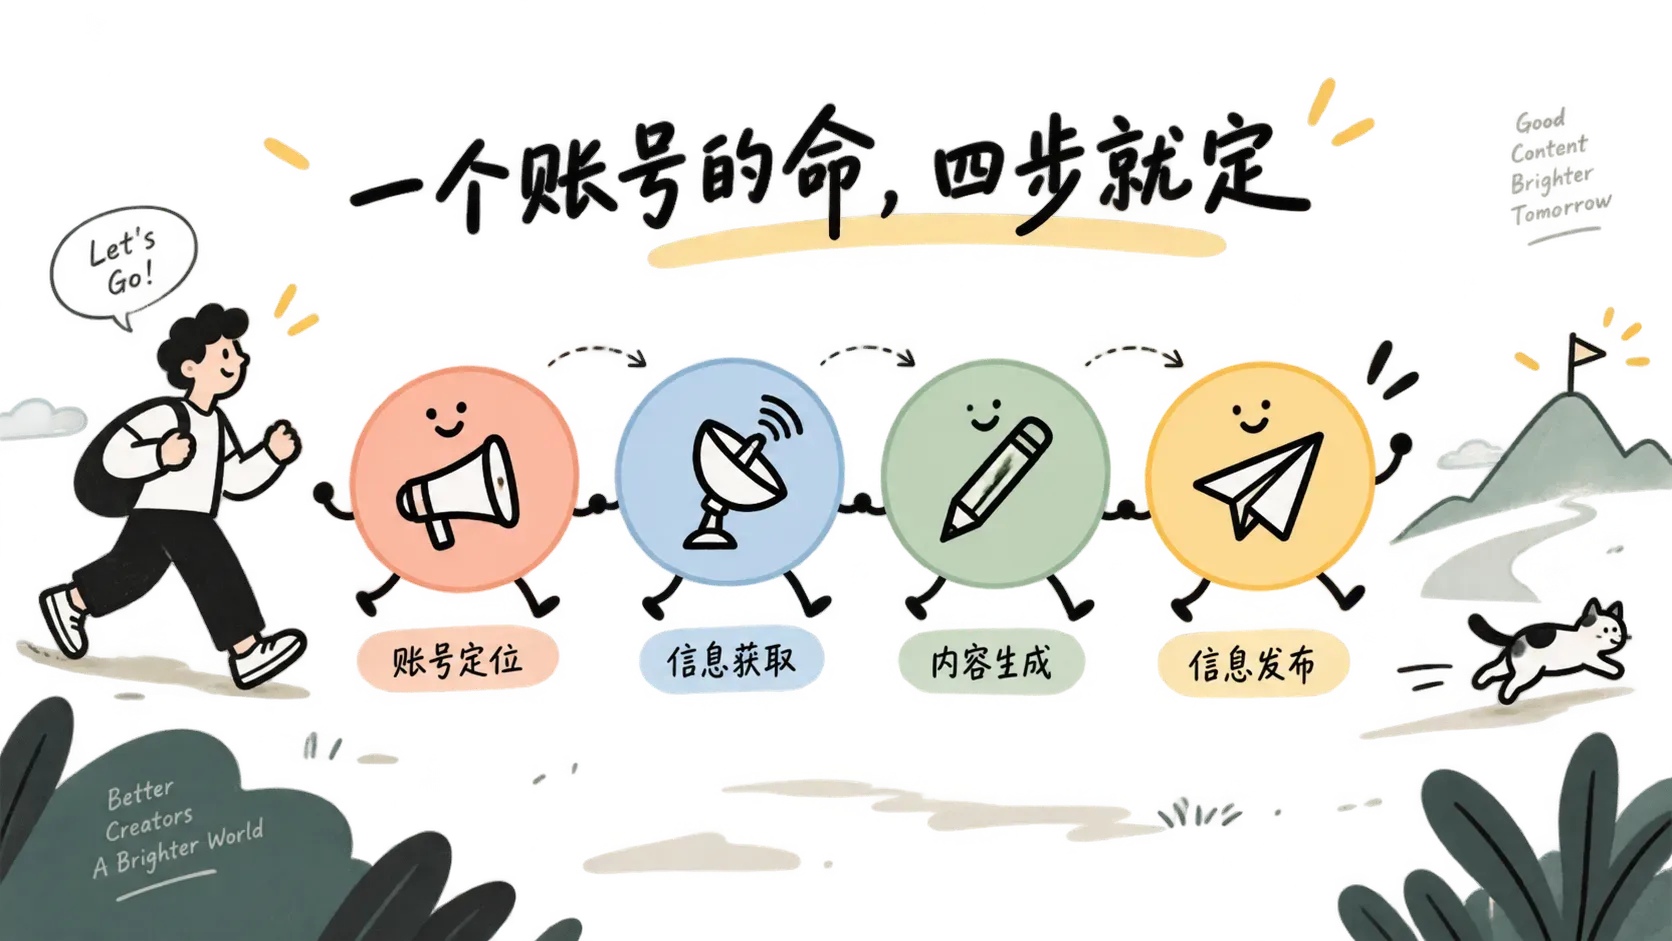
做内容这件事,拆到最细就四步,账号定位、信息获取、内容生成、信息发布。
定位想清楚写给谁看,信息获取找到稳定高质量的源,内容生成把素材加工成平台要的样子,发布把稿子送出去。听着平平无奇,但多数人恰恰卡在第二步和第三步,天天人肉找素材、人肉改写,把自己熬成素材的搬运工。老雷见过太多账号不是死于没人看,是死于产线断在中间,更新三周,停更三月,账号最怕的不是写得糙,是断得更。
拿这次的例子对号入座。定位是写给程序员和技术爱好者的每日开源项目推荐,信息源是 GitHub Trending 的 RSS,内容形态是 Markdown 图文混排,发布走公众号加小红书双渠道。四步各自定死,剩下的全是体力活,而体力活恰恰是机器最擅长的。
这个框架平时还能当体检表用。账号起不来,对着四格挨个查,定位模糊的改简介,源不稳的换源,生成慢的上工具,发布散的定节奏。四格里总有一格是空的,补上那一格,比天天改标题改封面管用。
GitHub 类账号,练手的好场地
为什么拿 GitHub 类账号当例子,它有三个天然优势。
Trending 榜每天更新,素材永远不缺。日榜周榜月榜三层节奏,热门项目随时有新动态可追。内容覆盖数据采集、文本生成、音频处理各个方向,程序员能找到家伙事儿,普通用户也能捡到效率工具。微信里搜 GitHub,能翻出一大把这类账号,头部账号单篇阅读量到过 9.6 万,赛道是被验证过的。
你还可以往细分了做,只盯 Python、只盯 AI、只盯前端,差异化自然就有了,起步阶段不需要跟头部硬碰。细分还有个隐藏好处,README 的技术密度和读者的胃口是对得上的,越垂直,模型照着素材写的稿子越容易对味,泛泛的综编号反而难写。
七个模块,一次采集双稿输出
信息源的接入靠 RSS。刷首页是人找信息,RSS 是信息找人,这东西有三个老牌优点,网站更新实时推送、数据是结构化的、可以按语言和时间段定制组合。给自动化供料,结构化这一条最要命,标题、链接、全文都在固定字段里,程序直接取,不用解析半猜。按语言定制这条对垂直号特别友好,只做 Python 内容的,直接订 Python 语言的日榜,噪声立减。GitHub Trending 的 RSS 有现成的开源站提供,mshibanami 的 GitHubTrendingRSS 按语言分类,日榜周榜月榜都有,Alexi 的 GitHub RSS 可以做备用源。我用的是全语言日榜,里面连 README 的完整 Markdown 都带着。
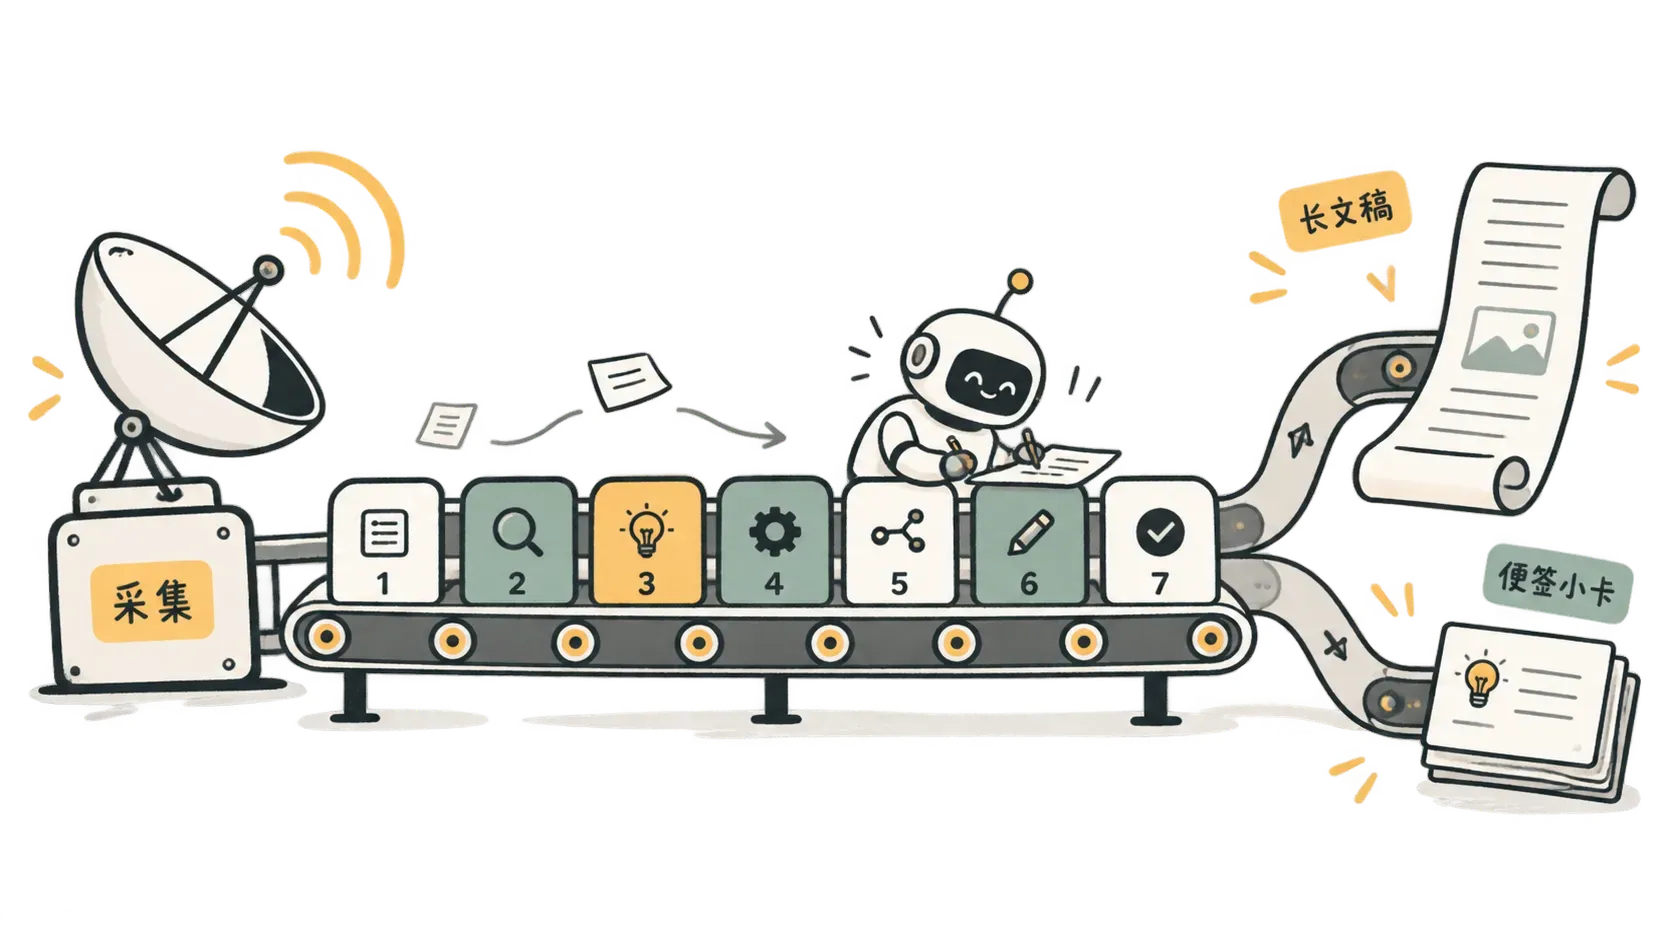
链路七个模块,一条线跑完。
RSS 的 Watch Feed Items 模块打头,贴上订阅地址,一次取一条。首次运行时如果列表是空的,把获取数改成全部跑一遍确认有数据,再改回 1。拿到的数据里三个字段有用,标题、链接、装着全文 HTML 的 description。
Markdown 模块接棒,选 HTML to Markdown,把 description 洗成干净的 Markdown,图片链接和代码块都保留。这一步是给模型备料,HTML 直接喂给模型,token 烧得冤,还容易把标签当内容说胡话,洗干净的 Markdown 才是好嚼的口粮。
OpenAI 模块第一通调用写公众号推文,模型 GPT-4o,Max Tokens 拉到 4000,输出格式保持 text,千万别选 JSON,选了输出就会被截成一团残废的半结构化文本。User 消息就一句「我提供的项目详情是」加上一步的 Markdown 结果。
第二通调用转小红书笔记,同样 GPT-4o,这次输出格式选 JSON,高级选项里把返回格式设成 JSON。一个工作流,两份成稿,两个平台各取所需。
为什么拆成两通调用,不让模型一通同时吐两份。贪省事的写法我试过,两种格式搅在一起,公众号稿里冒 JSON 碎片,小红书笔记里带长文腔,谁也不像谁。各叫各的工,各交各的活,才是稳的做法。
Notion 收尾。「微信文章」库五个属性,文章标题是 Title,状态用 Select,两个选项「未发布」和「已发布」,小红书内容和文章链接各一个字段,创建时间自动生成。Create a Database Item 建条目,标题、笔记、链接各归各位,状态内置「未发布」。这个内置别省,发布状态由人手翻,库里天然多出一道验收关,哪篇发过哪篇没发,一眼见底。还有个细节,Create 模块塞不下长正文,再加一个 Append to a Database Item,用段落块把公众号推文全文追加进去。一建一追,稿子才算完整落库。
不做 GitHub 类内容也完全没关系,把 RSS 源换成行业新闻、产品更新、论文发布,提示词里的角色定义和输出要求跟着换,这条产线的架构原样能搬,换领域只动两头,中间七个模块纹丝不用动。
提示词里埋着红线
写推文那通调用,提示词里约束比文采重要。
硬要求一串,文章 2000 字以上,只基于提供的项目信息不得编造,保留项目内的图片和代码示例,contributors、share 这类无关信息直接删,不要开头语和结束语,结尾介绍几个同类项目。每一条约有每一条的道理,字数压着是保证能撑起一篇推文的体量,删开场白是因为平台读者没耐心听客套,结尾介绍同类项目则是给读者一个继续留下的钩子。这一串里「不得编造」是红线,模型一上头就给项目安上它没有的功能,写出来像模像样,用起来全是坑。
小红书那通的约束全在格式,标题、正文、标签、字数四个字段装进 JSON,正文 500 到 800 字,不能有换行符,只允许文本、表情符号和必要标点。小红书的排版逻辑和长文是两个物种,没有标题层级,没有代码块,全靠短句和表情断节奏,格式卡得越死,产出来越能直接用。标签那串也别小看,它就是这篇笔记的分发入口,模型顺手埋的话题词,比人工凭感觉加的准。
红线画了也不是终点,老雷的建议是发布前还是快速过一遍,技术参数和功能描述处重点看。产线把成本压到十分钟一篇,人负责的是那道「这篇能不能发」的判断。整条产线里唯一需要手艺的就是这两段提示词,值得多花时间磨,磨好了一劳永逸。
从 Notion 到发布,还差一步
Notion 里的 Markdown 不能直接贴进公众号后台,中间要过一道排版工具,版式是读者对一篇稿子的第一印象,这步省不得。在线搜 Markdown 公众号排版编辑器,左边贴稿,右边实时预览,主题切着试,极简、橙心、锤子便签各有各的味道,临了点一下复制,粘进后台,图片、代码块、标题层级都保得住。一分钟的事,但这一步就是产线与发布之间那道人工闸门。
这里要摆正这套东西的定位,它是初稿生产线,不是成品交付线。十分钟出来的稿子,信息骨架是全的,口气和判断还是模型的,发之前加上你自己的经验和点评,它才从「能用」变成「是你的」。直接原样往外发,短期能跑量,长期必砸招牌。
场景设置里开 Scheduling,每天定时跑一次,配合 Trending 榜的日更节奏,早上跑完,当天的稿子已经在库里等你挑。
稿子攒起来之后,别篇篇都发。一天挑一到两篇值得发的,挑稿的眼光就是账号的品味,产线负责把量堆上来,你负责把关挑出尖子,量与品味各管各的,缺一样都成不了事。
产线把一篇稿子的成本从两小时压到十分钟,省下来的时间买什么,才是真正要紧的决定。
不建议第一天就追求全自动。先手动触发跑一周,每天验一遍稿子质量,确认模型没有跑偏再开定时,稳字当头,返工最少。工具链就摆在这里,今天挑一个你熟悉的领域,找到它的稳定信息源,把四步框架填满,照着这篇的模块清单搭,一个下午能跑通属于你的第一条产线。