 老雷AI实验室
让 Hermes 开口说话,三个入口的语音模式零成本配齐
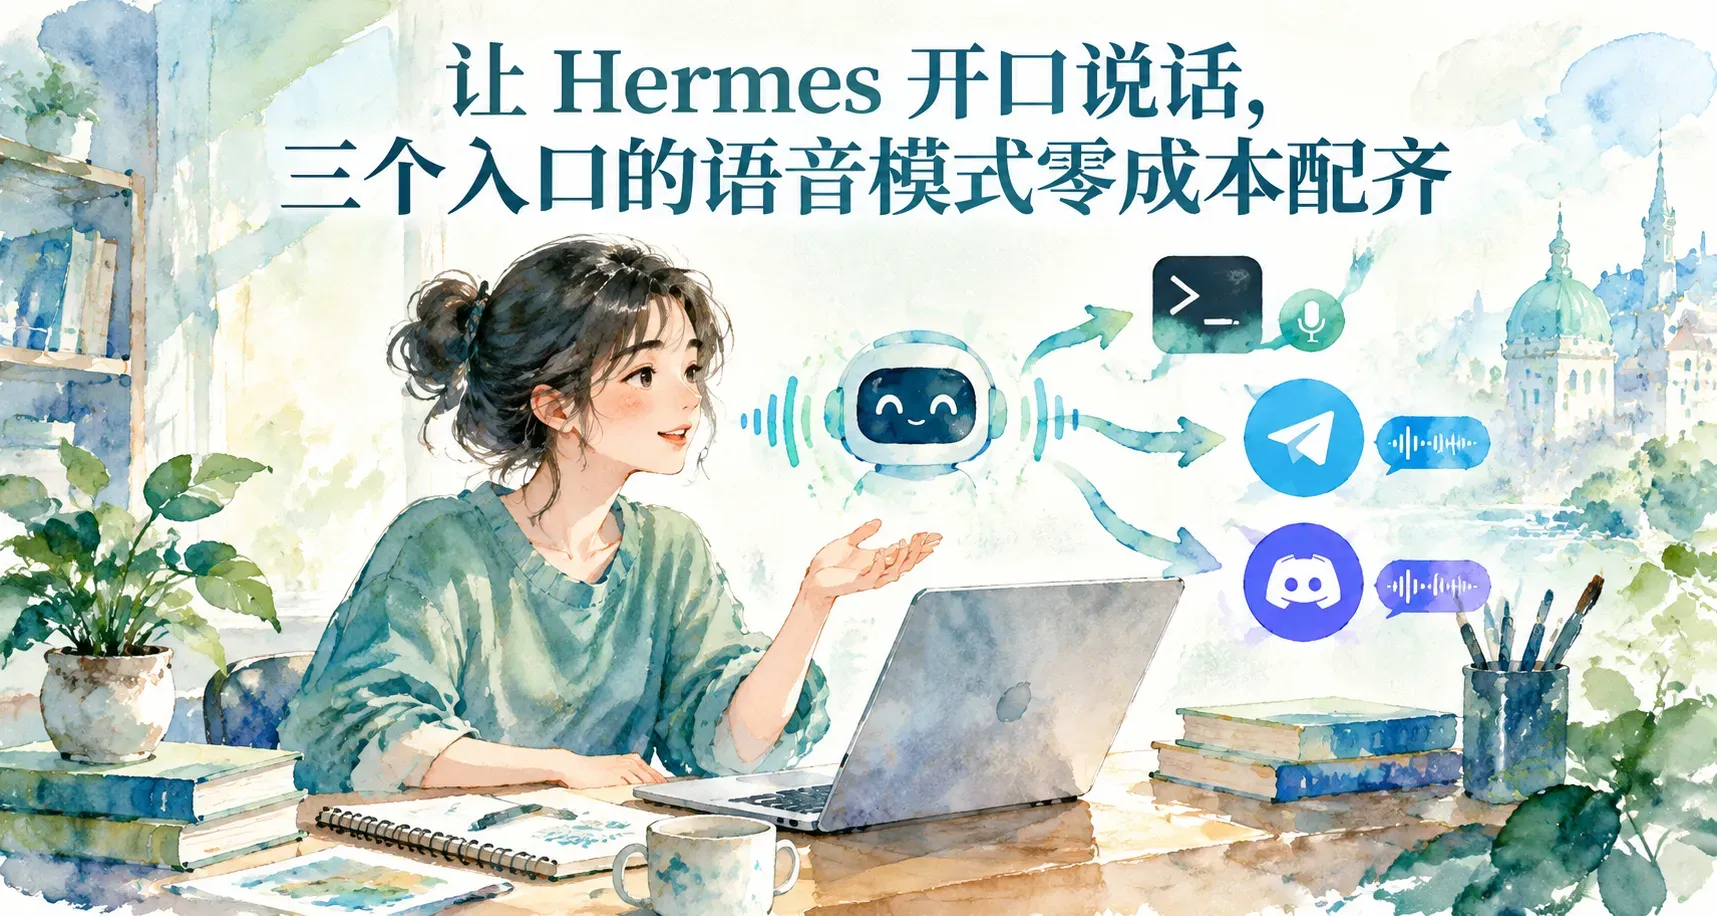
先报成本。这套语音方案我从零配到能日常用,花了 0 元,一个 API Key 都没申请。语音识别用本地跑的 faster-whisper,语音合成用微软的 Edge TTS,322 个音色、74 种语言,白嫖微软的神经语音基础设施。而 Hermes 的语音模式一共给了三个入口,CLI 终端按键录音、Telegram 语音气泡、Discord 语音频道实时对话,中间的工具调用、记忆、技能系统和打字模式完全一样,语音只是换了入口和出口。
这篇按交付顺序把三个入口一次配齐,中文场景怎么调参、Whisper 会编什么瞎话、怎么防,都在后面。
三个入口,先选主战场
一句话定位。CLI 适合编码时免提调试,本地处理延迟最低。Telegram 适合移动端,按住麦克风说话就行,对非技术用户最友好。Discord 语音频道适合团队场景,Bot 坐在频道里持续监听,多人同时说话各自独立处理,转写和回复同步落在文字频道。
三个入口共用同一套 STT 和 TTS 底座,所以配置顺序有讲究,先在 CLI 里把语音跑通,再上平台。这样出了问题才知道是识别、合成还是网络权限哪一层的锅。
零成本先跑通,一分钱不花
依赖分两层。Python 侧老雷的建议是直接 pipx install 加 all 范围一步到位,语音和消息的包全带上。系统侧 macOS 用 brew 装 portaudio、ffmpeg、opus、espeak-ng 四件,Ubuntu 对应 apt 装 portaudio19-dev、ffmpeg、libopus0、espeak-ng。装完跑 hermes doctor,看到 tts 和 discord 两项都是绿的才算数。
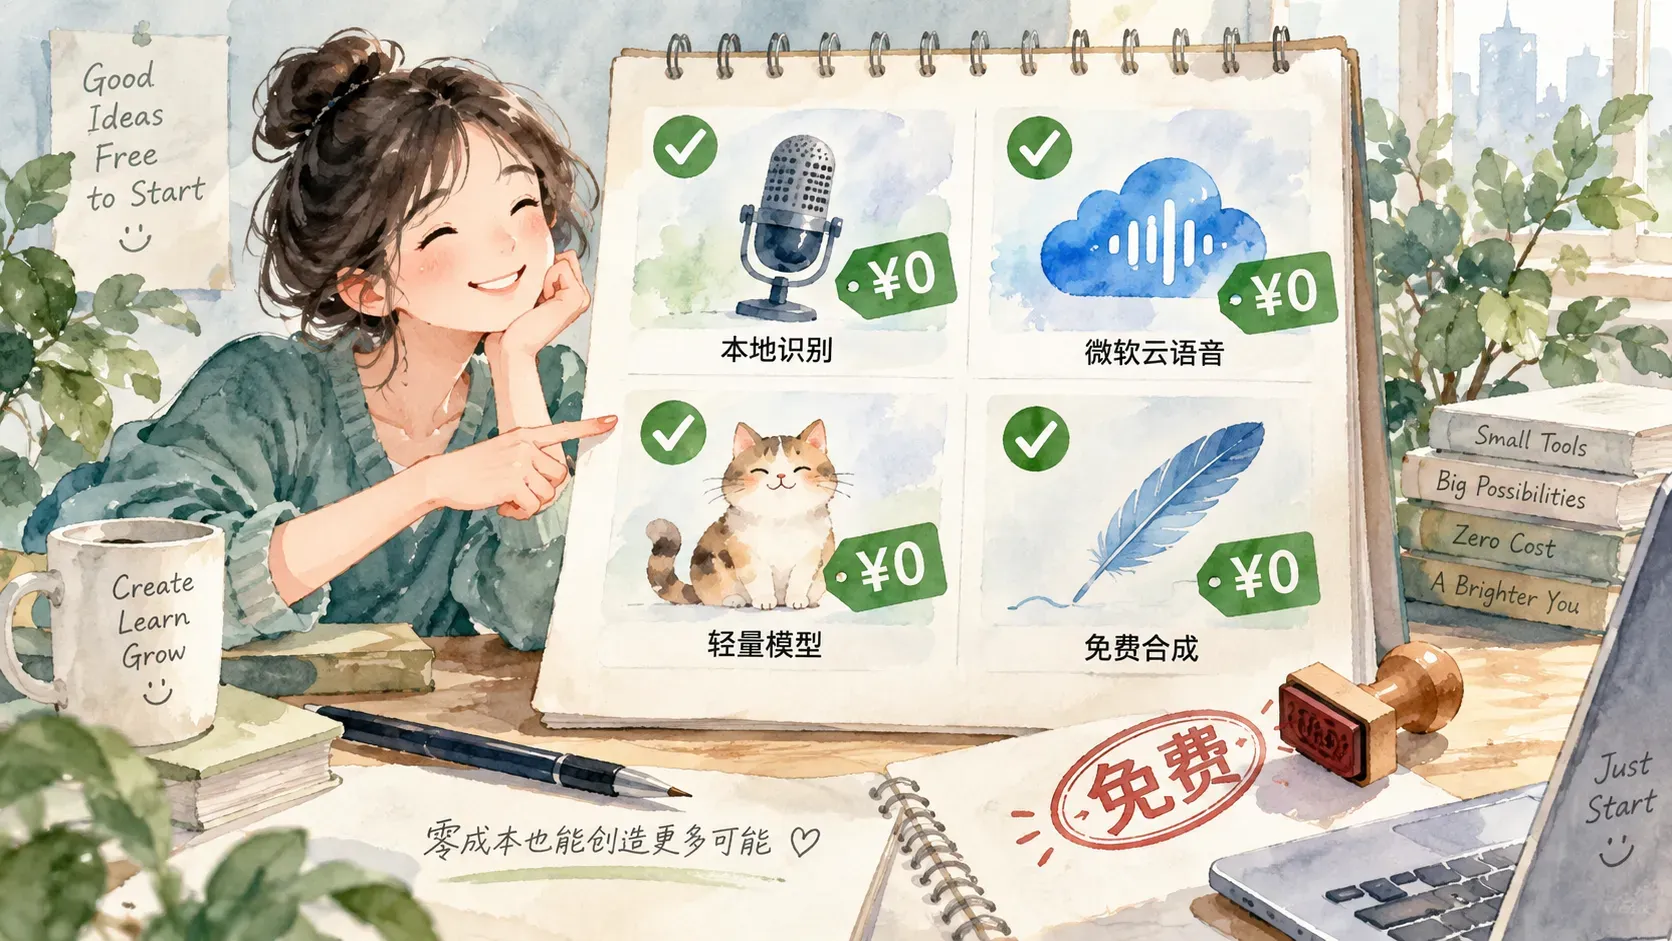
STT 这头,faster-whisper 是 OpenAI Whisper 的 CTranslate2 重写版,同等精度速度快最多 4 倍,本地跑,五个档位从 75MB 的 tiny 到 3GB 的 large-v3,按机器性能和精度需求挑。TTS 这头免费的有四个,Edge TTS 是默认项,延迟约 1 秒,开箱即用。NeuTTS 完全本地还支持声音克隆,喂一段短音频它就能用你的声音说话。Piper 是 Home Assistant 团队维护的,CPU 就能跑,44 种语言。KittenTTS 的 nano 模型只有 25MB,对体积敏感的部署场景用。
付费档先不碰,ElevenLabs 人声最自然但要 Key,日常场景犯不上。零成本组合的实际体验,口语识别完全够用,合成音色扎实,整套 0 元,零密钥零注册。
有个第一分钟的坑先说了,首次跑语音转写时 faster-whisper 要从 HuggingFace 下载模型,base 档约 150MB,这个过程没有进度条,CLI 看起来像死了,其实在下模型,等一两分钟就好,之后就不再下。建议装完先手动触发一次,把缓存捂热。
CLI 里按住 Ctrl+B 就能聊
hermes 进交互终端,敲 /voice on 开启语音模式,之后按 Ctrl+B,一声蜂鸣开始录音,终端里出现实时音量条,说完停顿 3 秒自动结束,再一声蜂鸣,转写、进 Agent、回复逐句朗读出来,然后自动回到等待,你接着说就行。整个循环双手不用碰键盘。
静音判断是两阶段算法,先等音量超过阈值并持续 0.3 秒确认你真的在说话,再等 3 秒连续静音判定说完。15 秒完全没语音就自动取消,不会挂死。两个参数都能调,噪声环境把 silence_threshold 从默认 200 提到 300 到 400,说话节奏慢的把静音时长加到 4 秒。Ctrl+B 跟 tmux 冲突的话,配置里把录音键换成 ctrl+space。
TTS 是流式的,回复逐句朗读,不用等全文生成完,Agent 开始思考几秒后你就能听到第一句话。Markdown 标记和推理块会自动剥离,不会念出一堆星号和井号。
实战里这条路子最顺的是免提调试。散步时想到一个 Bug,对着终端说 Docker 容器启动报权限错误,帮我看看,它自己去翻日志、分析原因、给修复方案,你接着追问,再读一遍最后那个错误,用更简单的话解释根因,现在给我修复命令。一套下来双手没碰过键盘。研究思考的场景也好使,口述半成型的想法让它实时帮你理思路,走路的时候灵感最值钱。打字不便的时刻,手腕不舒服、站着操作,语音是维持完整 Agent 交互循环里最省力的一条路。
免费四件套之外,付费阵营各有各的绝活,按需挑。ElevenLabs 人声最自然,个人免费额度每月一万字符,轻度用其实不花钱。MiniMax 对中日韩等亚洲语言的支持明显好于其他家,做中文语音产品可以重点看。xAI 支持声音克隆,Gemini 复用现有 Key 还带免费额度,三十个预置音色。选型逻辑很简单,中文优先 MiniMax,追求人声质感上 ElevenLabs,其他场景 Edge TTS 足够。
要是用的引擎不在内置列表里,比如字节的豆包,也有土办法,config.yaml 里声明一个 type 为 command 的自定义提供商,填一条 shell 命令,输入输出路径用占位符传,不用写一行 Python。更复杂的流式处理、OAuth 刷新,写个插件文件丢进 plugins 目录就能注册进去。超长文本不用担心,每个提供商的字符上限 Hermes 会自动截断处理,请求不会因为太长而失败。
平台上玩语音,两个细节决定体验
Telegram 这边,网关启动后直接在聊天里发 /voice on,这里的含义是收到语音才回语音,你发语音它回语音,你打字它回文字,这个 voice_only 模式最自然。设置重启后保留,不用反复配。细节在气泡格式,Telegram 的语音气泡要求 Opus/OGG,Edge TTS 原生吐的是 MP3,中间靠 ffmpeg 转,不装 ffmpeg 也能发,但显示成矩形文件附件而不是圆形气泡,质感差一截,ffmpeg 一定要装。老雷的建议是给家里长辈配 Hermes 就用这个入口,他们不需要学任何东西,会按住说话就会用。
Telegram 这边还有一句隐私账要算清。语音消息会存在 Telegram 的云端,Bot 下载来转写,本地 Whisper 保证音频只在你机器上处理,但传输到 Telegram 服务器的那一段你控制不了。要求最高的做法是本地转写加本地 NeuTTS 合成,所有音频处理留在自己手里,代价是要一台性能还行的机器。
Discord 语音频道是最沉浸的,配置也最重。开发者门户里给 Bot 加语音权限,权限整数从纯文字模式的 274878286912 升到含语音的 274881432640,升完要重新邀请 Bot 进服务器。装好 Opus 编解码器,bot 会自动找到它。之后在文字频道发 /voice join,Bot 加进你所在的语音频道,独立监听每个人的音频流,1.5 秒静音触发处理,转写同步出现在文字频道,回复文字和语音各发一份。两个机制值得点赞,Bot 播放 TTS 时自动暂停监听,不会把自己的话听一遍再回一遍。限制也摆在明面上,300 秒无活动自动退出频道,这个超时目前硬编码改不了,另外只有 ALLOWED_USERS 名单里的用户语音会被处理,其他人说话它装听不见,这个默认行为其实挺安全。
这类语音频道最适合团队头脑风暴,Agent 坐在频道里参与讨论,随口问它技术问题让它现场查,学习小组用它解释概念,游戏社区养一个常驻语音助手也够格。上之前先在专门的测试频道把识别和合成都验一遍,别直接开进正式频道。
Whisper 会一本正经胡说,五层防线兜住
Whisper 有个被学术界记录在案的问题,面对静音和背景噪声会凭空编出文本。有论文测出约 1% 的转写含完全虚构的短语,社区收集过 135 个常见幻觉短语,最典型的是 Thank you for watching,对着空气录三十秒它能给你整出一段感谢订阅。中文场景一样中招。
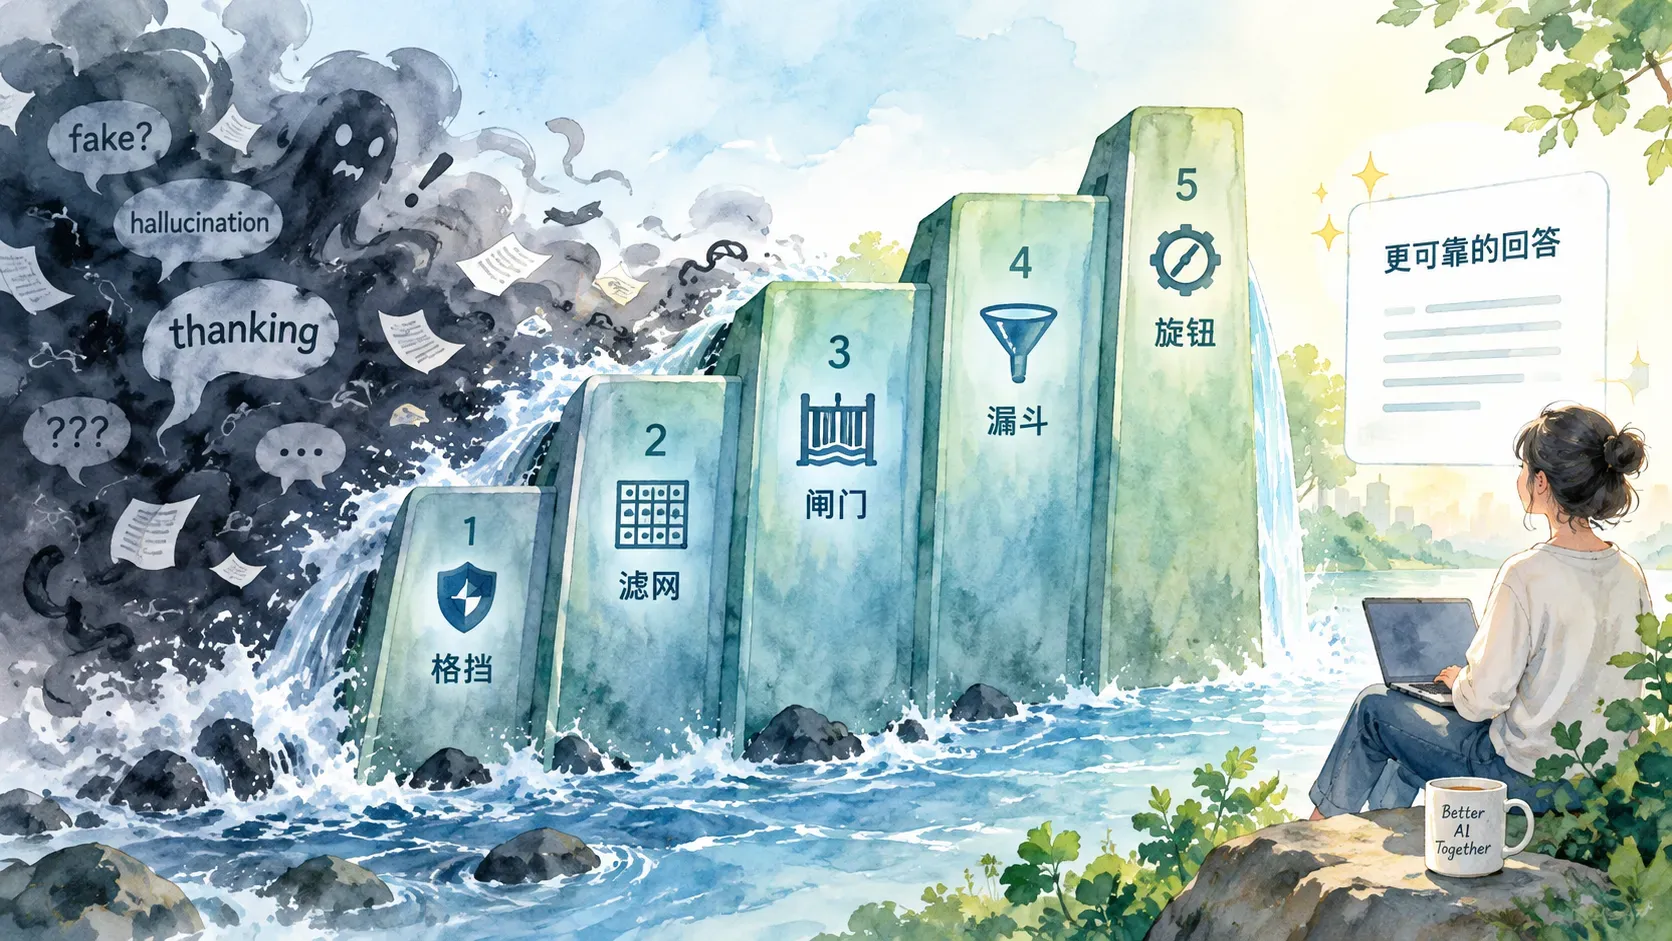
Hermes 的应对是五层。26 个多语言幻觉短语黑名单,正则捕获变体,两阶段语音活动检测从源头过滤静音,15 秒无语音超时,再加可调的阈值参数。实战里还有两手,幻觉多先换更大的模型,small 比 base 干净,medium 再好一档,还不行就切云端,Groq 的 whisper-large-v3-turbo 延迟约半秒还有免费额度。STT 的回退链是本地、Groq、OpenAI 依次兜底,全挂时语音消息原样转给 Agent 不丢失。
配置直接给四档。日常免费档,STT 本地 base 模型,TTS 用 Edge,全免费。高质量付费档,Groq 识别加 ElevenLabs 合成。完全离线档,large-v3 加 Piper,所有音频不出本机,隐私敏感场景用。中文优化档单说,STT 用 medium,base 对中文断句偶有不准,TTS 用 Edge 的 zh-CN-XiaoxiaoNeural 晓晓,男声备选云希,静音阈值建议提到 250,静音时长放到 3.5 秒,这两个参数按中文语速特点调过之后,识别稳定度上一个台阶。
免费方案的天花板比很多人想的高,先跑起来,再谈花钱。
语音不是孤立功能,它叠在整条 Agent 流水线上,所以联动起来才有意思。对着 Telegram 说一句打开浏览器搜今天的 AI 新闻,配上桌面控制能力它真的会去操作,完了语音汇报结果。语音里说的提醒和定时任务直接登记进调度,之后到点自动执行。语音聊过的内容也进记忆系统,下次文字里提一嘴它照样接得上。
交付前留一份故障速查。CLI 报找不到音频设备,多半是 PortAudio 没装,Docker 环境还要另配音频桥接。首次转写像卡死,是模型在下载,等它。Bot 在 Discord 不响应,检查是不是没 @它,或者免提及名单没配。能听懂但不说话,TTS 配置或密钥的问题,Edge TTS 是默认回退。转写出来一堆乱码,回到幻觉防线那节调阈值换模型。语音不发气泡,装 ffmpeg。五分钟自动退出频道,记住 300 秒这个数,它是硬编码。
上线路径官方建议渐进式,第一天确认文字模式正常,第二天在 CLI 里试语音,第三天上 Telegram 或 Discord,最后再碰语音频道。跳步的代价是出了问题分不清是识别、合成、网络还是权限的锅。老雷的建议一样,配好先给团队里最怕打字的那位同事用一周,收到的反馈比任何评测都真实。