老雷AI实验室
同一个 Codex 额度,为什么有的团队撑一个月,有的一周就见底
事情是这样的。前段时间两个团队找我做 AI 编程的成本复盘,额度一样、人数一样、干的活也差不多,一个团队的用量月底还有富余,另一个十天就见了底。
差在哪,把两边的使用记录摊开一看就明白了,见底的团队几乎全员常年最高档,简单批改也用最强模型深推理,挂着加速模式去跑后台长任务。这不是个别现象,是新手最普遍的用法。这篇把 Codex 的选型逻辑拆开讲,核心就一句话,学会按任务难度切档,比调到最高专业得多,也省得多。
省不省用量,看的是把活做成的总成本,不是单次请求的成本。
Codex 不是一个模型,是四个旋钮
很多人把 Codex 理解成一个模型,理解偏了。它是四个独立旋钮的组合,模型选哪个底层引擎,推理深度决定内部想多深,输出密度决定回复写多细,加速模式花更多用量换更快响应。
四个旋钮互相独立,可以低推理配详尽输出,也可以高推理配简短回复。有人会问,为什么不干脆做一个智能档一键搞定,因为不同任务的最优解互相矛盾。实时补全要的是速度,得牺牲深度,复杂重构要的是质量,得牺牲速度和成本,跑批要的是省用量,得牺牲单次智能。没有任何一个按钮能同时把三角拉满,所以选择权交给了你。
这带来一个企业侧的结论,工具默认不了的,制度来补。团队要有自己的切档规范,不然每个人都会顺手拉到最高。
模型按定位选,不按强弱排
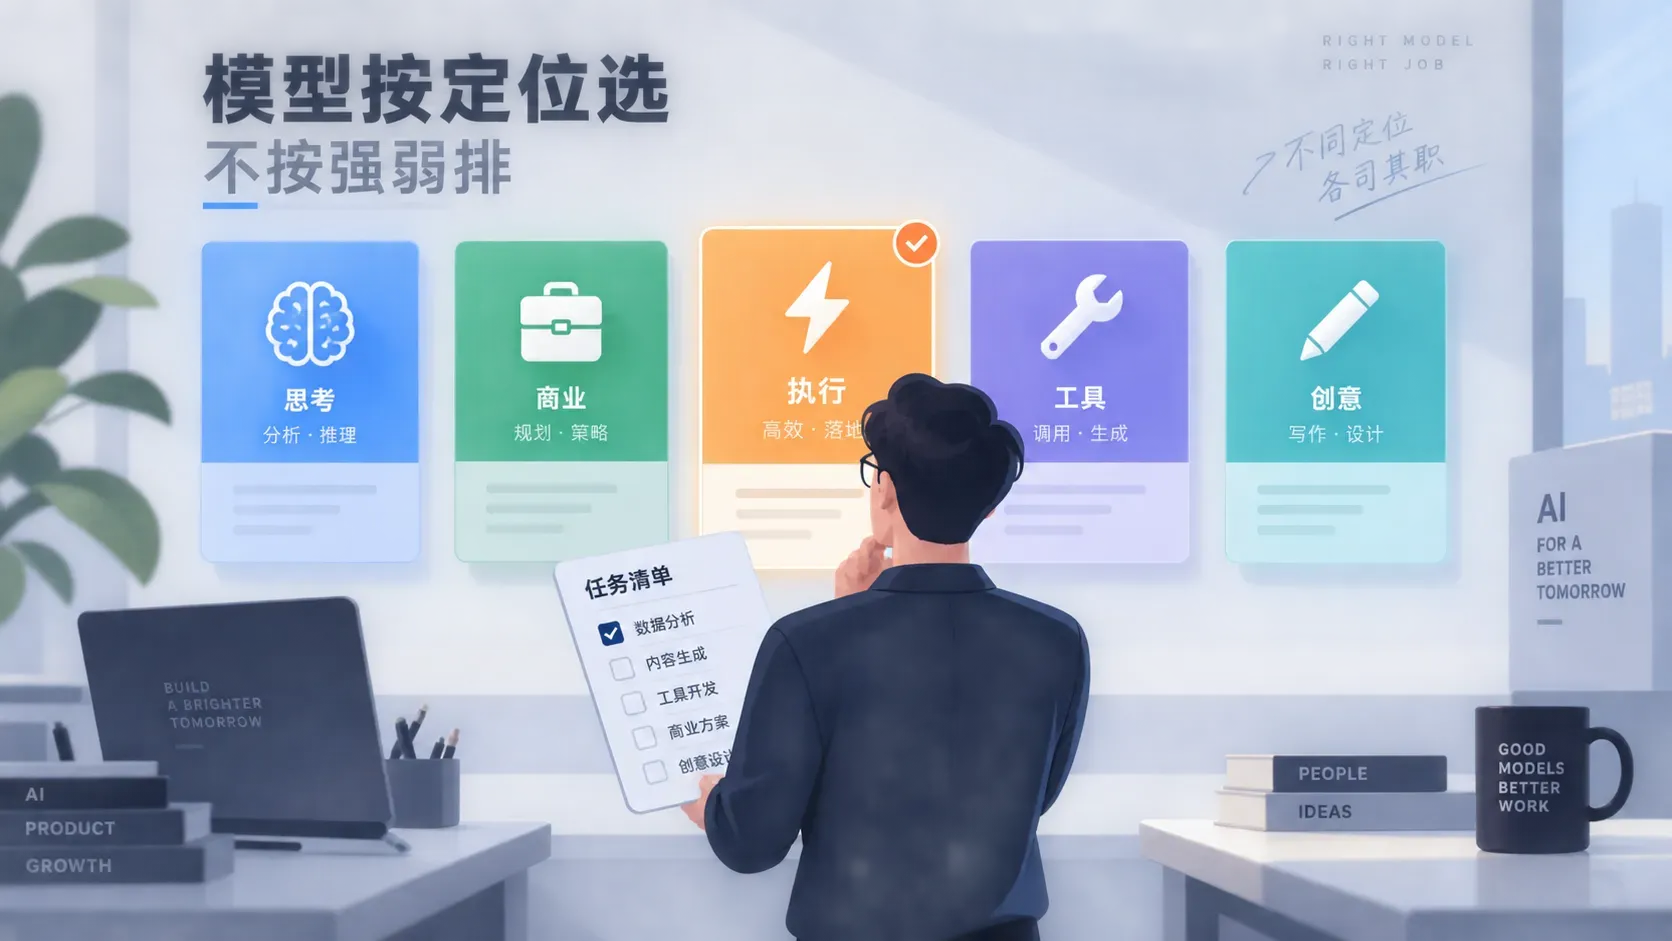
Codex 的几个模型不是一条从弱到强的直线,是定位不同。最新前沿模型面向复杂编程和知识工作,是官方推荐的默认起点,多数任务从它起步。旗舰专业模型把编程能力和推理、工具调用合一,面向专业复杂任务。轻量 mini 面向快速响应的任务和子代理。编程专精模型主攻复杂软件工程和 Bug 修复。还有个研究预览的 spark,专为近乎即时的实时迭代优化,编辑器补全专用。
新手最容易纠结的一点,最强的不是最贵吗,为什么官方反而推荐先用它。这里要分清两笔账,单看一次请求,强模型可能更贵,但把活做成要看总成本,强模型往往一次做对,弱模型反复试错来回返工,加起来未必便宜。所以正确顺序是先用够强的把任务跑顺、建立判断,再针对简单任务往轻量挡省,而不是一上来就用最弱的,把省下的用量全赔在返工里。补一句 spark,新手第一周一般用不到它,先用主模型把流程跑顺,等开始在编辑器里高频做局部小改了再请它出山。
mini 什么时候切,五个场景。批量改文件,统一格式、批量替换,任务简单跑量大,智能不是瓶颈。简单补全,速度比智能重要。子代理做探索性扫描,只报告不下决策。不重要的实验脚本,出错代价低。还有当月用量吃紧要省的时候,mini 的输出成本是主模型的零头。反过来,迷你见底了别硬撑,命令行里一条斜杠命令就能切。
推理深度,五档怎么落
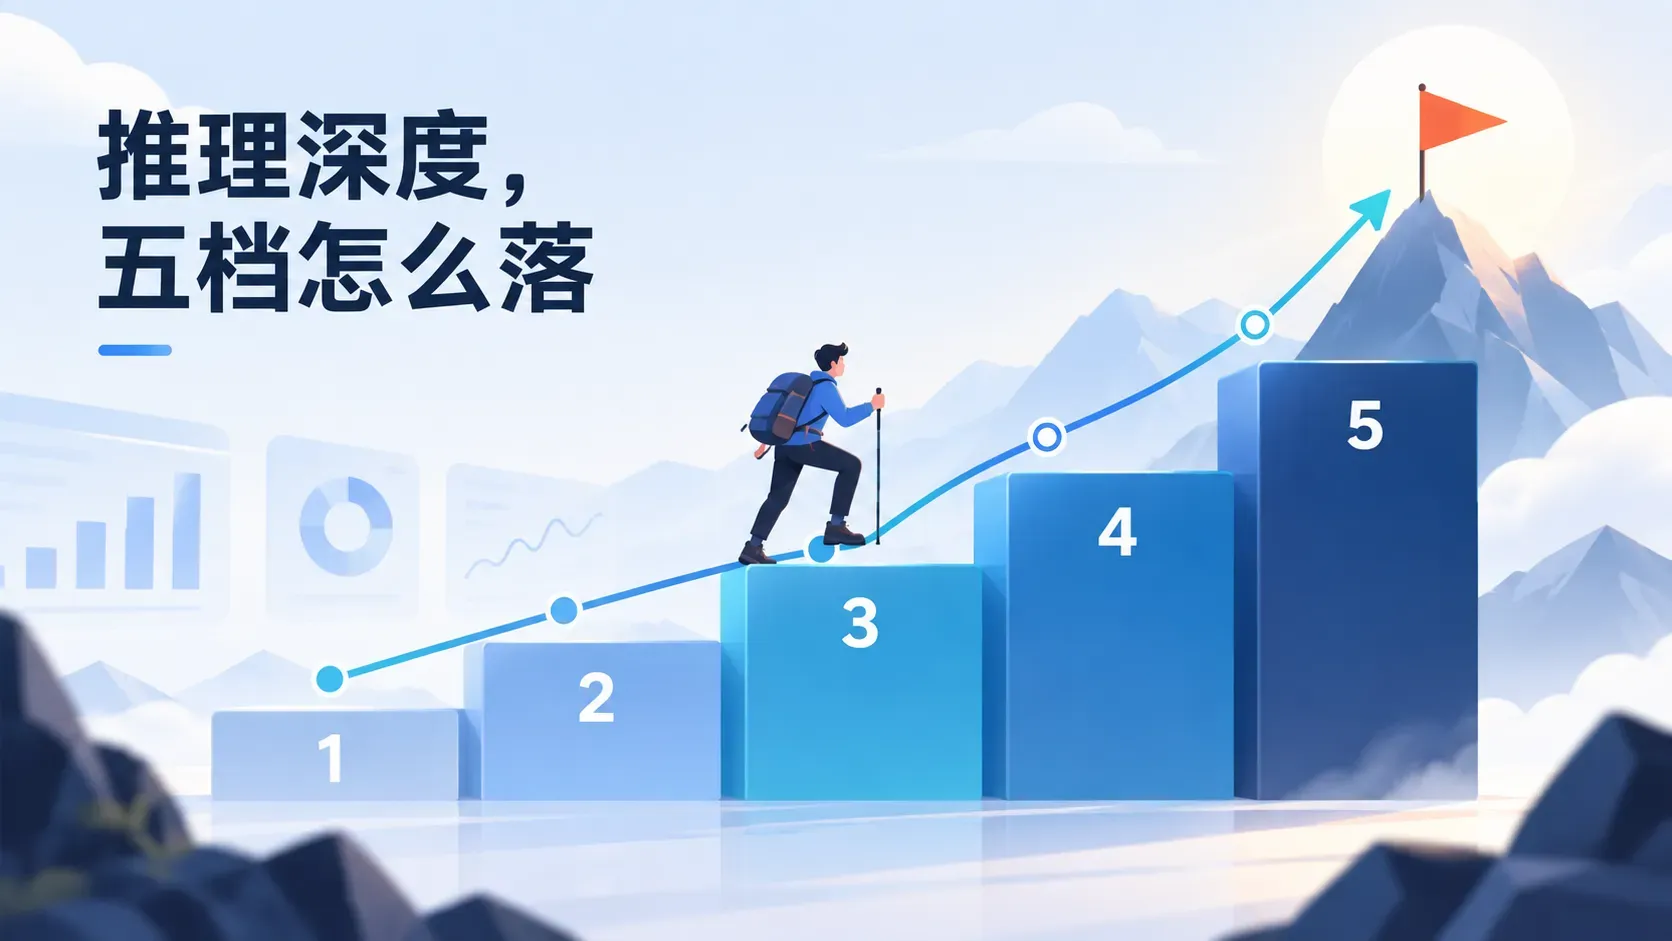
推理深度五档,minimal 几乎不思考,适合纯格式化,low 快速直出,适合简单查询和增删改查,medium 平衡推理与速度,多数日常编程落在这,high 深推理慢但质量好,给复杂调试和跨文件重构,xhigh 最深最慢最贵,留给架构迁移和安全审计这种错了代价大的活。
两个误区要点名。误区一,默认就上最高档。简单任务用 xhigh 不光更慢更费,还可能因为想太多引入不必要的复杂度,结果反而不如 medium。官方文档自己也是这个态度,按任务难度选一档,自己测试工作流里哪档最好,没有越高越好这回事。误区二,把升档当质量补救。结果不行的时候,排查顺序应该是先看提示词是不是含糊,再看项目规则文件缺不缺约束,然后查上下文给够没有、是不是塞了太多无关东西,第四步才检查是不是模型选错了,前面全对仍然不行,最后才从 medium 往 high、xhigh 逐级升。前四步没查就一路拉档,多数时候只是更慢更贵。
读到这里可以记住一张极简矩阵,轻量模型配低推理是最省的角落,批改和机械活都该落在这,主模型配 medium 是日常标准挡,主模型配 high 和 xhigh 是质量优先的深水区。中间有一格基本是浪费,轻量模型配高推理,要深推理就直接换主模型,给 mini 配最高档等于既不够聪明又不省钱。
不知道当前任务该落哪一格,用三步判断。先问难度,这件事是机械重复、改格式、查一下,还是要跨多个文件理解之后才能动手,前者往轻量挡走,后者往主模型加高推理走。再问紧不紧,你会盯着屏幕等结果吗,会就考虑开加速,不会就关掉省用量。最后问代价,改错了好不好回滚,有版本检查点做兜底的,大胆用低挡试,架构迁移、动数据这种难回滚的,才值得上最贵的档。
加速模式的账,企业要算清
加速模式的官方口径很清楚,速度提高约一点五倍,代价是用量按更高倍率消耗,主模型是标准档的两倍半,上一代是两倍。提速一点五倍,付出两到两倍半的用量,这笔账划不划算,取决于你是不是真在等。
我打个比方,加速模式像挂特需号。你人在候诊室干等,特需号买的不是插队是时间,值。任务丢给后台你去开别的会,回家睡觉等结果,就没有任何理由付特需的钱。所以团队规则可以定得很死,加速只在人盯着屏幕等结果的时候开,实时补全常开,跑批、定时任务、长任务一律关。还有一个更省的服务档位,速度更慢但消耗更低,不在乎延迟的批处理可以试,另外加速模式只在用 ChatGPT 账号登录时可用,走 API 计费用的没有这个选项,采购侧要把这条记进对比表。
Fast mode 像挂特需号,只在你真在等的时候才值回票价。
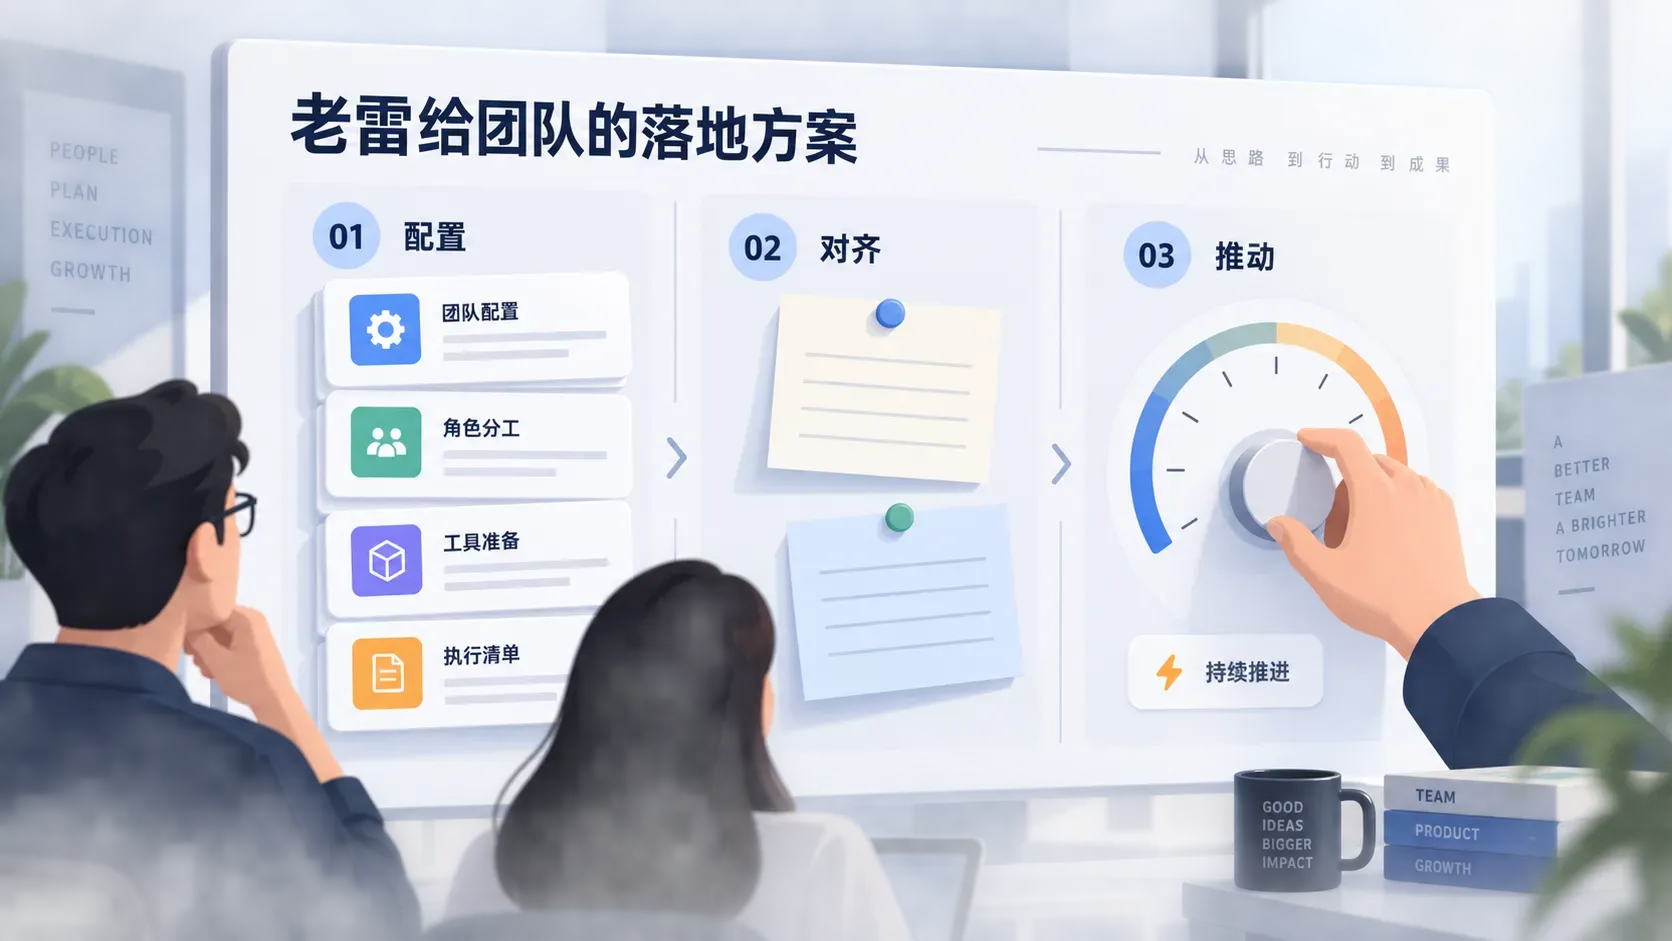
老雷给团队的落地方案
落到执行,老雷的建议是三步走。
第一步,把典型任务打包成配置集。日常默认一套,主模型加中等推理中等输出。批改省用量一套,轻量模型加低推理加简短输出,配合命令行的执行模式后台跑,批量任务写成一条命令循环跑完整个目录,比逐个开会话省得多,别用交互模式一个一个开。复杂重构一套,主模型加 high。极难任务一套,xhigh 配详尽输出,动手前先提交一次当检查点,改坏了能回滚。只读探索一套,轻量模型加只读沙箱,让它看代码别让它热心乱改。一条命令带个名字就能整套切换,命令行独有的能力,桌面端没有这个入口。
第二步,立两条硬规则并写进团队规范。推理深度默认中等档,只有跑不通才升级。加速模式只在人盯着屏幕等时开。光这两条,同样的额度就能明显多撑一阵。配套再记官方点名的四个省用量做法,控制提示词大小别把半个仓库贴进去,项目规则文件按目录分层别堆成一个越长越好的大杂烩,不用的 MCP 服务器关掉,每个都往上下文里塞描述吃额度,能换小模型的任务就换。另外官方没承诺过任何具体省百分比,网上那些精确到个位数的省钱比例,别信。
第三步,每月花五分钟看一次用量面板,看三件事,这个月用了多少还剩多少天,哪个配置集占比最高,有没有本该切轻量却一直挂着主模型的场景。最后这个是最常见也最容易补回来的漏切。子代理的账也顺手算了,每个子代理都独立跑一遍模型加工具调用,一个代理能干完的就别拆,真要并行探索,给子代理用轻量模型。
写到这儿想起车里的变速箱。同一个发动机,老司机山路挂低挡、高速挂高挡,油门刹车拿捏得当,一箱油能多跑一百公里。引擎的功率没变,变的是挡位跟路况的匹配。团队的 Codex 用量也是同一回事,额度是油箱,切档是换挡,制度是那本驾驶手册。
模型名、档位默认值、价格倍率都会随官方文档变,落地前以当前文档为准。但按任务难度切档这个动作本身,会是团队用 AI 编程的第一笔成本素养,这个不过期。