老雷AI实验室
微调落地清单,先过选型关再走六步交付
先把两个数字拍在桌上。
一张 RTX 4090,一万块钱上下,配 QLoRA 方法就能微调一个七十亿参数的开源模型,显存占用六到八个 G。LoRA 方法在云 GPU 上微调 Llama 3 的八十亿参数模型,一千条训练样本,行情价五到十五美元。
微调的硬件和价格门槛,两年时间塌了大半。2024 年干这件事还得租多张 A100,起步就是上千美元,如今一张消费级显卡就能进场。
但我这两年跟着企业做 AI 落地项目,看到的真实卡点根本不在钱上。多数微调项目是死在第一步的,压根没搞清楚该不该用微调。提示词两行能解决的事,有人拉了一个月的训练数据,一个向量库能解决的事,有人烧了两周 GPU。预算花完,工期往后挪,最后上线的模型还不一定打得过调好提示词的通用模型。
老雷把微调这条交付线从头到尾拆了一遍,选型判断、成本账、路线图、数据关卡、验收线,整理成一份可以直接照着走的清单。你要接企业的微调活,或者老板问你「咱们要不要也微调一个」,先过完这篇再报价。
选型关,三级阶梯别跳级
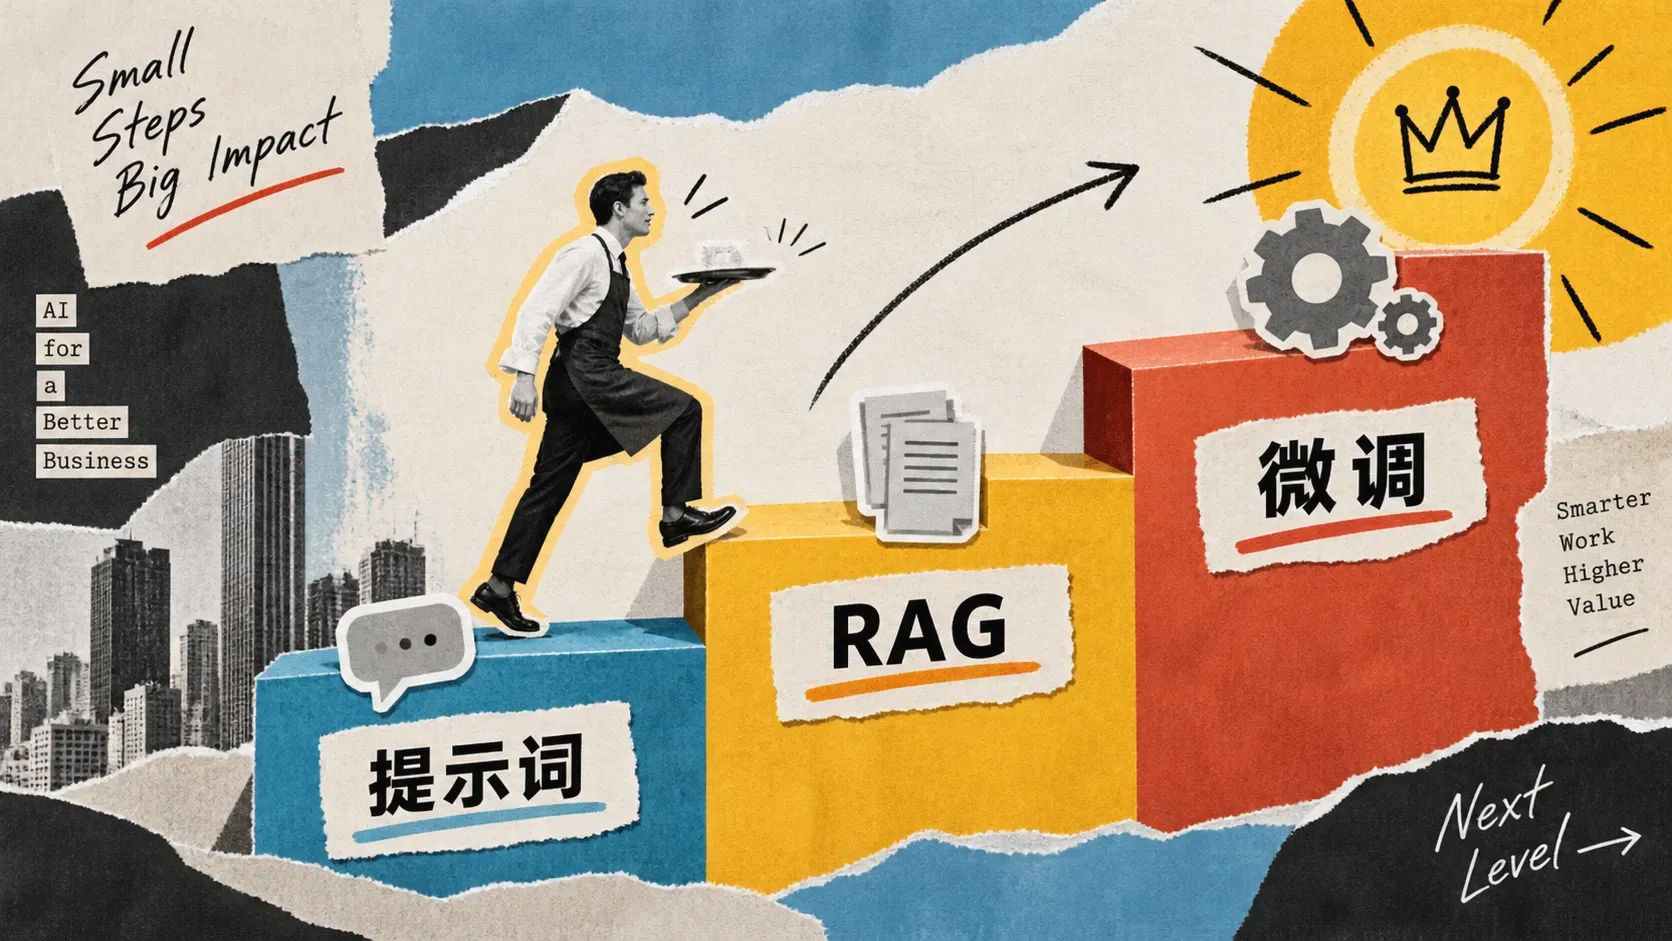
微调、提示词工程、RAG 这三样天天被摆在一起讲,真正分得清的团队不多,它们其实站在三级阶梯上。
提示词工程在第一级,给模型一份更清楚的任务说明,成本几乎为零,分钟级出结果。RAG 在第二级,给模型接一个能随时翻的资料库,回答时查得到最新信息和私有数据,要搭向量库,天级上线。微调在第三级,直接动模型本身,用你的数据把判断标准和输出风格练进权重里,要 GPU 要数据,周级交付。
拿开餐厅打比方,让 AI 替你回复顾客评价。提示词工程是给服务员发一张话术卡,遇到好评说感谢,遇到差评说抱歉,简单场景够用,灵活度有限。RAG 是发一本厚厚的服务手册,复杂情况翻手册找对应的处理办法,服务员的沟通能力本身一点没变。微调是把服务员送去参加专业培训,结业之后餐厅的文化、菜品的讲究、常客的忌口全在他脑子里,张嘴就是行家,不像在念稿。
判断标准就一句话,提示词能解决的,不要上 RAG,RAG 能解决的,不要上微调。微调是最后手段,也是最强手段。
那什么时候轮到微调出场。信号很明确,需求里出现「风格」「判断力」「专业直觉」这类词的时候。格式转换,长文缩成推文,提示词就够。照着产品文档答问题,RAG 就够。要让模型用你们团队的口吻写方案、按你们的理赔尺度判案例、按你们代码库的习惯补代码,这才是微调的主场。
微调要解决的不是让 AI 更聪明,是让 AI 更懂你的业务。
见过太多团队在不需要微调的地方强行微调,时间和资源双双打水漂。这一关务必放在最前面过,过不了就不许进训练场。
还有一个常被忽略的决策维度,上线时间。提示词是分钟级,RAG 是天级,微调是周级,这中间差的是客户的耐心和项目的现金流。客户下周就要看到东西的,先用提示词把方案顶上去跑,边跑边攒数据,攒够了再谈微调,这是最稳的推进节奏。
成本账,门槛已经塌了
技术路线三选一,全参数微调、LoRA、QLoRA。
全参数微调动模型的所有参数,效果上限最高,代价也最高,一个七十亿参数模型要一百到一百二十个 G 显存,这是大厂和研究机构的玩法。LoRA 只训一小部分新增参数,量级在原模型的百分之零点一到一,显存十六到二十四个 G,效果接近全参数,是中小企业有 GPU 团队的主力选择。QLoRA 在 LoRA 基础上加了四比特量化,显存压到六到八个 G,消费级显卡就能跑,效果略低半档,算是个人开发者的入场券。
算一笔账。云 GPU 上 LoRA 微调 Llama 3 八十亿参数模型,一千条样本五到十五美元。OpenAI 的 GPT-4o 微调 API 按 token 计费,中等规模一轮五十到五百美元。手里有台三十二 G 以上统一内存的 Mac,QLoRA 本地就能跑,成本只剩时间和电费。
把这些数字跟两年前摆在一起,门槛降了一个数量级。成本这一项,已经不构成「做不做微调」的否决理由了。
而且往下走的趋势还没停。一键微调的平台越来越多,上传数据、选好基座,剩下的平台替你办完,OpenAI 的微调 API 已经是这个形态,国内的 SiliconFlow 这类平台在价格上更有性价比。数据这一头也在降本,越来越多的实践证明,用 GPT-4、Claude 这类强模型生成的合成数据做训练,效果也能到不错的水平,社区普遍的预期是这条路会把数据准备的成本再压下去一个量级。
六步路线,数据吃掉七成时间
真把一个微调项目交付上线,社区沉淀下来的路线是六步。
第一步需求评估,确认微调确实是最优解,上一节的选型关干的就是这件事,一到两天。第二步数据准备,收集、清洗、标注训练数据,一到四周,整条线最耗时的一段。第三步基座选型,挑基础模型和微调方法,一到两天。第四步训练执行,配超参数、启动训练、盯指标,数小时到数天。第五步评估测试,测试集加人工评估,两到三天。第六步部署上线,服务化、开接口、挂监控,一到两周。
把时间摊开看,有个扎心的事实,第二步数据准备通常吃掉整个项目六到七成的时间。一线交付里还有个不成文的统计,微调项目失败,八成能追溯到数据准备没做扎实。
模型和训练反倒是整条线里最不容易出事的部分,数据才是最大的坑。这个认知顺序别搞反了。
数据关卡,三条死规矩
数据这一关怎么过,给三条能直接执行的规矩。
第一条,数量够用就行。经验法则是分档的,简单的风格迁移,五十到两百条高质量样本就够。要往模型里注入专业知识,一千到五千条。手里连五十条都凑不齐,别做微调,提示词配几个示例大概率效果更好。
第二条,质量碾压数量。一百条精心筛选、认真标注的数据,微调效果通常好过一万条没清洗过的原始数据。宁可少,不可滥。
第三条,先用十条验格式。不同平台对数据格式各有各的要求,OpenAI 的微调 API 要 JSONL,Hugging Face 的框架有自己的数据集结构。实际交付里因为一个字段拼错、一个多余的逗号把训练搞挂的例子,多到不值得同情。老雷的规矩是正式训练之前,先拿十条数据跑一次小样本验证,格式确认没问题再上全量。
这三条每条都不难,难的是团队肯在数据上花耐心。顺手补一个省时间的细节,标注规范要先写后标,什么算一条合格样本、语气词留不留、错字改不改,一页纸写清楚再开工,后面能省掉一半返工。
验收线和起步动作
训练跑完,loss 曲线漂亮,新任务测试全过,这个模型能交付了吗。不一定。
有个坑叫灾难性遗忘,模型学新知识的时候把旧能力一并忘掉。LoRA 和 QLoRA 只动一小部分参数,对这个问题有天然缓解,但缓解不等于免疫。
一线实践里的验收做法是备两套题,一套测新任务,一套测通用能力,微调完成后两套都跑。通用能力掉得明显就要回去调参数,一个可参考的线是降幅超过百分之五,降学习率或者减训练轮数,重新练。给 FDE 提个醒,验收报告里没有通用能力那一栏的话,客户上线后发现的第一个 bug 大概率就是它。
确定要上微调了,动手前先答三个问题。你有什么独特的数据,历史记录、专业知识、风格样本,这是原料。你最想砍掉的重复性脑力劳动是哪一件,这是目标。基座模型在这件事上现在表现怎么样,先测基线,才知道微调带来了多少提升。三个问题都有答案,该不该做、从哪下手,自然就清楚了。
行业方向上,眼下跑得通的思路集中在五块。内容团队把创作者的风格和知识体系做成可复用的数字资产。客服和电商拿它做坐席辅助、评价应对和个性化推荐。法律金融这些专业服务行业拿它消化合同审查、合规报告这类重复文书。医疗和科研拿它加速病历文书、文献综述。制造、能源、物流这些重系统行业拿它做预测性维护和调度优化,政务和保险也在跟进,政策问答、理赔核保都是重重复、重规范的活。共同点只有一个,手里攥着高质量的行业数据,缺的是人手。
数据是微调的护城河,模型会贬值,干净又独特的行业数据不会。
老雷的判断是,微调最大的受益者就是有数据但缺人手的行业,把专家经验编码成可规模化调用的系统,这笔账怎么算都划算。至于你手上那笔账,从答好上面三个问题开始算。