老雷AI实验室
微调、RAG还是提示词?AI定制的三条路一次讲清
为什么有人的 AI 回答精准得像行业专家,你的 AI 只会输出正确而无用的废话?
秘密在微调,用你的行业数据、业务规则和风格要求,重新训练模型的判断标准和输出风格。但对这个词存在两个极端的误解。一种人把它当万能药,什么问题都想微调解决。另一种人觉得它又贵又难,跟自己无关。两种都错。
这篇把 AI 定制的三条路线一次讲清,帮你选对路、花对钱。先声明一点,文中涉及的行业案例均为基于真实痛点设计的思路演示,不指向任何具体企业。
三条路线,一张表定乾坤
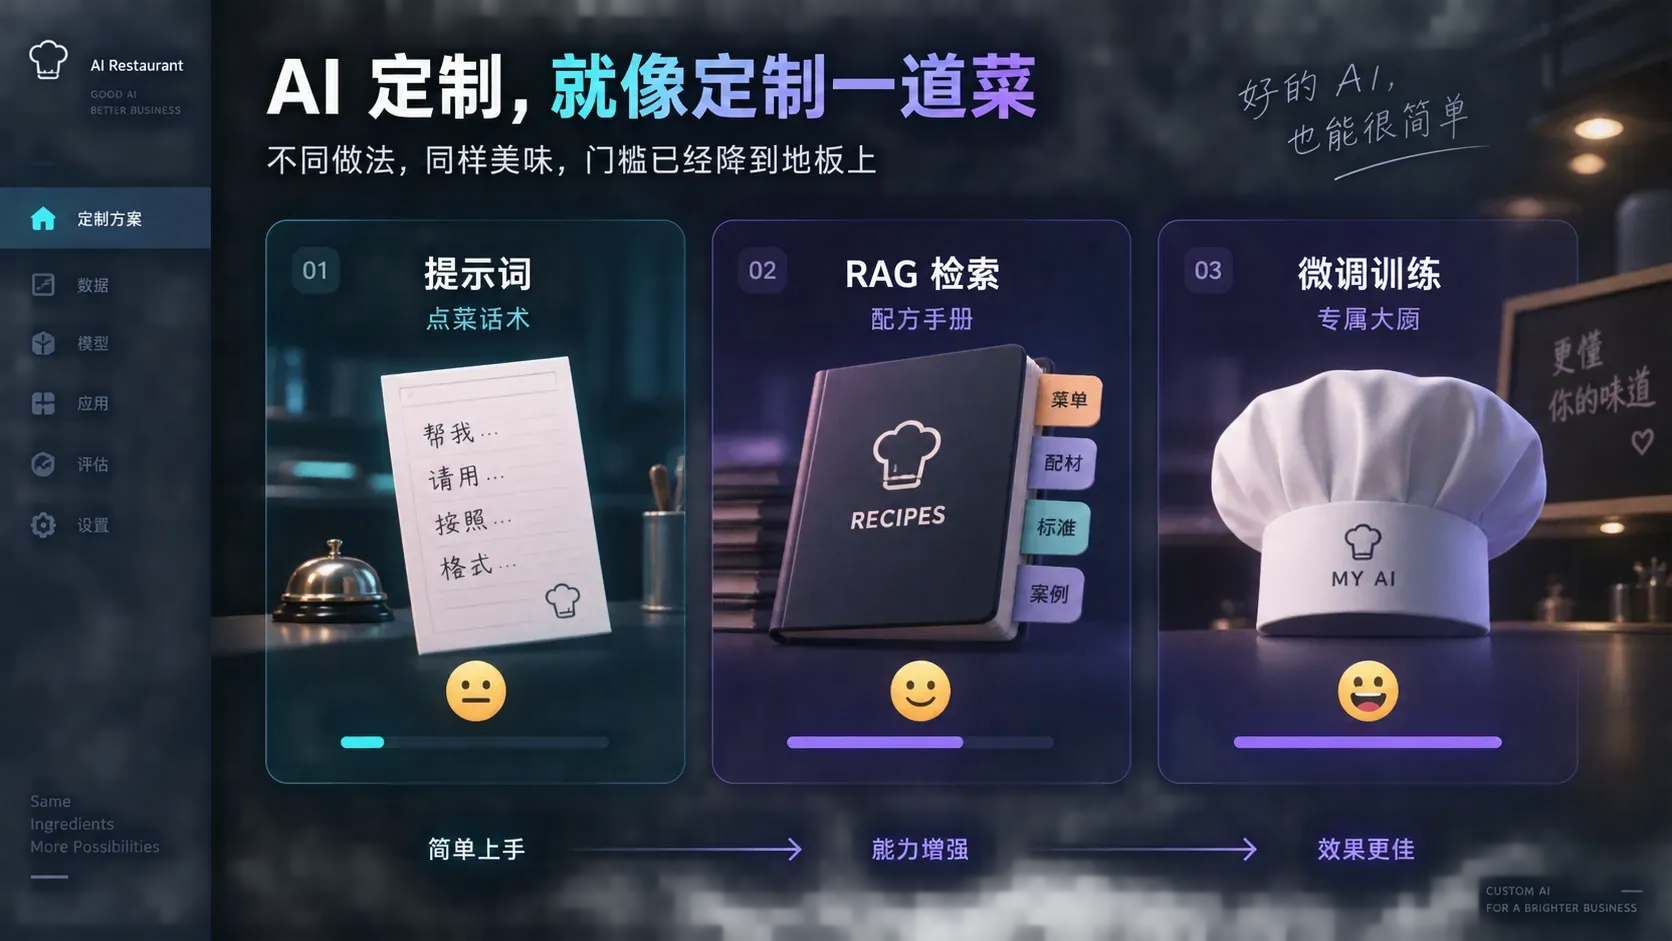
先看三种方法的本质区别。提示词工程,给 AI 更清晰的指令,几乎零成本,分钟级完成。RAG 检索增强,给 AI 一个参考资料库,中等成本,天级部署。微调,直接改变 AI 的大脑,成本较高,周级完成训练和上线。
用一个餐厅的类比说透。提示词工程是给服务员一张标准话术卡,遇到好评说感谢、遇到差评说抱歉,简单场景够用但灵活度有限。RAG 是给服务员一本详细的客户服务手册,遇到复杂情况可以翻手册,但服务员的沟通能力本身没变。微调是把服务员送去参加专业培训,培训完,你餐厅的文化、菜品特点、常见问题他都了然于胸,回复自然流畅,完全不像在念稿。
判断铁律只有一条,按成本从低到高试,提示词能解决的不用 RAG,RAG 能解决的不用微调。 微调是最后手段,也是最强手段。
什么时候才真正需要微调?当你需要模型表现出某种特定的风格、判断力或专业直觉时。如果你的需求只是格式转换或者知识检索,提示词和 RAG 就足够了。强行微调,只会浪费时间和资源。
微调的门槛,已经降到地板上
很多人对微调的印象还停留在「只有大公司能玩」。2025 到 2026 年,这项技术发生了深刻的民主化,功臣是 LoRA 和 QLoRA 这两项参数高效微调技术。
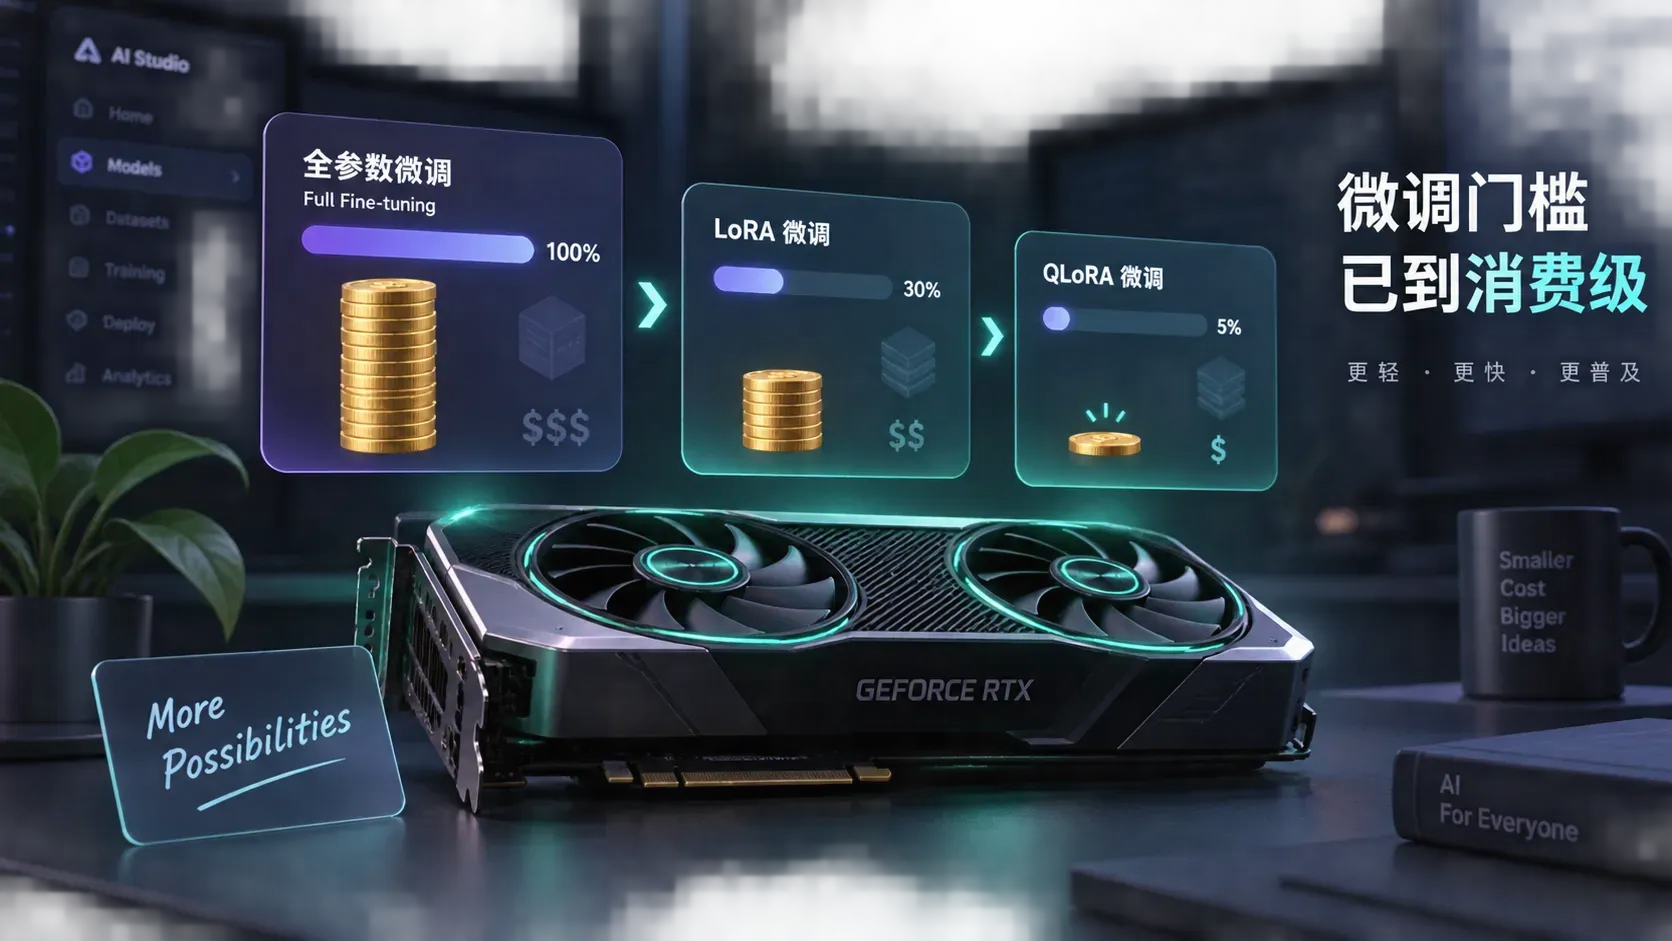
技术选型三档。全参数微调,训练全部参数,效果最优,但显存需求高达一百多 GB,只适合大公司和研究机构。LoRA,只训练百分之零点一到一的参数,效果接近全参数,显存需求降到十几 GB,适合有 GPU 的中小企业。QLoRA,在 LoRA 基础上做四比特量化,显存需求只要六到八 GB,一张消费级显卡就能微调七十亿参数的模型。
成本数据更直接。用 LoRA 方法在云 GPU 上微调一个八十亿参数模型,一千条训练样本的成本大约五到十五美元。用大模型厂商的微调接口,一次中等规模训练约五十到五百美元。如果你有一台大内存的 Mac,用 QLoRA 在本地就能完成,成本几乎只有电费。
和两年前比,这个门槛降了一个数量级。微调不再是大公司的专利,这是近几年 AI 领域最重要的民主化进展之一。
这条民主化曲线还在往下压。今天一张消费级显卡能干的事,两年前要租一整排专业卡。对 FDE 的含义很具体,给中小客户报方案的时候,私有微调不再是「做不了」,而是「想做就有性价比的做法」,报价单可以更大胆一些。
一张图看懂微调能干什么
微调的本质一句话,把通用 AI 变成你的行业专家。基础大模型像一个什么都学过但没有任何行业经验的应届高材生,微调就是让他在你的公司实习三个月,用你的业务数据、行业术语和工作规范训练他,出来之后「你的业务他最懂」。
它按领域分五个板块,每个板块的核心价值不同。内容与传播板块,把创作者的风格规模化。商业与客户板块,做个性化体验加降低运营成本。专业服务板块,替代重复性的脑力劳动。科技与研发板块,加速专业发现。基础设施板块,让复杂系统更智能。
每个板块里都藏着值得展开的场景。电商客服用微调对齐品牌话术,售后回复的满意度肉眼可见地回升。人力资源用微调学习公司制度,新员工咨询的准确率超过老员工口口相传。制造和能源行业用微调沉淀老师傅的检修经验,设备故障的判断从「凭手感」变成「有章法」。政务场景对数据私有化要求最高,反而最适合用可本地部署的小模型微调。这些场景的共性是,行业 know-how 越深,微调的回报越大。
拿一个场景走一遍完整的判断流程。假设你是做跨境电商的,希望 AI 用你店铺的语气回复英文客户咨询。先试提示词,把语气规范写进指令,如果八成的回复已经达标,剩下两成靠人工微调,这事到此为止。如果语气始终不对,把你们历史上最好的五百条真实回复做成 RAG 参考库,回复质量再上一个台阶。如果三个月后你发现模型依然学不会某些只有你们才懂的行话和分寸感,这时候才轮到微调上场。按这个顺序走,每一分钱都花在刀刃上。
举一个思路演示。一位历史类知识创作者,把过去五年的五百多篇文章和视频逐字稿整理标注后用于微调。之后输入核心观点和资料索引,模型半小时内产出一篇符合他个人风格的初稿,包括他惯用的典故和表达习惯,整体产出效率提升过半。这个思路演示说明的是一件事,微调不是替代创作者,是把创作者最宝贵的风格和知识体系,编码成可反复调用的数字资产。
先看内容和传播这个板块的思路演示。一位历史类知识创作者,把过去五年的五百多篇文章和视频逐字稿整理标注后用于微调。之后输入核心观点和资料索引,模型半小时内产出一篇符合他个人风格的初稿,包括他惯用的典故和表达习惯,整体产出效率提升过半。这个思路演示说明的是一件事,微调不是替代创作者,是把创作者最宝贵的风格和知识体系,编码成可反复调用的数字资产。
再看品牌场景。用品牌的头部文案、声音手册和用户画像做微调之后,营销人员一句「为新款跑鞋写五条图文文案,强调某两个卖点」,几秒内出五个不同版本,风格统一且千人千面。
上线前的三条纪律
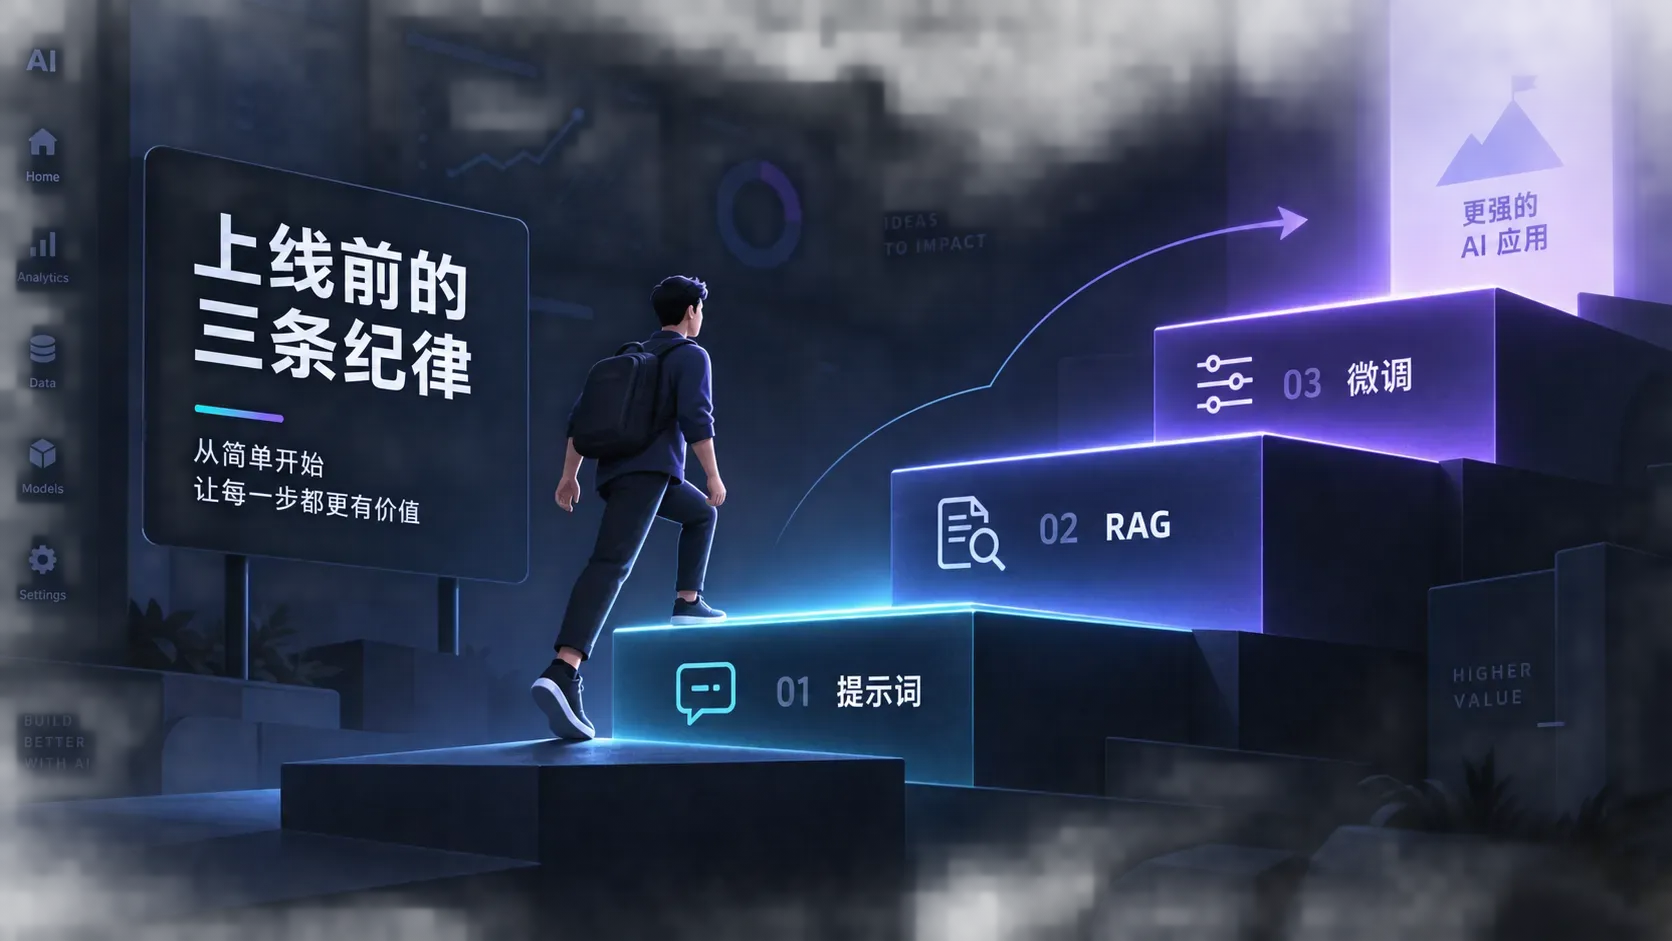
第一,数据质量大于数据数量。一千条标注精良的样本,胜过十万条乱七八糟的原始数据。标注环节偷的懒,训练会加倍还回来。
第二,先建评测再开训练。没有评测集,你根本不知道微调后的模型是变好了还是变差了。训练之前先准备一组能区分好坏答案的测试题。
第三,从 QLoRA 起步。除非你是研究机构,否则别碰全参数微调,百分之零点几的参数训练已经能逼近全参数效果,成本差两个数量级。
老雷见过最可惜的案例,是团队样本都备齐了,却卡在「要不要微调」的犹豫里拖了三个月。回到那张对比表,十分钟就能做出决策。犹豫的成本,往往比错误的成本更高。
部署节奏上给个参考。第一个月用一百条高质量样本做 QLoRA 试点,验证方向;第二个月把样本扩到五百条并建评测集;第三个月根据评测结果决定加码还是止损。小步快跑,每一步都有明确的预期产出,这是微调项目不烂尾的全部秘密。顺便说一句,这些数字也回答了很多老板关心的预算问题,微调试错的门槛已经低到普通团队可以承受。
提示词管表达,RAG 管知识,微调管本能。三层各司其职,别让最重的工具干最轻的活。这是老雷反复强调的选型心法。
写到这儿想起学徒制。行会时代的匠人培养靠的是三年学徒跟着师傅耳濡目染,成本是三年的青春。微调做的事情一模一样,只是学徒期被压缩成了几天的训练时间,师傅的经验换成了结构化的数据。
AI 定制的民主化,说到底是学徒制的工业化。谁能最快把自己的行业经验「教」给 AI,谁就先养出了自己家的行业专家。而且这个专家越用越懂你,因为它的知识库和微调数据都在你自己手里持续积累,这也是我最后想强调的一点。