老雷AI实验室
小红书卡片图不用设计了,DeepSeek V3 写一段 HTML 直接出图
做小红书的人都知道,真正的瓶颈不是选题,是设计。一篇像样的笔记,一张封面加三四张内容页,每张都要讲排版、配色、字体层次。手动做一套,一个小时就没了。一天要发五篇的号,五个小时全耗在改图上,人成了排版工具的人肉外设。
过去大家的第一反应是找 Midjourney 画插画,但插画替代不了内容页。读者要看的不是一张漂亮的图,是文字清晰、层次分明、能直接读的信息卡片。小红书这个生态里,卡片图有天然的收藏属性,读者收藏一张干货卡片,心理账户里记的是「以后用得上」,比点赞值钱。插画解决不了这个问题,模板也解决不了,模板做五十张就撞脸,用户刷两页就把你认出来然后划走。
转机出现在 2025 年 3 月。DeepSeek 更新了 V3 模型,前端代码生成能力上了一个台阶,能直接输出排版精美的 HTML 页面。有人顺着这个能力搭了一条 Make 流水线,输入任意书籍链接或网页地址,自动产出成套的小红书图文笔记,封面页、内容页全带。一键运行,一次出一千篇都不成问题。
老雷把这条流水线完整拆开看过,五段架构和每个环节的关键参数、容易翻车的角落,今天全交给你。
五段架构,从一条链接到一叠卡片图
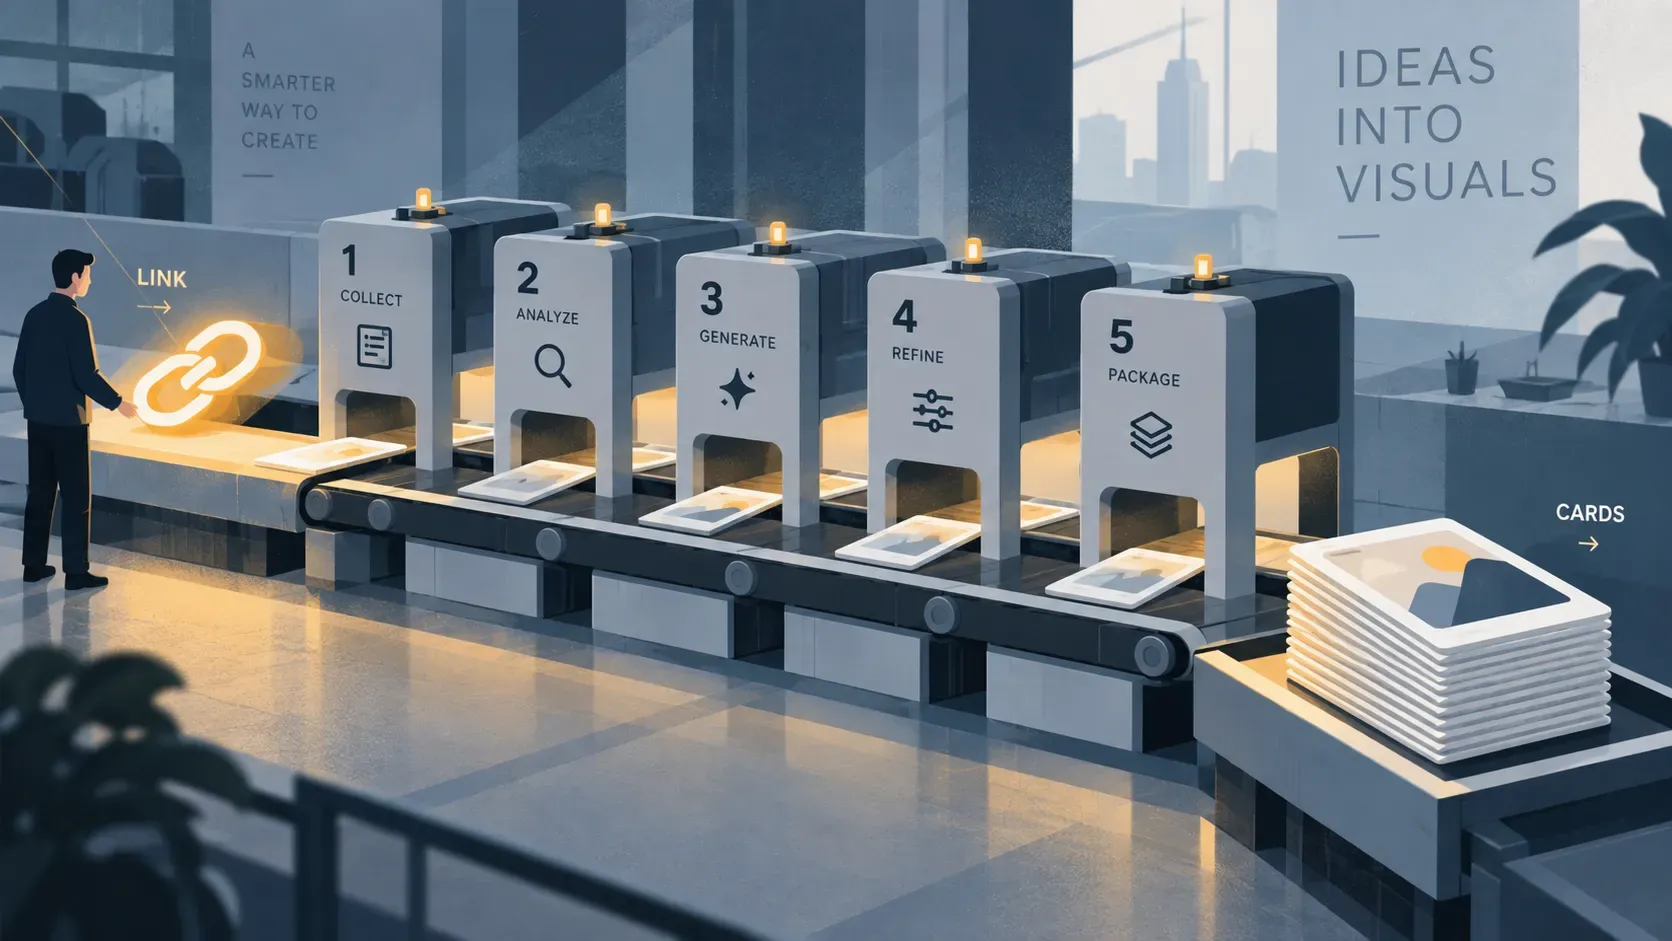
先看全局,五个阶段一条直线。
第一段是内容抓取。Notion 数据库存链接,字段很简洁,标题、URL、图片风格、状态、输出数量,五样。状态是单选,拨到「开始」就触发,跑完自动标「已完成」,批量任务做到哪一篇一目了然,不会重复跑也不会漏跑。URL 的兼容面很宽,微信文章、Z-Library 的书籍直链、普通网页,凡是 Jina Reader 能公开抓到的都行。Jina 已经出了官方的 Make 模块,不用再走 HTTP 手搓,超时设 300 秒。
有个坑提前说,书籍类的大文件几十兆,偶尔会超时报错,重跑一次通常就好。频繁失败的话,考虑自己搭一个 Cloudflare R2 来托管文件。
第二段是文本切分,Repeater 加 Substring,这是批量的钥匙,下面单独说。
第三段是笔记文案,DeepSeek R1 出标题、正文、标签、简介。
第四段是结构化,DeepSeek V3 把上一环节的结果清洗成标准 JSON。
第五段是图片生成,这里分成两个子流程。封面一个,内容页一个,内容页用 Iterator 把三段正文逐个发出去。两条子流程的动作一样,V3 写 HTML 代码,正则提取出纯代码部分,交给 HCTI 渲染成图,上传图床拿到永久链接,随后经 Notion 的附录模块存回数据库。一条链接跑完,数据库里躺着的是一套可以直接发布的笔记。
两个模型,各干各的活
有人会问,为什么不干脆让 V3 一步到位,又写文案又出代码。分工才是这套流程的聪明处。R1 是推理模型,出文案之前会先在心里打草稿,写出来的标题更抓人,段落的钩子更准。V3 是聊天模型,响应快,便宜,还支持格式约束。各用所长,谁也不越界。
文案环节的提示词要求很明确,标题 20 字以内,贴小红书的搜索习惯。正文分三部分,每部分 160 到 200 字,正好对应三张内容页。标签 3 到 5 个。再加一段 300 字的简介。输出约定成 JSON 结构,标题、标签、简介、正文段落数组,各占一个字段。
但 R1 有个毛病,不支持强制 JSON 输出,只能选 Text 格式,吐出来的东西经常夹杂思考过程和其他文字,直接解析会报错。
解法是接一个 V3 聊天模型做结构化清洗。V3 支持 JSON 强制输出,提示词只让它干一件事,把上一环节输出里的 JSON 部分提取出来,保证格式可解析,后面再接一个 Parse JSON 模块。
这个组合值得写进你的工具箱,强模型负责创作,便宜模型负责格式化。不只是一篇笔记的流程,放到哪儿都好使。
HTML 出图,提示词才是灵魂
整套流水线最惊艳的就是这一步,V3 直接写封面的 HTML 代码。提示词里有几个硬指标。
尺寸 1080 乘 1440 像素,3 比 4 比例,直角边框。这个比例是照着小红书信息流的卡片规格定的,发出去不裁边。文字占页面至少七成,3 到 4 种字号造层次感,主标题的字号是副标题的三倍以上,关键词用描边、高亮做特殊处理。技术栈用现代 CSS,flex、grid、变量、渐变都放开用,挂 Google Fonts,可以引 Font Awesome 的图标。提示词里还要写进账号名和一句标语,品牌植入从第一张图就开始。
V3 的输出里除了 HTML 还有解释文字,所以 HCTI 之前要过一道 Match Pattern 正则,把纯代码抠出来。HCTI 那边把 Viewport 设成 1080 乘 1440,渲染出来的图就严丝合缝。
封面吃的是标题和简介,外加 Notion 里配置的图片风格提示词。风格提示词一换,出来的封面完全是两个物种。
内容页的参数略有不同。文字占比提到八成,字号层次减到两种,任务从吸引点击变成完整展示正文。
批量的钥匙在切分
Repeater 有两个关键参数。重复次数对应 Notion 里的输出数量,想出几篇设几篇。初始值控制从文本的第几部分开始切,设 1 就从头开始,书籍类素材开头常常没有干货,设成 10 直接跳过前奏。
Set Variable 里用 Substring 截取,从 i 乘 2000 到 i 加 1 乘 2000,每一圈循环拿到不同位置的片段当素材。一本书切几十段,每段都能喂出一篇笔记。2000 字符这个档位是有讲究的,切太短,一篇笔记的内容撑不满三张内容页,切太长,单张卡片塞不下还得二次删减。照抄这个参数,能少走弯路。
老雷提个醒,先设 3 到 5 篇小批量跑,风格和质量都满意了再放量。输出数量理论上不设限,设 10、100、1000 都行,素材够长就接着产。想出英文笔记也行,改 R1 提示词里的输出语言,其他环节一个字都不用动。
实测五个赛道之后,说说值不值得上
实测的案例铺得挺开。AI 编程对比,DeepSeek V3 对 Claude 3.7 的实测文章,封面走科技感设计,内容页直接摆测试数据。巴菲特投资,价值投资的书转成三步投资法卡片,封面大气,一套三张挂着像正经的投教内容。小红书运营,爆款技巧转成实操指南,七个月涨粉一百万这种标题够抓人。血型心理,A 型血恋爱密码,粉色系少女风,正贴目标受众的审美。SEO 技巧,15 个秘籍转成要点卡片,简洁清晰。
五个领域五种视觉,说明这条链路不挑赛道,挑的是风格提示词的质量。同一本书的片段,换成不同的风格描述,出图从性冷淡风到插画风完全看不出是一个娘胎里出来的。图片质量不稳定的时候,八成是风格提示词太弱,拿已经验证过的优质设计去提取提示词,比凭空描述靠谱得多。
风格提示词从哪来,可以专门搭一条提取工作流,丢一张你喜欢的小红书截图进去,自动分析配色方案、构图方式、字体选择,吐一段能直接用的风格描述。看到好看的卡片设计,等于可以一键抄走它的视觉。
成本侧也交代一下。HCTI 有免费额度,用量大了再付费订阅。图床用 Cloudinary,每月 25 个免费点数,撑上千张图片上传没问题。DeepSeek 的 API 本身便宜到基本可以忽略。
回头再看这类工作流的进化,路径很清楚。2024 年 6 月是纯文字笔记,没有图,靠文字堆出干货感。后来用 Recraft 这类图像模型生成插画,图文算是凑齐了,但插画上的字是模型画出来的,十个字错三个。再后来是 HTML 模板替换文字,视觉稳了,文字也真了,可几十套模板用下来全撞脸。到这一代,完全自编程,没有模板,千人千面,每次出图都是现写的前端代码。
它出的不是一张图,是一段可以版本管理、可以微调、可以复用的代码。模板锁死下限,自编程放开上限。AI 设计师这四个字,在这一代模型上,第一次像是真的。
下一步动作很简单,把你最近一篇笔记的文案丢进去,风格提示词先抄一套你喜欢的卡片设计,跑 3 篇看看效果。不满意就换风格描述再跑一轮,一轮的成本低到可以忽略,试错完全试得起。跑通了再想放量的事。
对要批量产内容的团队,这条链路省下的不是设计费,是每一个等着改图的一小时。给实施者多提一句,风格提示词别散落在各次运行的临时变量里,把它沉淀成团队的风格资产库,一条描述对应一种验证过的视觉,新笔记套老风格,品牌感才不会随着量产被稀释。这也是老雷AI实验室盯着的方向,让模型的能力,直接变成产线上的一环。