老雷AI实验室
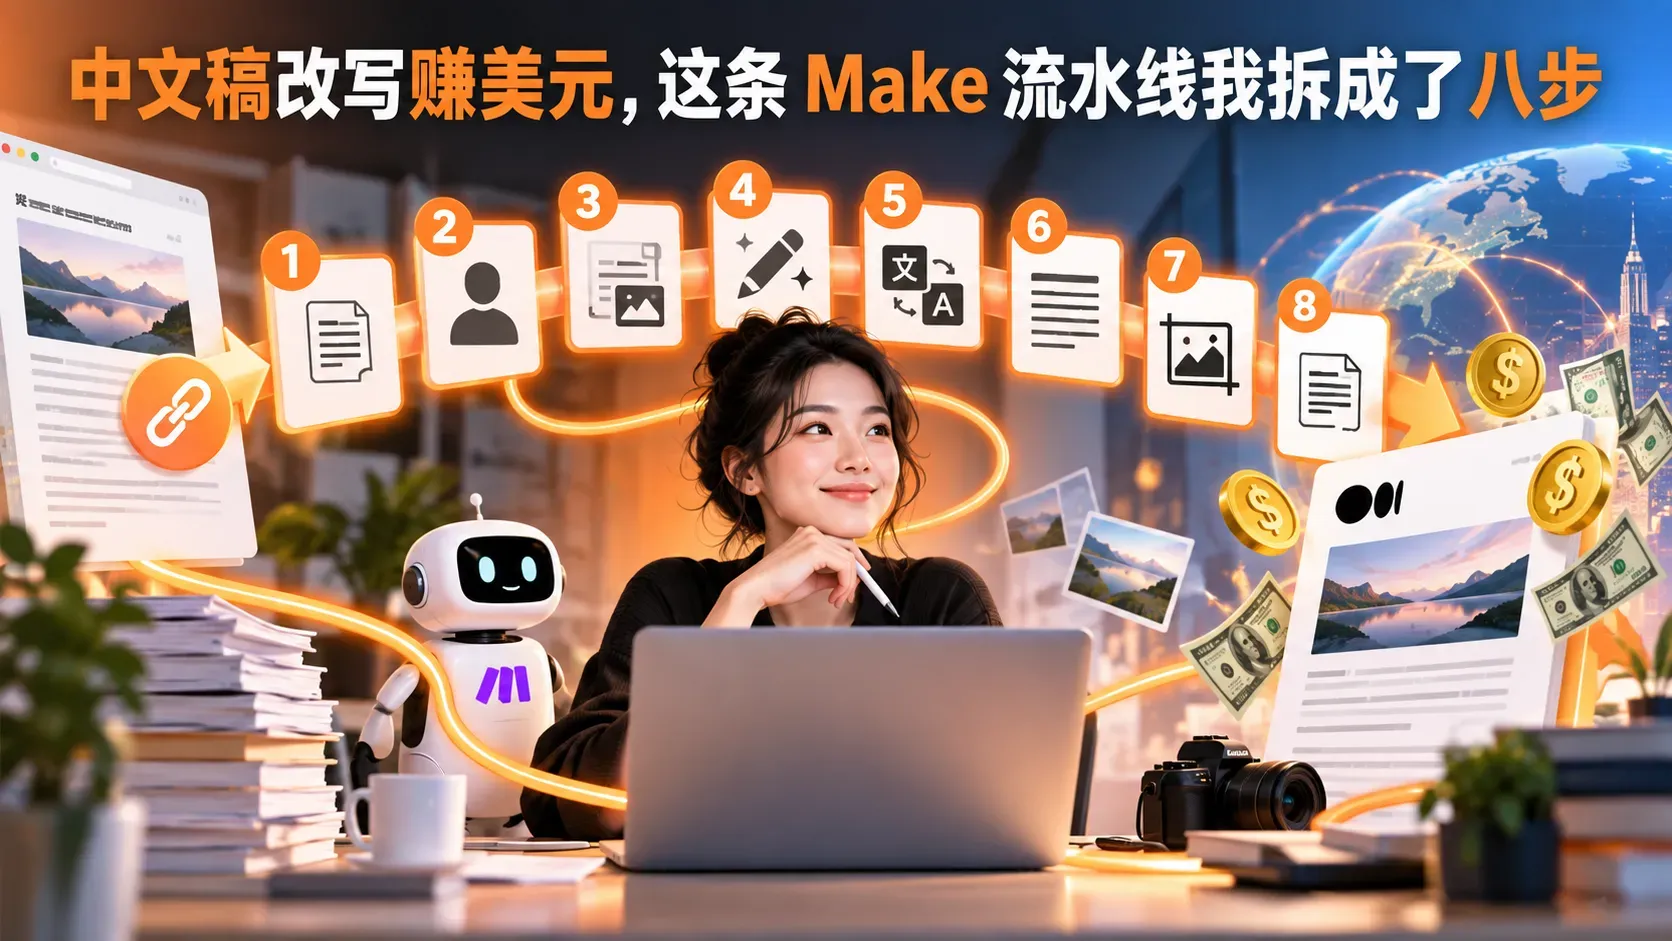
中文稿改写赚美元,这条 Make 流水线我拆成了八步
先看一对句子。
原文是这么写的,茉莉花的花香,属于你无法忽略的那一种。
改写之后,变成了这样,说起茉莉花,我总想起那年在福州老城区徘徊时,巷口飘来的若隐若现的花香。
第二句读起来像一个人真的在回忆。有城市,有巷口,有一段说不清来历的情绪。可这两句讲的,是同一朵花。
这就是我今天要拆的这条 Make 流水线干的事。一条中文链接进去,出来一篇带着完整人设的深度改写稿,再翻译成英文发到 Medium,靠它的付费阅读分成赚美元。这条路径有人完整实测过,确实能跑出被动的收入。
老雷把整条流水线拆成八个环节,每个环节的要点和坑,一次交给你。你要是想照着搭一份,这篇可以当施工图用,八个模块各自的参数、容易翻车的位置、搭完之后怎么验收,全在里面。
这条流水线在干什么
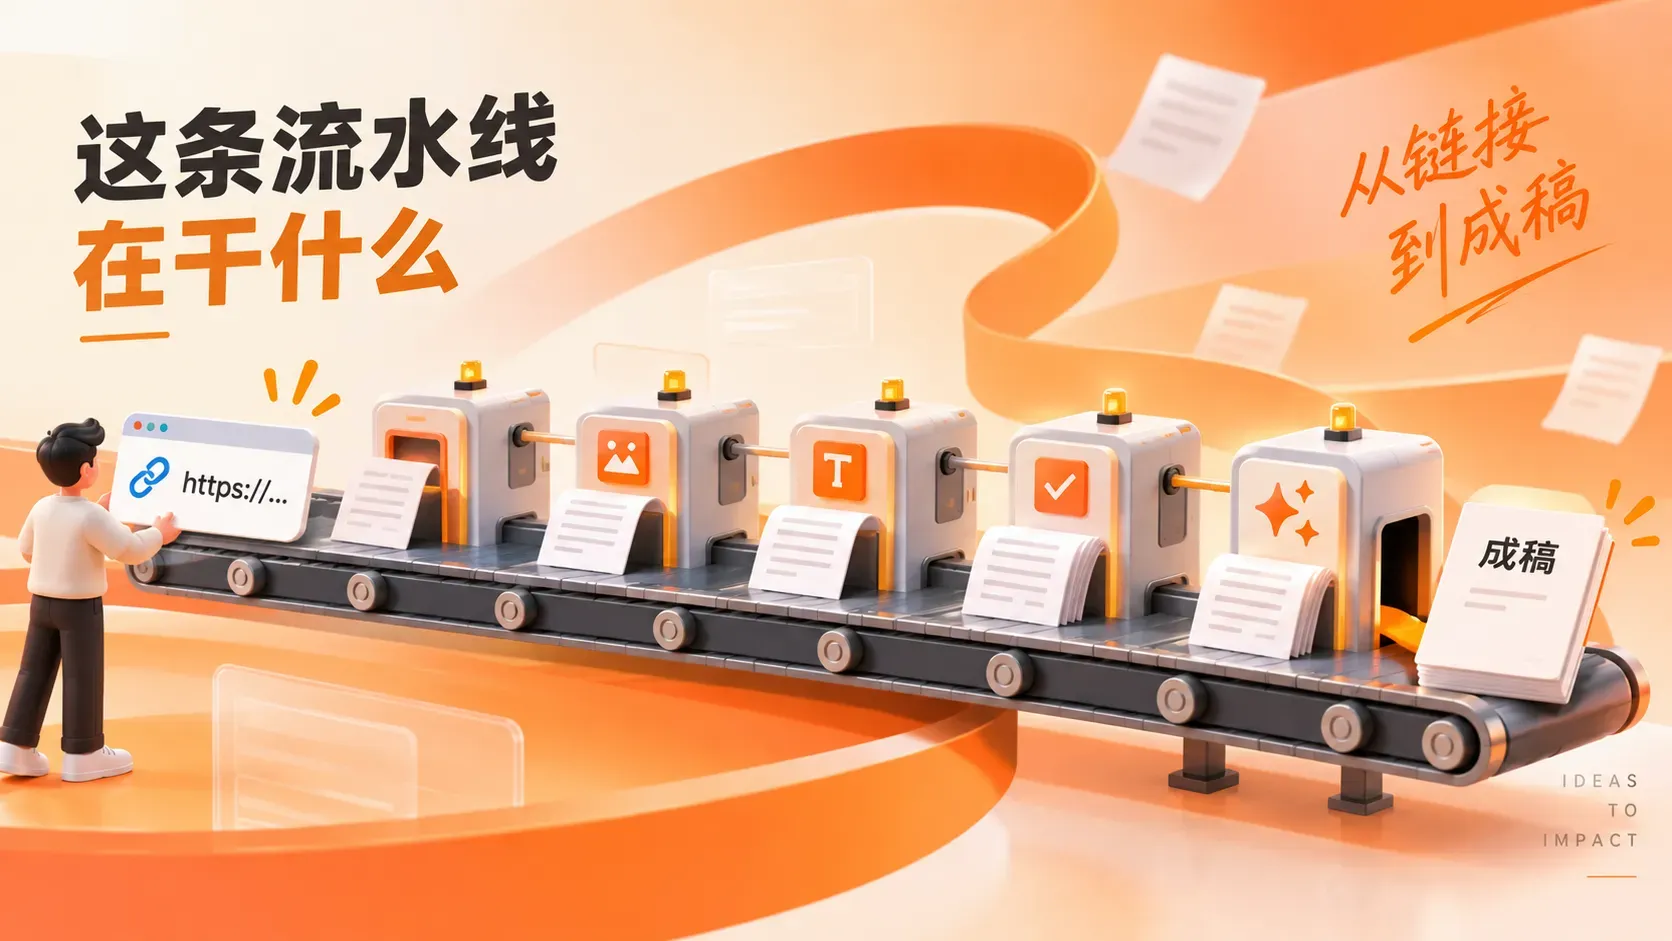
先看架构,整条链路是一条直线,九个模块串起来。
起点在 Notion。建一个数据库,放文章链接和 IP 配置,状态拨到「开始」,工作流自动触发。Jina Reader 先把原文全文抓回来。
第一个技术关键点跟着就来了,长文本切分。老办法是让大模型把文本转成数组,但模型的输出上限就两三千字,万字长文根本玩不转。这里的解法是 Jina 的分段接口,Return Chunks 设为 true,Token 数设 2000,一万字还是三万字,都能切成均匀的段落。
切出来的每一段,通过 OpenRouter 调 Perplexity,搜一轮相关的背景资料。这一步不是可省的装饰。补充素材干两件事,一是给改写模型递事实依据,压住幻觉,二是给文章加信息量,让它不只是换个说法,而是真的有增值。一段中文讲新能源汽车,Perplexity 就去补这个领域的最新动态和数据,改写模型手里有粮,写出来的东西才有骨头。成本也实测过,一篇万字文章的素材抓取,几毛钱以内,这笔钱换来的深度提升,划算。
然后是内容标准化,把原文里的广告、推广、预告清干净。这里藏着一个很深的坑,Jina 处理 Markdown 格式的图片时会丢掉叹号,图片链接直接渲染不出来,要用正则表达式把这步修回来。
再往后是主角登场,Claude 3.7 接手逐句改写。改写分两个阶段,第一段没有前文可参考,直接基于原文、素材和人设往下写,要求是逐句优化,维持原句数量,靠同义转换、句式重构、修辞运用把表达整个换血。从第二段开始,提示词里多传一份前文,要求承上启下,风格跟前面保持一致,不然九段文字九种腔调,拼起来就是灾难。两个阶段都写死了同一条纪律,忠实于原文和素材,不许虚构数据、事件、人物。这条纪律是整套东西的刹车,删了它,流水线产出的是一篇流畅的假新闻。
改完的稿子还剩一项脏活,图片水印。原文配图通常带水印,这里用一个动态裁切函数自动去掉,裁切参数按图片实际尺寸算,底部、顶部、左右四个方向都能裁。处理完成稿存回 Notion,流程结束。
人设不是一句话,是一份档案
普通的文章改写,是同义词替换加句式调整,读起来像换了个说法,查重一跑一个准。
这条流水线做的是另一回事,IP 代入式改写。大模型不是在改文章,它是以你定义的那个人设的身份,把自己的经历、观点、感受,长进文章里。开头那对茉莉花的句子就是样品,加进去的是主观感受和个人记忆。主观的东西没有对错,查重工具抓不到文字层面的关联,因为字面上确实是两篇文章。
核心信息一点没丢。数据、事实、观点方向全保留,被换掉的只有表达方式。这也是为什么它敢叫深度改写。
这套玩法的真正资产,是 Notion 里那份 IP 档案。四个要素,一个都不能省。
成长经历,在哪个城市长大,什么样的文化氛围。求学背景,哪些学校,什么专业,有没有海外经历。职业经验,什么行业,什么职位,具体干过什么。个人特质,写作风格、兴趣爱好、价值观。
照着这个模板,社区里跑通的四份档案可以参考。茶文化方向,苏州成长经历,身份是生活美学和东方文化的专栏作者,风格定义成温软克制,在细节里营造情感共鸣。财经方向,苏州长大,三年外贸做的北美市场,自己炒美股,改特斯拉财报的时候,外贸期间观察到的市场趋势、2020 年疫情期间投资美股的经历,全都自然长进了文章。美妆方向,杭州长大,艺术院校毕业,美妆电商三年,风格定为闺蜜式表达。跨境电商方向,上海成长,法国留学,法德三语,改到 TikTok 爆款保温杯的文章,行业黑话顺手就来,在跨境电商团队里,我们管这叫「一句话围」。
同一篇文章,换一份档案,出来就是完全不同的一个人写的。
改写的护城河不是文字游戏,是档案里那段没人能复制的经历。
八步交付清单
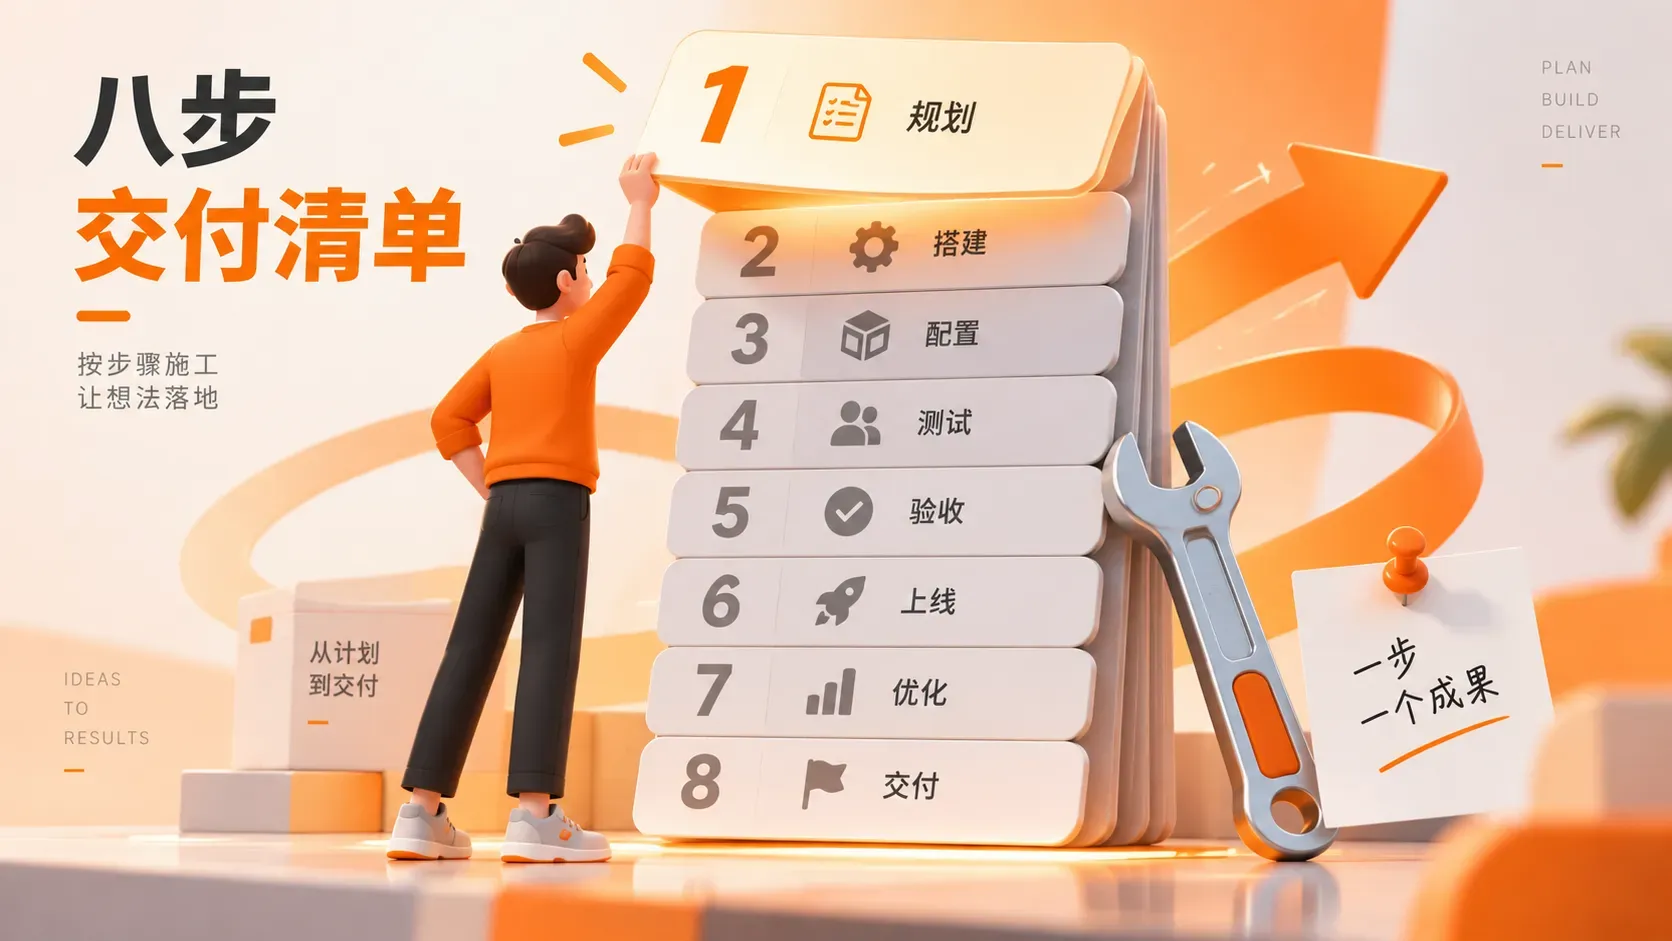
要动手搭的实施者,老雷把全流程压成八步,每步一句要点。
- Notion 建库,字段至少有链接、IP 档案、状态三样
- Jina Reader 抓正文,反爬严的链接多试两次,还不行就手动把内容贴进文本字段
- Jina 分段接口切文,2000 字符一档,Return Chunks 开 true
- 每段走 OpenRouter 调 Perplexity,抓背景素材
- 标准化清洗,清广告,修图片叹号
- Claude 3.7 两阶段改写,首段独立成文,后续段落带前文衔接
- 图片动态裁切去水印,按宽高比算比例,横图竖图分开处理
- 存回 Notion,人工终审,再进翻译和发布
第七步多说一句。水印裁切别图省事用固定比例,比如统一裁掉底部 8%,竖图会被裁过头。正确做法是写个动态函数,按图片实际宽高比算裁切量,四个方向都能裁。
第八步的人工终审不能省。自动化把产能放大之后,终审是唯一的质量闸门。
搭建的时候别贪快,先拿一条链接把八步全跑通,人设档案用你自己真实经历写一份,看输出对不对味,再考虑换赛道、加批量。一口气堆模块,出了问题九个模块挨个排查,比从零搭还慢。
三种写法,别用错地方
同一套工作流,换提示词和模型,能出三种东西,用错地方会白折腾。
Claude 3.7 加 IP 风格化,改写最狠,查重最低,适合 Medium 这种吃个人故事的平台,本文主线就是它。
DeepSeek 指定大 V 风格,比如莫言的腔调,或者记者风,适合情感、生活这类对准确性要求不高的中文赛道。要提个醒,这条路有幻觉风险,严肃内容别碰。
Claude 3.7 加自定义风格,在提示词里描述你要的表达方式,比如简洁凝练。风格化最弱,但信息准确性最高,严肃领域用它。
老雷的建议是,先想清楚稿子发去哪个平台,再倒推用哪种写法。顺序反了,返工的是你自己。
顺带说下方法二的原理。DeepSeek 的训练数据里吃进了大量知名作者的作品,让它模仿莫言、模仿记者腔,是有据可依的,不是瞎撞。代价是风格越浓,离原文越远,编造细节的空间就越大,所以才说它只适合对准确性不敏感的赛道。
钱从哪来,坑在哪
Medium 的变现逻辑一句话讲完,付费会员的阅读时长分成。文章质量越高,读者停留越久,分到的钱越多。
所以这条路上值钱的动作就四个,选定赛道,立住人设,批量产出高质量内容,坚持发布攒阅读量。注意这个顺序,赛道和人设是地基,流水线是楼宇,地基没想清楚就开建,产出越多浪费越多。自动化解决的是产能,从一条链接到一篇能发布的英文稿,人力只剩终审那几分钟。但产能不等于收入,Medium 付钱买的是读者在你文章里停留的那几分钟。
工具把生产成本打到几毛钱,也把平庸的产量放大成千上万,稀缺的从来是有人的温度的那一篇。
还有一条红线必须写在明面上。改写后的文章查重极低,靠的是主观经历没有对错,但原文的核心信息、数据、事实都保留着。这套方法只能用在合理范围的内容创作上,原作者的知识产权要尊重,这是底线,不是建议。
这也是老雷AI实验室一直在做的事,把 AI 落地路上真正跑得通的路径,一条条拆开给你看。下一步动作很简单,挑一篇你自己写过的最好的文章,照四要素把人设档案写出来,跑一遍这条流水线。跑完之后,你对内容再生产这五个字,会有全新的体感。