老雷AI实验室
信息茧房越刷越厚,1745 个 RSS 源加 Claude Code 抢回主动权
28 个源,152 篇新文章,机器抓取 6 分钟,AI 通读后出一份本周复盘,我自己 5 分钟扫完。这就是我上周一早上的信息早餐,全程没有打开任何一个推荐流 App。
早餐的原材料不是什么内部渠道,是一份开源在 GitHub 上的 RSS 订阅清单,1745 个源、15 个分类。配上 Claude Code 或者 Codex 任意一个,就能搭出一条每天自动跑的私人信息流水线,零部署、零账号、零接口密钥。今天把这条流水线的账、玩法和坑一次拆完,你要做的只有一个判断,这条流水线对你的生意值不值。
算法喂给你的,是它猜你爱吃的
先把一个事说透,都 2026 年了,为什么还要捡回 RSS 这个二十多年前的东西。
你每天打开的那些 App,底层逻辑全是同一套。平台拿你的兴趣画像,算出你可能喜欢什么,再把你喜欢的塞过来。看着精准,代价是你看到的世界越来越窄,算法猜你爱看什么,你就只看得到什么。更麻烦的是主动权不在你手里,平台改一次规则,你收藏的账号说没就没。
RSS 是反着来的,按渠道分发,不按个人偏好。你订了哪 50 个博客,就看哪 50 个博客的更新,没有算法过滤,没有商业广告,没有平台插手。你主动选择信息源,不是被平台选中。
对老板来说这才是要害。你的信息食谱决定判断质量,判断质量决定钱往哪押。把押注建立在算法的猜测之上,这笔账怎么算都不划算。
RSS 还有个被低估的优点,它不只是一份阅读协议,它是一份结构化数据,标题、时间戳、永久链接、全文、作者,全部按统一格式输出。这让它天然适合机器读、AI 处理、自动化串联。
算法推荐是平台替你决定看什么,RSS 是你自己决定订阅谁。AI 生成的内容越爆炸,这个主动权越值钱。
1745 个源,从仓库到货架
用 RSS 的人卡在哪,老雷见得最多的是第一步,找不到值得订的源。打开阅读器,订阅列表空空,光标在搜索框里闪半天,不知道第一个该填什么。
GitHub 上其实不缺 RSS 清单,问题是这些清单互相孤立,中文一个仓库、英文一个仓库、科技一个、设计一个,没人聚合,死链率高,分类粗糙,更新全凭作者心情。
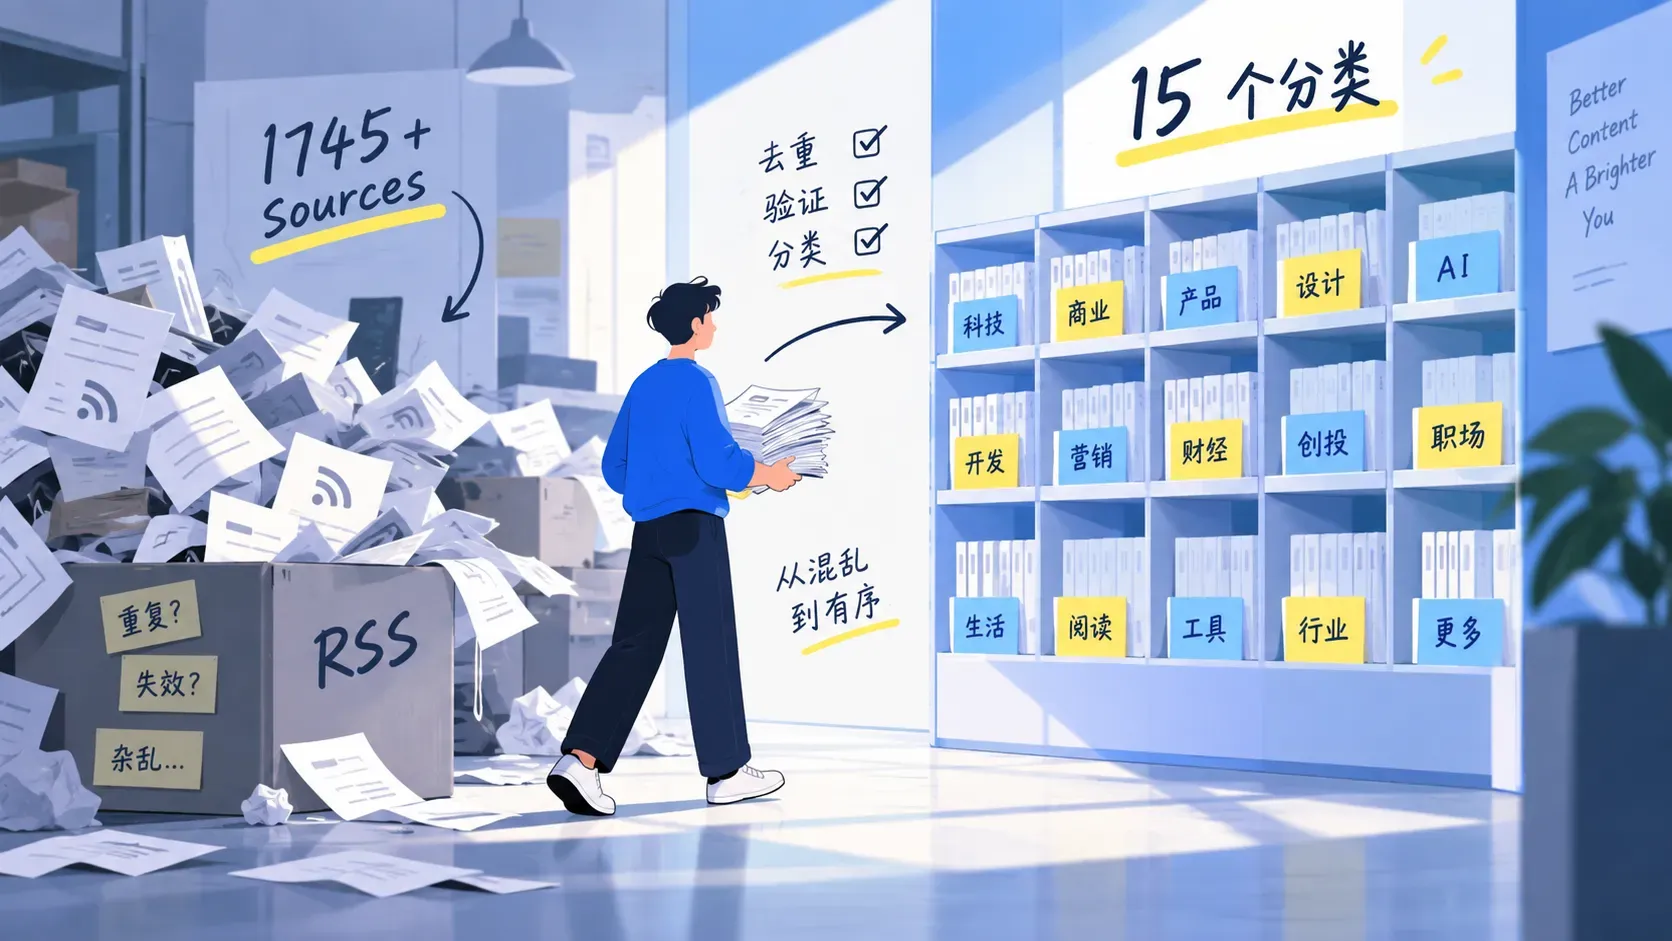
这份叫 awesome-rss-feeds 的开源项目做的是聚合的脏活,把全网 13 个开源 RSS 仓库系统采集到一起,去重、逐个做 HTTP 验证、再按读者场景重新分类,留下 1745 个订阅源、15 个一级分类。
分类逻辑值得单独讲一句,它按你要读什么分,不按源出自哪里分。做 AI 的对英文 AI 博客 50 个、中文 AI 博客 15 个。写代码的对 Web 前端 86 个、Web 标准 80 个。创业的对独立开发 85 个。想广撒网的,中文独立博客 358 个、开发者综合博客 845 个,连财经投资和个人随笔都各留了一类。标准只有一条,进来的人 30 秒内找到自己那一类。
别人的清单是「我把找到的源都列出来了」,这份仓库是「按你今天需要什么把源送到你手上」。前者是仓库,后者是货架。订下中文 AI 博客这一类,等于把「该读哪几个信源」这个决策外包给了筛选的人,导入就能用。
一条流水线,零接口密钥
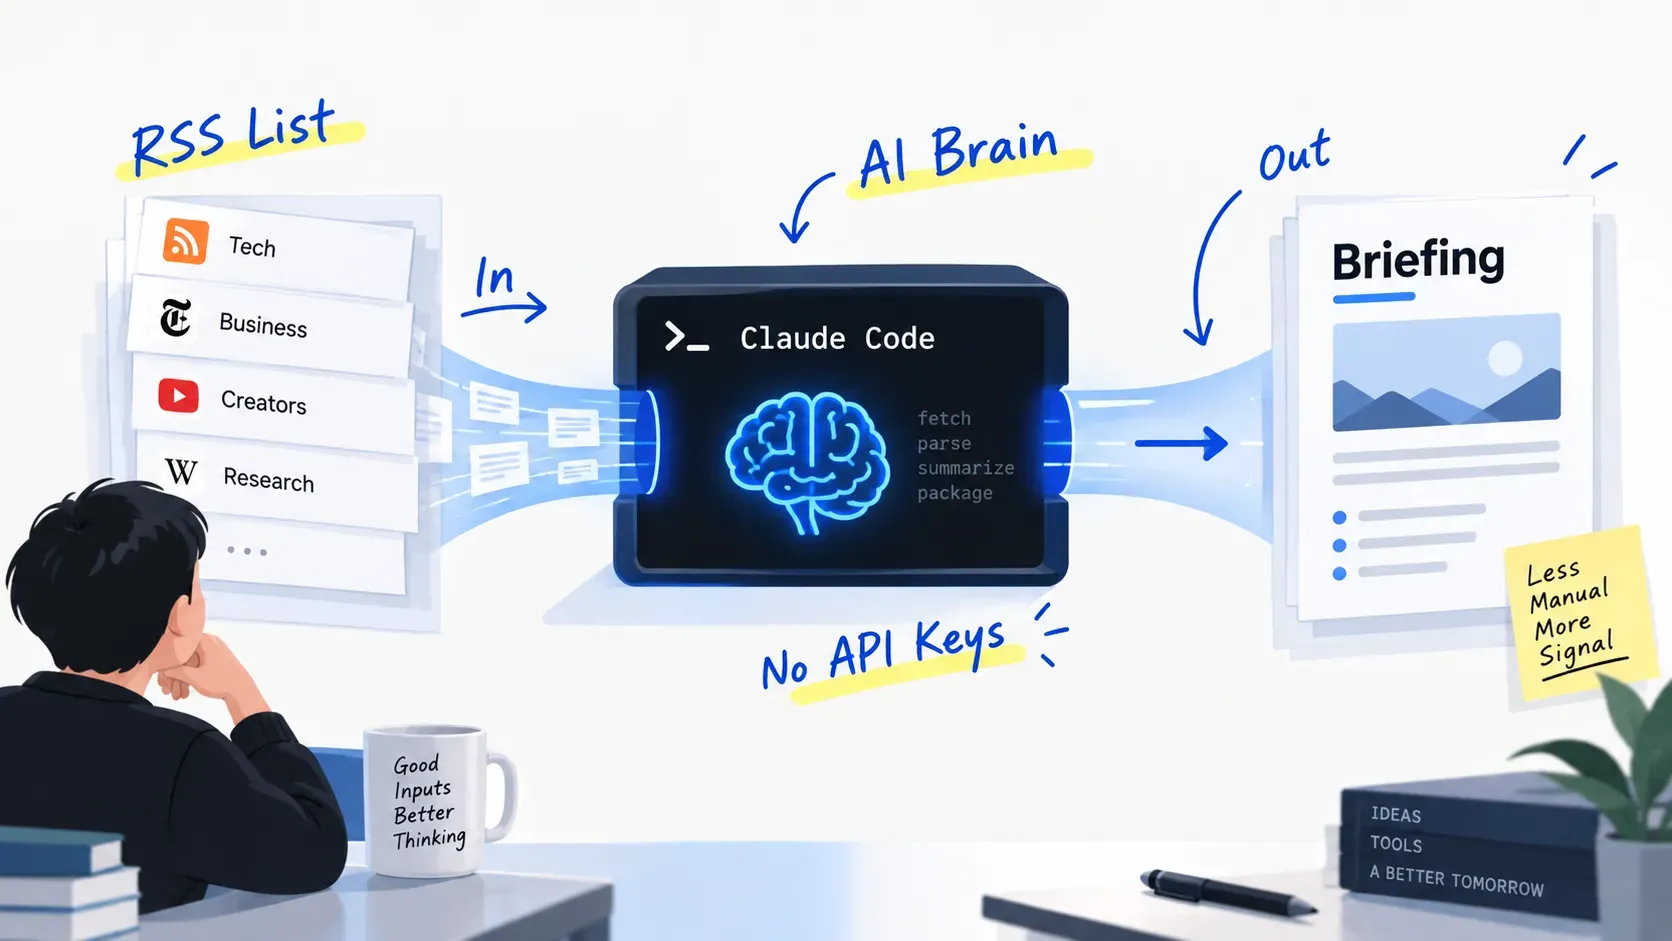
数据有了,缺一个大脑。这条流水线的分工很清楚,RSS 清单是数据,Claude Code 是大脑。
我自己实测跑过一遍。让 Claude Code 从中文 AI 博客分类抓最近 7 天,28 个源全部活跃,152 篇新文章入库,抓取 6 分钟。再把其中 120 篇打包成一个提示词包交给它自己读,5 分钟后一份本周 AI 圈复盘就端出来了,哪几篇文章在集中讨论同一个新概念、哪个模型发了什么版本、智能体安全出了什么新状况,一目了然。
那份复盘长什么样,举三个例子。五篇文章在集中讨论同一个话题,Claude Code 之所以好用,关键不在模型本身,而在围绕它搭的那套约束工程,配置文件、权限控制、错误反馈循环,这一层讨论直接指向 AI 编程从写提示词转向做工程的范式变化。然后是 DeepSeek 新版本带着百万字上下文登场,编程成本一次性降了八成多。还有智能体安全,大厂因为误删库暂停了客户接口,一整条产品线的事故成了全行业的前车之鉴。这三件事要靠人肉从 152 篇文章里捞,一个上午就没了。
顺带一个实测出来的分工经验,Claude Code 和 Codex 两兄弟脾气不一样。跨工具串联、读一批源再综合输出,Claude Code 更稳。写一段独立可跑的定时脚本,Codex 更顺手。我的用法是抓取打包交给谁都能干,竞品监控那种独立脚本交给 Codex 写,综合复盘留给 Claude Code。
这套东西被问最多的点是,要不要配模型接口密钥。不用。Claude Code 本身就是大模型,你付的订阅费里已经含着思考能力,中间不需要再调任何外部接口。
贴一段可以直接抄的提示词感受一下。
「下载这份 OPML 订阅清单,解析里面所有源,抓取最近 24 小时的文章,按论文、工具、产业、资讯分组,用中文写 500 字日报,存到本地笔记目录」
就这一段,丢给 Claude Code 就能跑。换一个分类文件,就换一份完全不同领域的简报。
五种玩法,从日报到私人知识库
每日简报只是最基础的一种,真实用下来是五种。
第一种,每日简报,对着自己行业的分类跑,做前端的对前端清单,做跨境的对科技媒体清单。
第二种,竞品监控。写个脚本注册定时任务,每天早 8 点抓竞品博客,命中产品发布、定价变化、融资、收购这几个关键词就推送到笔记。我以前是手动开 5 个竞品博客一个个刷,每周专门抽一块时间干这个,漏了还不知道。换成自动脚本之后,竞品有动作 30 分钟内能知道,一个月省下至少 2 小时。
第三种,写作选题库。让 Claude Code 从最近一周的文章里提取热点话题,按出现频次排序写进笔记,每个话题带相关文章数和代表标题。下周写东西直接挑,不用再对着空白文档想今天写啥。
第四种,英文源中文化。抓本周英文文章,AI 翻成中文摘要,专业术语保留英文原文避免歧义,归档成周报。英文圈好内容多,但逐篇细读太慢,这一招把阅读成本砍掉一大半。
第五种,私人知识库,进阶玩法。把订阅源的文章持续抓全文,喂进本地向量数据库,开源方案有 ChromaDB 和 pgvector。以后问「最近某个方向有什么新进展」,AI 从你筛过的源里检索回答。这个检索质量比公网搜索精准一个量级,搜索引擎给你的一半是优化出来的垃圾,而这里的每个源都是你自己认可的。
两个坑,一条 30 分钟的起步路径
按复杂度排,这套东西可以分成四档。入门档,Claude Code 加订阅清单,零部署,绝大多数人到这就够用。自动化档,加一个定时任务,Mac 用 launchd,Linux 用 cron,想可视化就上 n8n。进阶档,加自建阅读器 Miniflux 或 FreshRSS,图多端同步和已读未读管理。专业档,加本地向量库做知识问答。
老雷给大家提个醒,升级要克制。我见过不少人 RSS 玩着玩着就堆了一堆服务,服务器跑阅读器,容器跑爬虫,知识库越搭越大,时间全花在维护工具上,忘了 RSS 本来是为了读内容。每升一档前先问自己,这周的简报改变了哪个决策,答不上来就别升。
工具是手段,不是目的。信息流水线是替你省时间的,不是给你添一个新项目来养。
第二个坑是贪多。我刚开始用 RSS 的时候一口气订了 100 多个源,每天打开几百条未读,信息焦虑比刷推荐流还重,最后干脆不打开了。后来狠心精简到 50 个以内,每天未读稳定在 30 到 50 条,每条都值得点开,体验立刻回来。RSS 不是越多越好,是越准越好,宁可 30 个必读,不要 300 个摆设。别问老雷是怎么知道的,那是真金白银的注意力换来的。
想清楚了再动手,30 分钟足够从零跑通。注册一个 Inoreader 或者 Feedly 免费账号,5 分钟。挑你身份对应的清单文件导入阅读器,5 分钟。试读一周,删掉不会读的,留下 20 到 30 个真正会看的。装上 Claude Code,跑上面那段提示词,20 分钟。到此为止,你的私人信息流水线就算上线了。
工具的演化史,其实是一部分工史。第一代阅读器,人读、人记、人筛。第二代聚合器,机器抓、机器排、人筛。第三代简报系统,机器抓、机器写、人决策。到这一代,机器抓、AI 想、你看结论。每一代都在把人的注意力从体力活里解放出来,让你只留在最值钱的那一环,判断。
信息这个事也一样。这个时代最稀缺的不是信息,是主动权和判断力。1745 个源摆在那里,真正值钱的是你决定看什么、不看什么,以及看完之后敢下什么结论。
今晚花 5 分钟,挑出 10 个你真正会读的源,把流水线的第一颗螺丝拧上。剩下的,交给机器和 AI。