老雷AI实验室
让 Agent 半夜自己跑 Skill,OpenClaw 接 Claude Code 的桥怎么搭
先说一个很多人撞过的高频场景。一边是 Claude Code,手动用起来又快又稳,写稿、跑分析、出报告都顺手。另一边是 OpenClaw,十个 Agent 各管一摊,情报、研发、内容、运营,队伍齐整。
问题是这两边接不上。
OpenClaw 的 Agent 确实能调起 Claude Code,但调起之后呢,参数传对了吗,进程超时了谁来管,崩了 Agent 知道吗。能调用,不等于能可靠地调用。 我自己就在这一步栽过,让 Agent 直接去调 Claude Code,连着三天,每天早上打开一看,要么参数传错白跑一晚,要么超时了没人管,要么进程早死了,Agent 还以为任务在跑。那种以为在干活其实已经挂了的感觉,经历过一次就够。
后来我写了一个中间层,叫 Bridge,情况才反过来。现在这套系统每天自动执行 Skill 调用,从笔记到配图到 SEO 报告,全程没人守着。老雷现在给企业排自动化架构,头一个问的就是这句话,任务半夜挂了,谁知道。
这篇把 Bridge 的设计拆开讲,三层架构怎么分、两种模式怎么选、任务怎么防失踪、没人值守怎么跑,每一段都对应一个能搬回去用的结构决策。
在拆桥之前,有个前置问题绕不开。Agent 要干活,凭什么非得经过 Claude Code,直接调 API 不行吗。
行,但贵,而且不稳。Agent 每天要跑大量 Skill,写文章、做配图、跑 SEO 分析,每个动辄消耗几十万甚至上百万 token,走 API 按量计费,一个月下来是一笔很大的开支,而且 API 有速率限制,高峰期排队,Agent 在旁边干等。
Claude Code 搭配订阅套餐用订阅额度跑模型,不按 token 计费,响应快。打个比方,API 像出租车,按里程计费,跑得越多越贵。订阅像包月专车,每月固定价。自动化这种天天要出车的活,多数时候包月划算。实测下来,这也是现阶段让 Agent 高频自动化运行最稳的路子之一。
合规这事得单独说清楚。Anthropic 的消费者条款对 Agent SDK 搭配订阅的使用有过争议,官方文档一度写明不被允许,后来有 Anthropic 员工公开澄清,个人本地使用目前没有问题。政策随时可能调整,商用或者大规模部署,走 API Key 更稳妥。
桥分三层,每层只做一件事
Bridge 要解决的不是调用,是可靠调用。启动一个进程、传个参数,谁都会,难的是进程管理、异常兜底、超时处理这些脏活,它们需要一个专门的中间层来扛。它分三层。
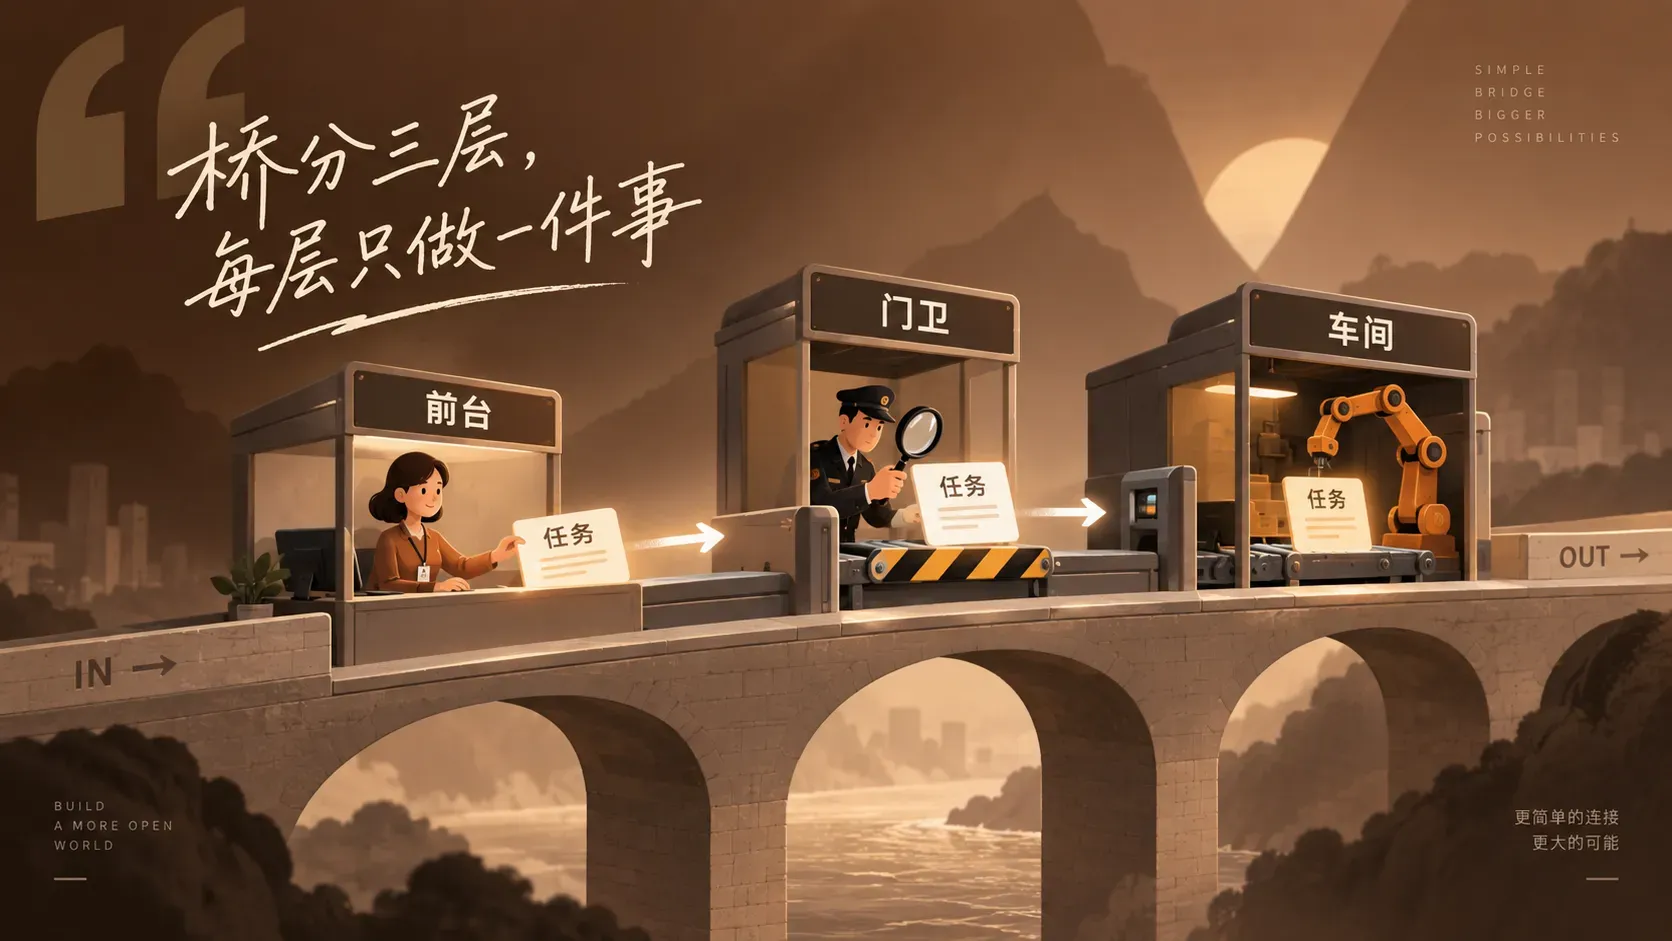
第一层调度室,一个叫 bridge-runner 的脚本,Agent 直接调的就是它。接单、登记、安排,创建运行目录,写入初始状态,决定这次用同步还是异步,任务挂了它负责善后。对 Agent 来说它就是唯一入口,后面的复杂度全被它挡住,派活的人不需要知道车间里有几道门。第二层门卫,bridge.sh,检查环境就没就绪,Python 虚拟环境在不在,依赖装没装,通过就放行,不通过就报错告诉你怎么修,绝不让一个环境残缺的任务溜进车间。第三层执行间,bridge.py,真正干活的地方,用 Claude Agent SDK 的 query 函数启动一个 Claude Code 进程,把 Skill 和参数丢进去,然后逐条处理返回的消息流,文本、工具调用、最终结果,一条不漏地消化掉。
为什么不做成一层,因为我试过。五百行的大脚本,凌晨崩了,日志里全是错误,分不清是 Python 的锅、Shell 的锅还是网络的锅,排查到天亮,发现是虚拟环境没激活。一个凌晨换一条原则,每层只做一件事,问题在哪一层,一眼就知道。
等快递和寄快递
Bridge 支持两种执行模式。
同步模式是等快递,Agent 发出指令后一直等到 Skill 跑完才继续,适合查个数据、发条消息这类短任务,缺点是等待期间 Agent 什么都干不了。异步模式是寄快递,指令发出去立刻返回,拿到一个状态文件路径当快递单号,Skill 在后台跑,完成后自动通知,适合写一篇文章、剪一个视频这类长任务。选法也简单,任务跑得完一分钟就同步,跑不完就异步,拿不准一律异步,等快递等到心态崩的教训谁都有过。
我这套系统里九成调用走异步。大多数 Skill 要跑三到三十分钟,让 Agent 傻等,不现实。异步的核心也不是快,是不阻塞,Agent 派出任务后接着处理别的事,干完再回来看结果。十个 Agent 能并行干活而不是排队等,靠的就是这个选择。
那怎么知道任务跑到哪了,看状态文件。每次执行都生成一份 state.json,记着当前状态、进程号、启动时间、最新心跳,Agent 随时来查,跟物流页面刷快递一个体验。更聪明的是,Bridge 会检测进程是不是真的活着,进程已经死了、状态还写着 running 的,它自动修正成 killed。连操作系统强制杀进程的场景都能抓到,这是被坑了无数次之后才加上的补丁。
三份保险,任务不许失踪
跑了两个月自动化,我总结了一条血泪教训,任务最可怕的不是失败,是失踪。
失败没关系,至少你知道哪里出了问题。失踪才是灾难,任务挂了,没有任何通知,Agent 以为还在跑,第二天早上才发现昨晚安排的活全部石沉大海,你连该从哪修起都不知道。所以 Bridge 上了三份保险。
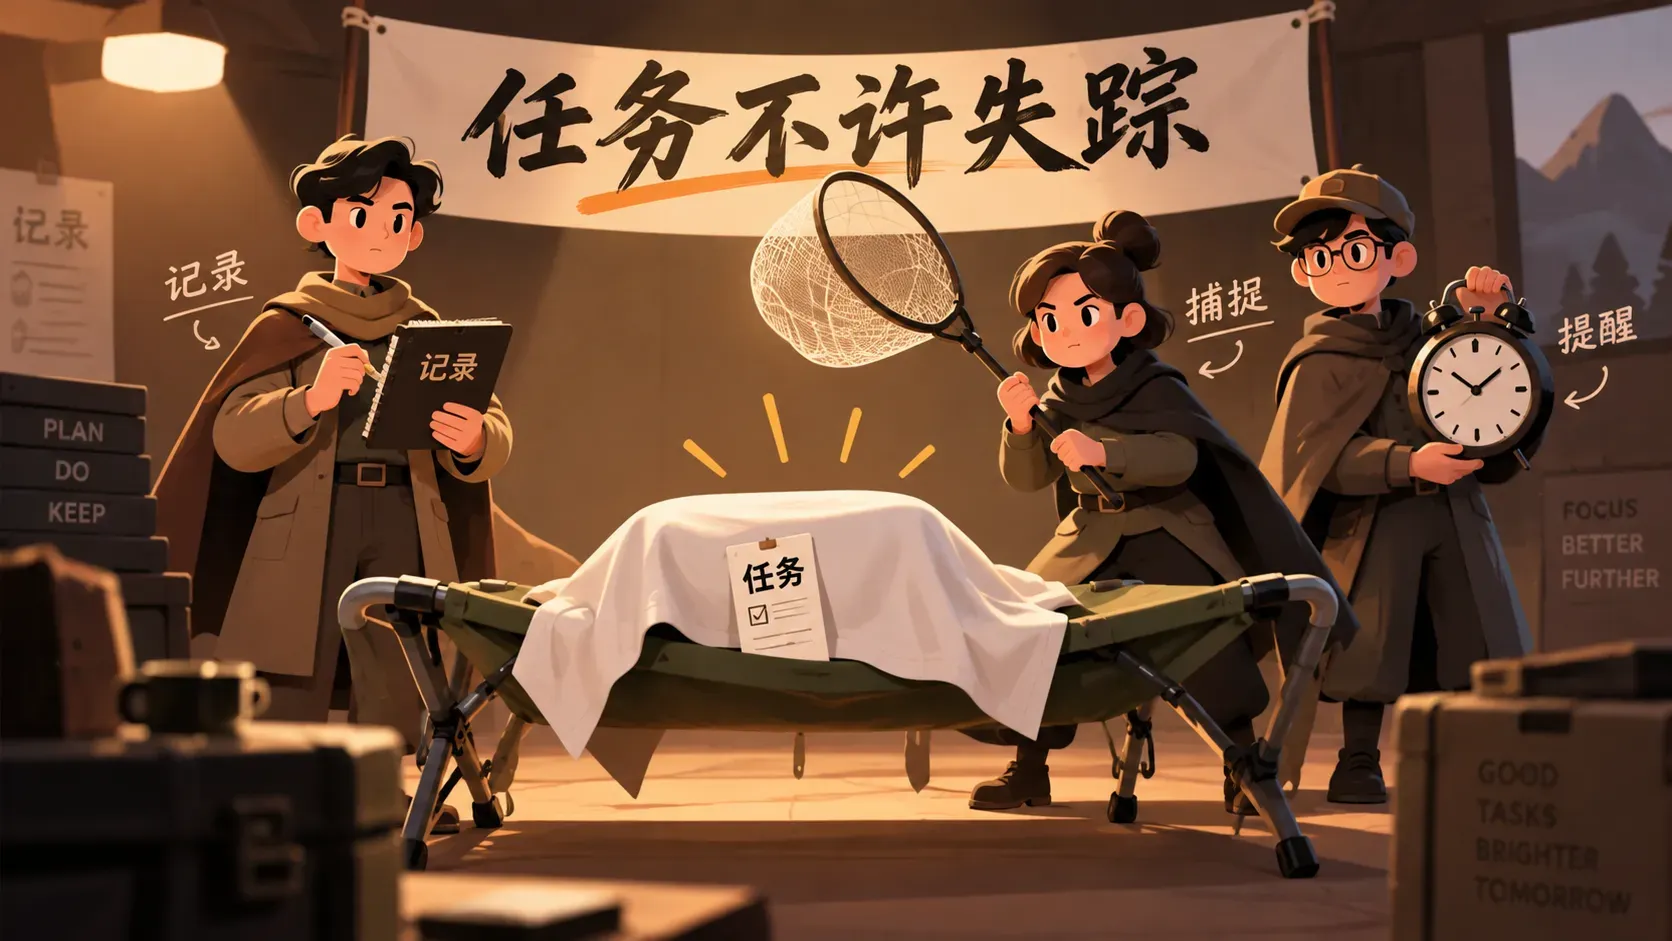
第一份自动善后,不管任务怎么结束,正常完成、中途崩溃、被系统杀掉,Bridge 都把发生了什么写进状态文件,不留悬案。第二份万能兜底,哪怕是最意外的崩溃,比如内存不够被系统直接踢掉,Bridge 也能捕获,做三件事,记录状态、写下错误原因、通知 Agent。第三份看门狗,每个任务设一个闹钟,超时没完成,多半是卡死了,看门狗直接终止它,把超时写进记录。三份保险对应三种死法,寿终正寝、意外身亡、久等不归,各有各的善后流程,谁也不会变成悬案。
不追求不出错,追求出了错一定被发现。
好的系统不是不会出错,是每次出错都会留下痕迹、触发修复。三份保险叠起来,就是这句话的工程化写法,任务永远不会无声消失。跑得越久你越会发现,这套记录本身还是笔资产,哪类任务常在哪种地方卡住,翻翻状态文件就有答案。
半夜没人点确认怎么办
Claude Code 干活时有个习惯,会停下来问人,目标语言是什么,文件路径在哪。你坐在电脑前,打个字就完了。可 Bridge 是凌晨三点在后台跑的,没人坐在电脑前。
Bridge 的做法是提前把所有答案打包。派任务的时候,Agent 把参数、配置、可能被问到的问题的答案一次性塞给桥,Claude Code 要什么自己去拿。有点像去政务大厅办事,材料备齐一次提交,真缺了什么,工作人员明确告诉你缺哪样,补完再来,而不是在窗口前干站着。技术上靠 PreToolUse 钩子拦截问询,发现参数不全就立即停下,报告缺了哪些字段,Agent 补完信息重新派单,绝不挂在等待输入上。
我最开始没做这一步,半夜跑的 Skill 经常卡在请输入那里,一等一整夜,第二天早上才发现什么都没跑成。自动化最大的敌人不是技术难度,是意外的人工干预。
干完了,自己来汇报
任务跑完了,怎么告诉 Agent。
Bridge 会把结果送到指定 Agent 手里,一条 openclaw agent --deliver 命令,还能动态解析目标在哪个频道,结果一出来,Agent 直接在对应频道里回话。通信协议也不神秘,桥在标准输出上打三种标记,状态、完成、出错,Agent 靠标记解析进度。状态写入用临时文件加原子改名,防止读到半截 JSON,这种小地方多防一手,半夜的故障就少一半。
于是闭环长这样。你说一句话,Agent 接到任务,Bridge 调 Claude Code 干活,干完了 Bridge 通知 Agent,Agent 在频道里回你。而你作为老板需要做什么,什么都不用做,早上端着咖啡打开频道,昨晚的笔记写了、配图做了、SEO 报告跑了,十个 Agent 各自汇报完毕,等你一句收到。
那一刻你会发现,这不是在用 AI,这是 AI 在替你上班。
这套东西不挑平台,Discord 也好、飞书也好,回调换个地址就通,核心结构原样能搬。
收尾说句实在的,搭 Agent 是一成的活,让 Agent 可靠地干活是剩下的九成。Bridge 不炫酷、不性感,全是进程、状态、超时这种不起眼的零件,但没有它,十个 Agent 就是一群坐在办公室里的空气。老雷的判断是,企业要把 AI 用进生产,最该补的就是这层可靠调用,预算别全砸在再买几个 Agent 上,给稳定性留一份,先把桥搭好,再谈扩编。
别再问 AI 能不能聊天,先让它今晚替你值一个班。