老雷AI实验室
从零造出能跑的 Skill,执行者分工和上下文预算的施工图
过去三个月,我用 Claude Code 攒了三十多个工作流 Skill,批量翻译、自动成稿、数据采集、代码审查,都交给了这些小流水线。外行看着像自动化车间,只有我自己知道中间翻过多少次车。
翻车姿势高度重复。一种是上下文爆满,任务跑到一半断头。一种是步骤之间数据传递靠猜,第二步找不到第一步的产出。还有一种是复杂流程一中断,全部从零再来,前面跑的十分钟全打水漂。
修得多了,这些坑被我压成一份施工图。这篇不讲是什么、为什么,只讲怎么搭,每一段都对应一个今天就能做的动作。先垫一句谦逊的话,这套东西不见得是唯一解,但每一条都是拿真实翻车换来的。
开工前,先认清四种执行者
写 Skill 最值钱的一次思考,是想清楚每一步的活交给谁干。
候选有四种。脚本,干输入输出都确定的活,调 API、读写文件、格式转换、分批合并,跑完只回一行 JSON 状态,上下文成本约等于零。SubAgent,干需要理解的活,评估质量、总结分析、生成内容。主 Agent,就是对话里那个 Claude Code 本人,干读配置、记进度这类轻协调。准备 SubAgent,专门在正式开工前处理海量数据,统计条数、算分批、建索引,干完立刻压缩,不留尾巴。
区别全在上下文成本上。脚本近乎免费,SubAgent 的执行历史会注回主对话,主 Agent 的每个动作都在主对话里累积。同样的活派给不同的执行者,成本能差出两个数量级,这就是为什么执行者的选择要放在写第一行文档之前。
给两个实测参照。采一百条数据,用 SubAgent 调 API,大约吃掉八千 token,花三十秒。换成脚本,只回一行状态,五十 token,五秒,省了九成九。一千条数据要分批,让主 Agent 全读进来是灾难,交给准备 SubAgent 先统计条数、算好每批多大、生成批次索引,实测能省九成五。
老雷把这四种的选择标准压成一个问句,这一步需要判断吗。不需要判断、只是搬数据和调接口,脚本。需要理解和判断,SubAgent,数据超过五百条就让准备 SubAgent 先分批。只是读个配置、推个进度,主 Agent 亲自来就行。
身份证和地图,都写在 SKILL.md
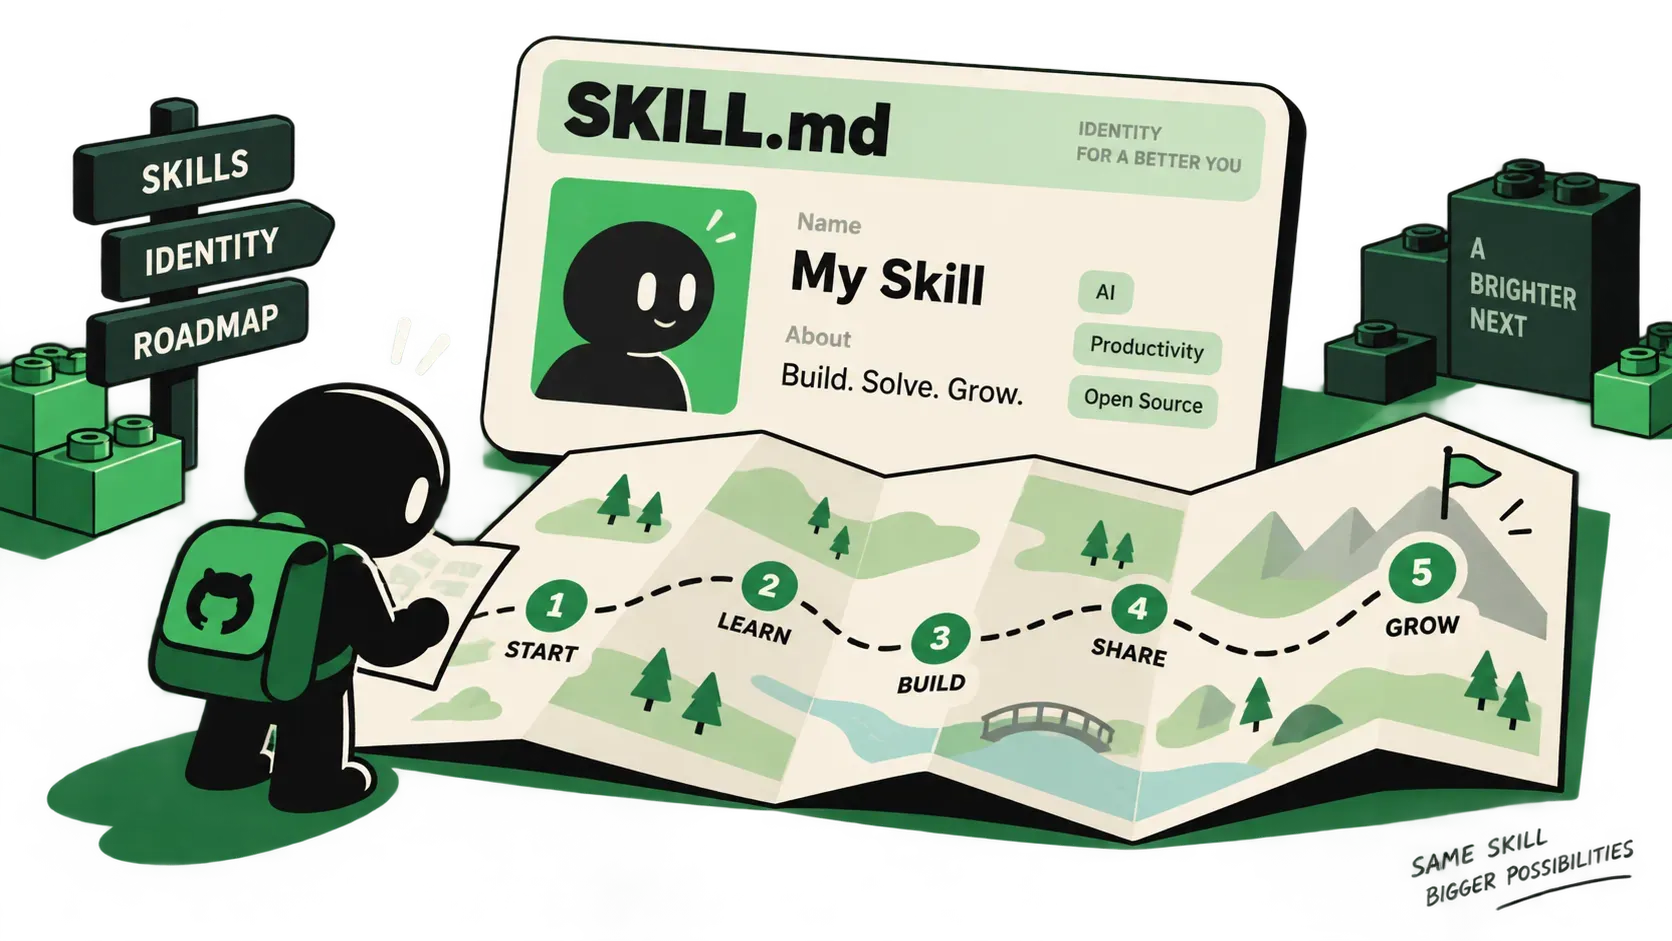
SKILL.md 开头那段 frontmatter,是 Skill 的身份证,两个字段都有硬规矩。
name 最长六十四个字符,只能用小写字母、数字和连字符,别碰 anthropic、claude 这类保留词,格式推荐「前缀-领域-对象-动作」的四级命名,动作用动名词,比如 collecting、building,一看就知道它在干什么。description 上限一千零二十四字符,必须第三人称,句式就是核心功能加触发条件,照着「批量采集指定话题的文章数据。当用户说采集文章、抓取话题时触发」这个样子写,别写我可以帮你。
身份证后面是地图,也就是工作流定义。每一步写五样,Step 编号、两到六个字的动宾职责、执行者、对应文档、输入输出。这张地图还是省上下文的关键,Claude Code 不会一上来读完全部步骤文档,它看着地图走到哪一步,才翻开那一步的说明。这套渐进加载的思路,跟星巴克店员不需要背下全部配方、照着岗位流程卡干活是一个道理,脑子留给判断,流程交给卡片。
目录按需长,规范给的是菜单不是套餐。四个步骤以上,或者单步文档超过五十行,再建 workflow。要调 API、处理数据,再建 scripts。要用凭证,再建 credentials。一个 SKILL.md 能跑的活,就别铺七个空文件夹装样子。
另外别忘了初始化这一步的用户输入,用 Claude Code 自带的问询工具收,规矩是单次最多四个问题,每个问题两到四个选项,标题不超过十二个字符,系统会自动补一个自由输入的兜底选项。要问的参数一次问齐,别挤牙膏似的问一轮再来一轮,用户体验和上下文都耗不起。
每一步,签一份接口合同
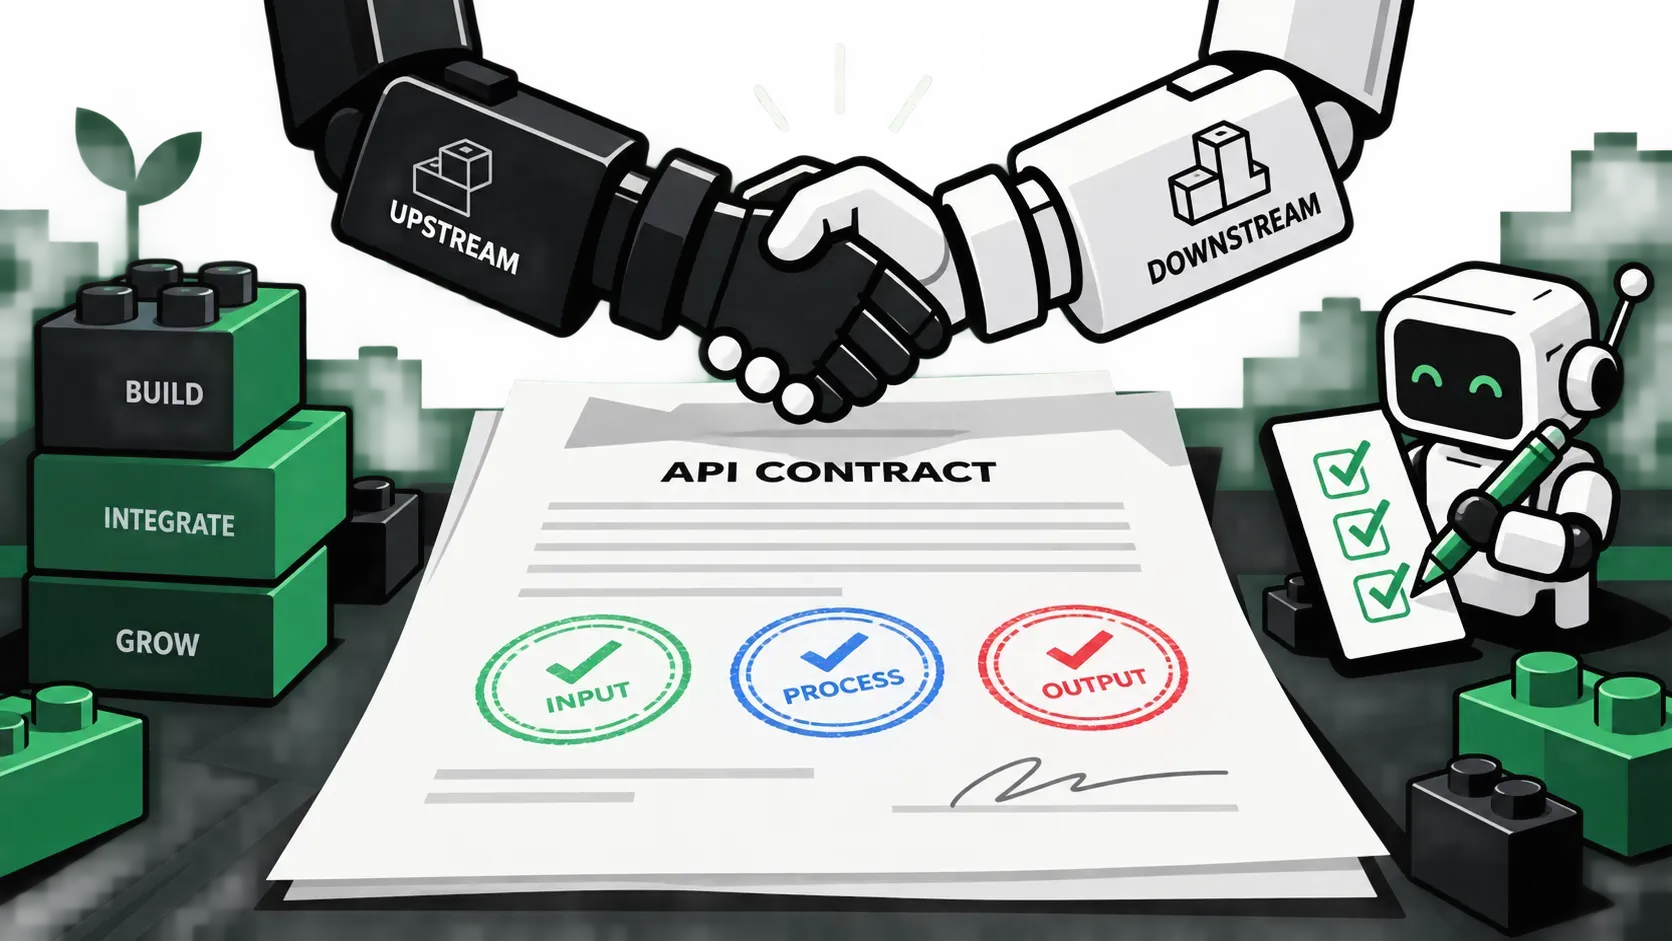
workflow 里的每个步骤文档,就是这一步跟上下游签的合同,五样东西缺一不可。
执行说明,用自然语言讲清这一步干什么。输入文件,写明来源,比如配置来自第一步的输出。输出文件,写明格式和内容,比如采集结果是一个 JSON 数组。执行命令,脚本怎么跑、参数怎么传,写死在文档里。验证检查点,编号按步骤加字母排,2a、2b、2c,每条都是一个能自动判断的条件,文件存在且非空、JSON 可解析、数据量大于零。
有人嫌检查点繁琐。反了,检查点是安全网,Skill 出问题时,你能精确到某一小步定位故障,没有它,排错就是大海捞针。检查点还有个隐藏用处,中断恢复之后,Agent 靠检查点判断哪些步骤的结果还能用,哪些要重跑,不用靠记忆猜。
脚本这边有四条纪律。返回值必须是 JSON,带 ok 字段报成败。错误信息放 err 字段,截断到一百字符,别把整段堆栈倒出来。路径用 --run-dir 参数传,不许硬编码。输出只给状态,日志和调试信息一概不带。调用脚本前记得先进到脚本目录再执行,依赖配置才认得路。
上下文是预算,不是空气
两百 k 的窗口听着很大,架不住几步就吃满。
系统提示词占五 k,SKILL.md 占两到五 k,每份步骤文档一到三 k,读一次文件最多二十五 k。最凶的是 SubAgent,每个跑完要把执行历史注回主对话,一个约十 k。老雷见过最冤的浪费,就是六个 SubAgent 并行开跑,一口气注回六十 k,任务还没干一半,窗口先见了底。
所以有两条铁律。每轮最多两个 SubAgent,跑完立刻压缩上下文,窗口用到七成,强制压缩。 为什么是二,可用空间留足保险后约五十 k,单 Agent 返回约十 k,理论安全并行是五,保守砍到二,给意外留余量。
配套的还有极简返回,SubAgent 收工只许回一行状态,ok 加批次号加条数,这个量级就够,内容一律写文件,不许夹带在回话里。平台硬限也记三个,单次读文件上限二十五 k 超了截断,终端输出三万字符封顶,MCP 返回同样二十五 k 上限,写步骤文档时就把大输出拆开,别撞墙。
存档点加安全网,断了也能接
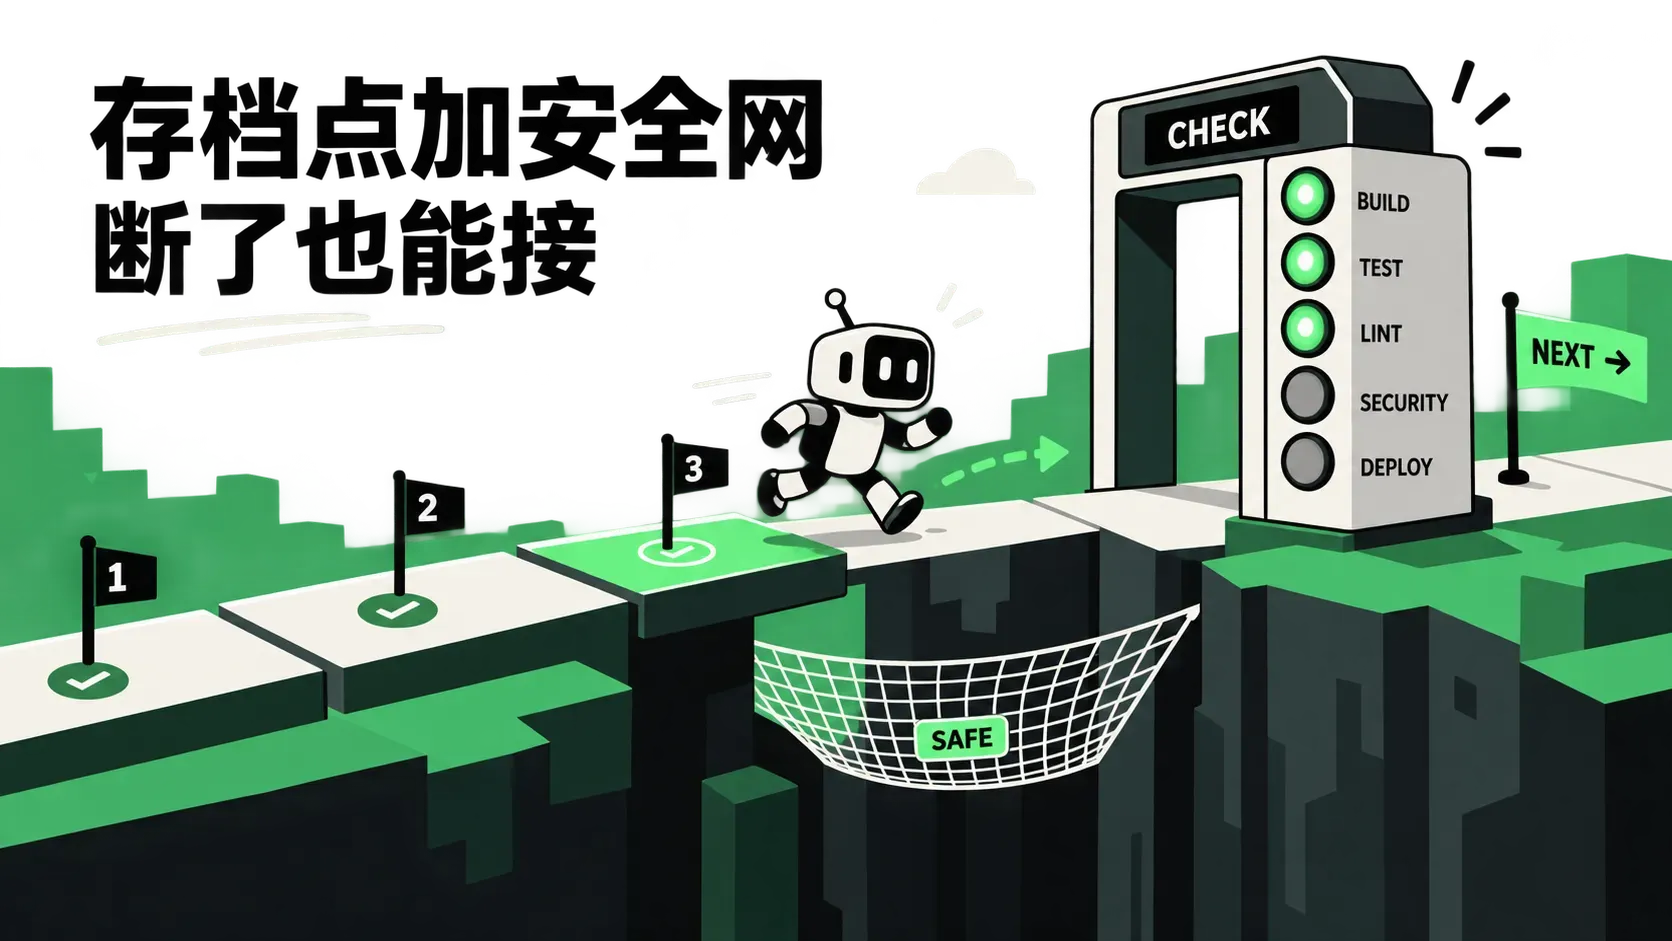
每次运行都开独立目录,名字用关键词加时间戳,比如 claude-code-20260130-103000。里面 state 和 output 是固定户,中间步骤的产出按步骤号建目录,谁的孩子谁抱走。独立目录还有个好处,同一个 Skill 连跑十次互不覆盖,出了问题对着旧运行目录一比,差异在哪一眼就看出来。
state 里的 progress.json 是存档点,记着运行标识、当前步骤、完成了哪些批次,还要专门写一段恢复提示,告诉接手的 Agent 从哪继续。断了之后的接法固定四步,读进度文件,看恢复提示,确认执行者是谁,从断点接着跑,跟游戏读档一个手感。
安全网是五层验证,一层比一层严。文件存在且非空,格式可解析,字段完整,值在合理范围,业务规则满足。前三层不过就重试,值范围异常就标记,业务规则不满足才判失败。错误也要分四类对待,网络超时和限流是临时错误,指数退避重试。参数错、格式错是永久错误,重试没有意义,终止报告。401、403 这类凭证问题是权限错误,停下来检查密钥。上下文溢出、磁盘满属于资源错误,先清理再重试。
顺带答一个长大之后的问题,一个 Skill 要支持好几种玩法怎么办。把 workflow 按模式分目录,每种模式一套步骤文档,触发词也分开,说克隆走采集模式,说时间线走分析模式,运行目录带上模式前缀,互不串线。至于是加模式还是拆成两个 Skill,判断标准看输出,输出格式一样、逻辑大量共享就加模式,输出长得不一样就果断拆。
规范之于 Skill,就像建筑规范之于房子。没有规范也能住人,有了规范才能通过验收、交给别人、住上几十年。
收尾还是那句谦逊话,这份施工图未必最优,但它把摸索半天压成了照图施工。中间每个环节,执行者、检查点、预算、存档,单独看都是小动作,连起来就是你交付质量的下限。老雷的建议是从今天挑一件你重复最多的活开始,先一个 SKILL.md 跑起来,目录按需慢慢长,别挑复杂的,越简单越容易跑通第一次。等团队里每个人都能看懂、能改、能接手你写的 Skill,这份规范才算真正长在了你的交付流程上。