 老雷AI实验室
AI 写产品文案张嘴就编?把商品参数喂成知识库就老实了
事情是这样的。朋友的公司做跨境电商,上个月约我吃饭,聊的不是生意,是文案。
他们每上一个新品,亚马逊 Listing 五点描述、产品详情页、种草文、买家问答,一个 SKU 至少四五篇内容。几十个 SKU 排着队,运营组天天加班还是写不完。外包写回来的稿子参数全是编的,改稿的时间比自己写还长。
比量更麻烦的,是真话的约束。产品文案必须踩着真实参数写,续航 20 小时就是 20 小时,Type-C 接口就是 Type-C,AI 自己发挥一版,上架之后等来的就是差评和退货率。
所以他问我的问题很直接,这东西能不能又快,又不编。
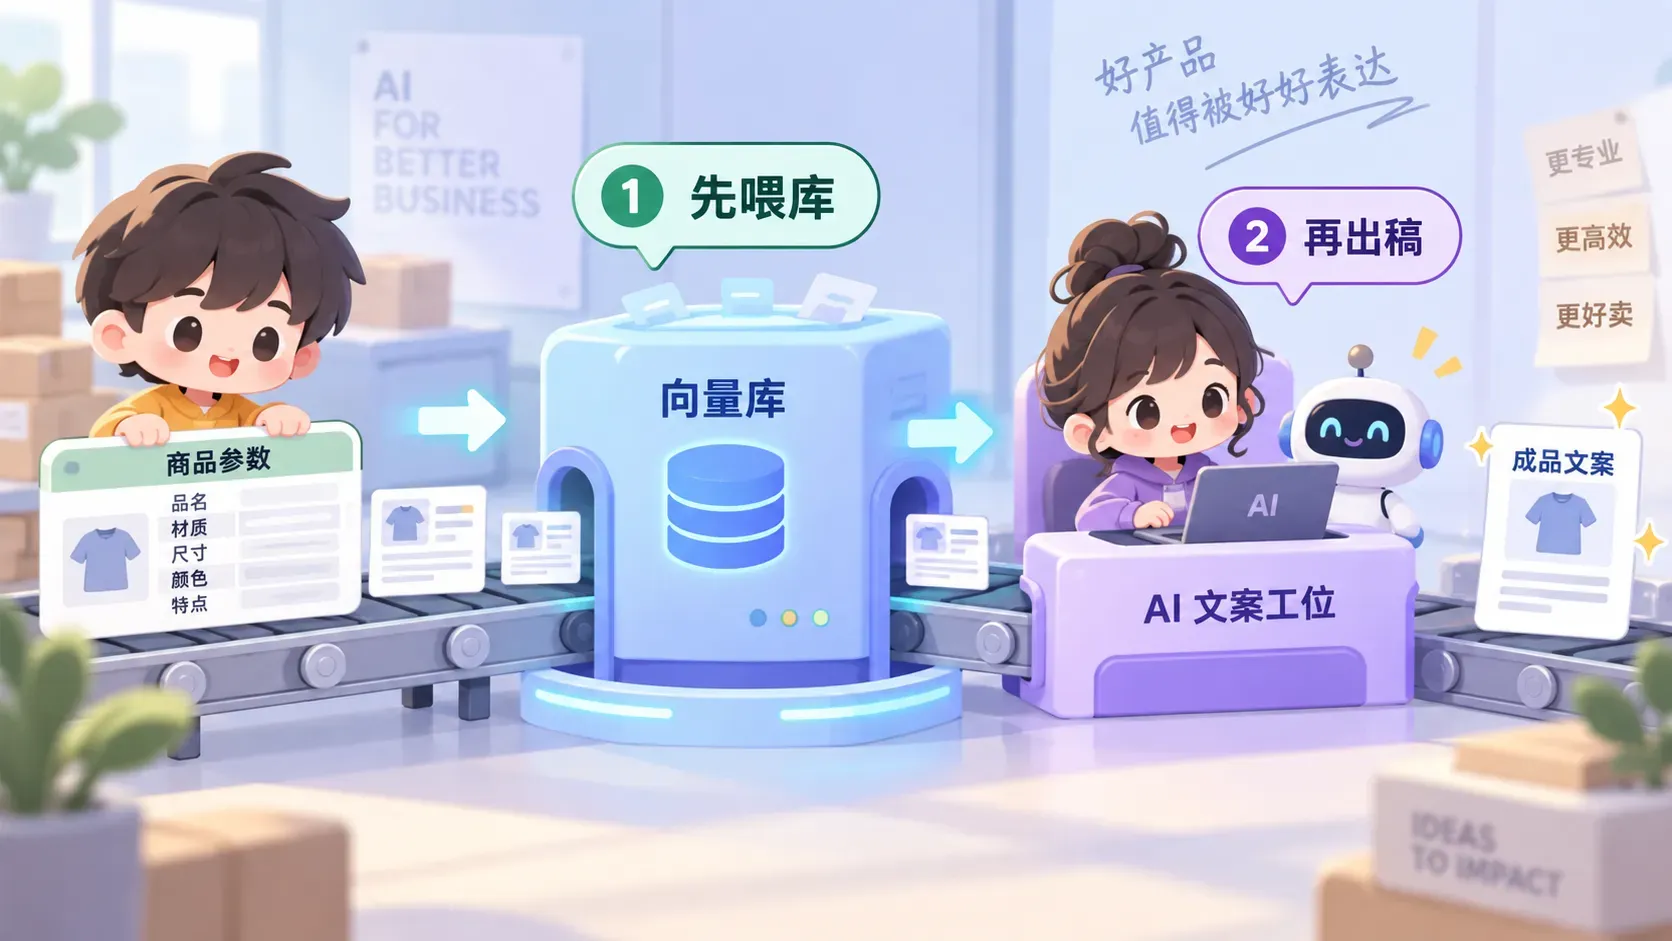
能,而且这套东西他们已经跑了大半年。答案四个字,先喂再写。把商品参数做成一个 AI 写稿前能查的知识库,查到什么写什么,查不到就承认不知道。老雷把这条流水线拆开讲,架构怎么搭,钱怎么算,别的行业能不能抄。
AI 写内容靠不靠谱,从来不是看模型有多聪明,是看它动笔之前能不能查到真东西。
关键词搜不到,知识库先垮
很多老板一听知识库就说,不就是把文档存进 Notion,要用的时候搜一下吗。
问题恰恰出在搜这个字上。
传统关键词检索有个致命的死板。你搜「无线键盘」,库里写的是「蓝牙机械键盘」,一个字都对不上,直接搜空。你搜「RAG」,库里写的是「检索增强生成」,照样搜空。词是死的,用户嘴是活的,靠精确匹配做检索,知识库越大越没人用。
RAG(检索增强生成)干的事,就是把匹配从字面挪到语义。打个比方,人民币和美元没法直接交易,换成统一的度量衡就能自由兑换。RAG 把文档和问题都转成向量这种统一语言,再算相似度,意思近的东西不管用词差多远都能对上。
除了搜得到,还有一笔账经常被忽略。关键词检索命中之后,是把整条知识原封不动塞给大模型,上下文又长又贵,模型还容易被无关信息带偏。向量检索返回的是最相关的几个片段,喂给模型的每一段都有用,成本和质量一起改善。
这两笔账算下来,老板关心的答案就有了。检索准,编造少。喂得省,账单低。
两段流水线,先喂库再出稿
整套系统分两段,中间靠一张商品表连着。
第一段是喂库。商品信息放在 SmartSuite 这类在线表格里,名称、型号、价格、特点、卖点,一行一个商品。工作流一旦检测到状态变化,自动把这条商品信息用 Jina Embeddings v3 转成向量,写进 Pinecone 向量数据库。全程零代码,改个状态就跑,不用回到自动化平台手动点试运行。
表格这层看着平淡,字段设计却直接决定后面嵌入的质量。除了名称和状态,把型号、版本、价格、商品链接、特点简介都拆成独立字段,喂给模型的信息就越干净。字段糊成一坨,后面的检索就全是在泥里捞东西。表格工具的选型顺带说一句,SmartSuite 免费额度就支持 Webhook 实时触发,Airtable 体验和生态更好但要每月 20 美元,还得靠它内置的自动化去触发外部 Webhook,预算紧就选前者,不亏。
第二段是出稿。运营在表格里写下创作需求,比如给某个型号写一条 Listing,工作流自动去知识库里检索跟这个商品相关的片段,重排排序后交给大模型,产出内容回填表格。同一个入口,写 Listing、写种草文、答买家问题,三条路随状态字段自动切换。
听着不复杂,但有两个细节决定这套系统是玩具还是生产工具,老雷提醒一句。
第一个细节是更新校验。商品价格改了、规格升级了,知识库里的旧向量要是不跟着更新,AI 会拿着过期参数一本正经地写错话。做法是给每条向量存一个内容指纹(Hash),每次跑嵌入前先查一下,内容没变就跳过,变了就重新嵌入覆盖。自动化系统最怕的不是不出活,是出过期的活,这道校验必须有。
第二个细节是命名绑定。把商品名称拼接到每个参数片段的前面,这样哪怕检索只命中「支持 USB-C 快充」这一小段,大模型也知道它属于哪个商品,不会把 A 产品的卖点安到 B 产品头上。一个小动作,串货率直线下降。
还有一个容易被跳过的环节值得抄。写稿前先让大模型把创作需求翻译成检索关键词,一个复杂需求拆成多个检索问题,分头去查再汇总。检索这一步做细了,后面生成的内容才有「什么都知道」的底气。
流程末端再加一道保险,每个分支跑完都校验一次上游请求是否成功,失败了就停在原地报警,而不是把半成品内容回填进表格。自动化的纪律和人一样,出错不可怕,可怕的是错了还装没事。
参数会过期,命名会串台,自动化流水线的可靠性全押在这类不起眼的小设计上。
三种文案,三套规矩
同一个知识库,产三种内容,提示词策略完全不同。
亚马逊 Listing 这条路,规矩最严。角色设定成电商优化大师,输出标准的五要素,标题、五点描述、后台搜索词、图片说明、长描述。最重要的一条约束,是所有内容严格基于检索到的商品信息,禁止虚构。规矩写进系统提示词,模型越界就重来。
种草文这条路,玩法反过来。第一人称体验文,什么值得买那种风格。全是夸反而显得假,有理有据地写一两个无伤大雅的小缺点,转化率反而更高。这是我们实测下来最反直觉的一条,缺陷本身就是可信度。
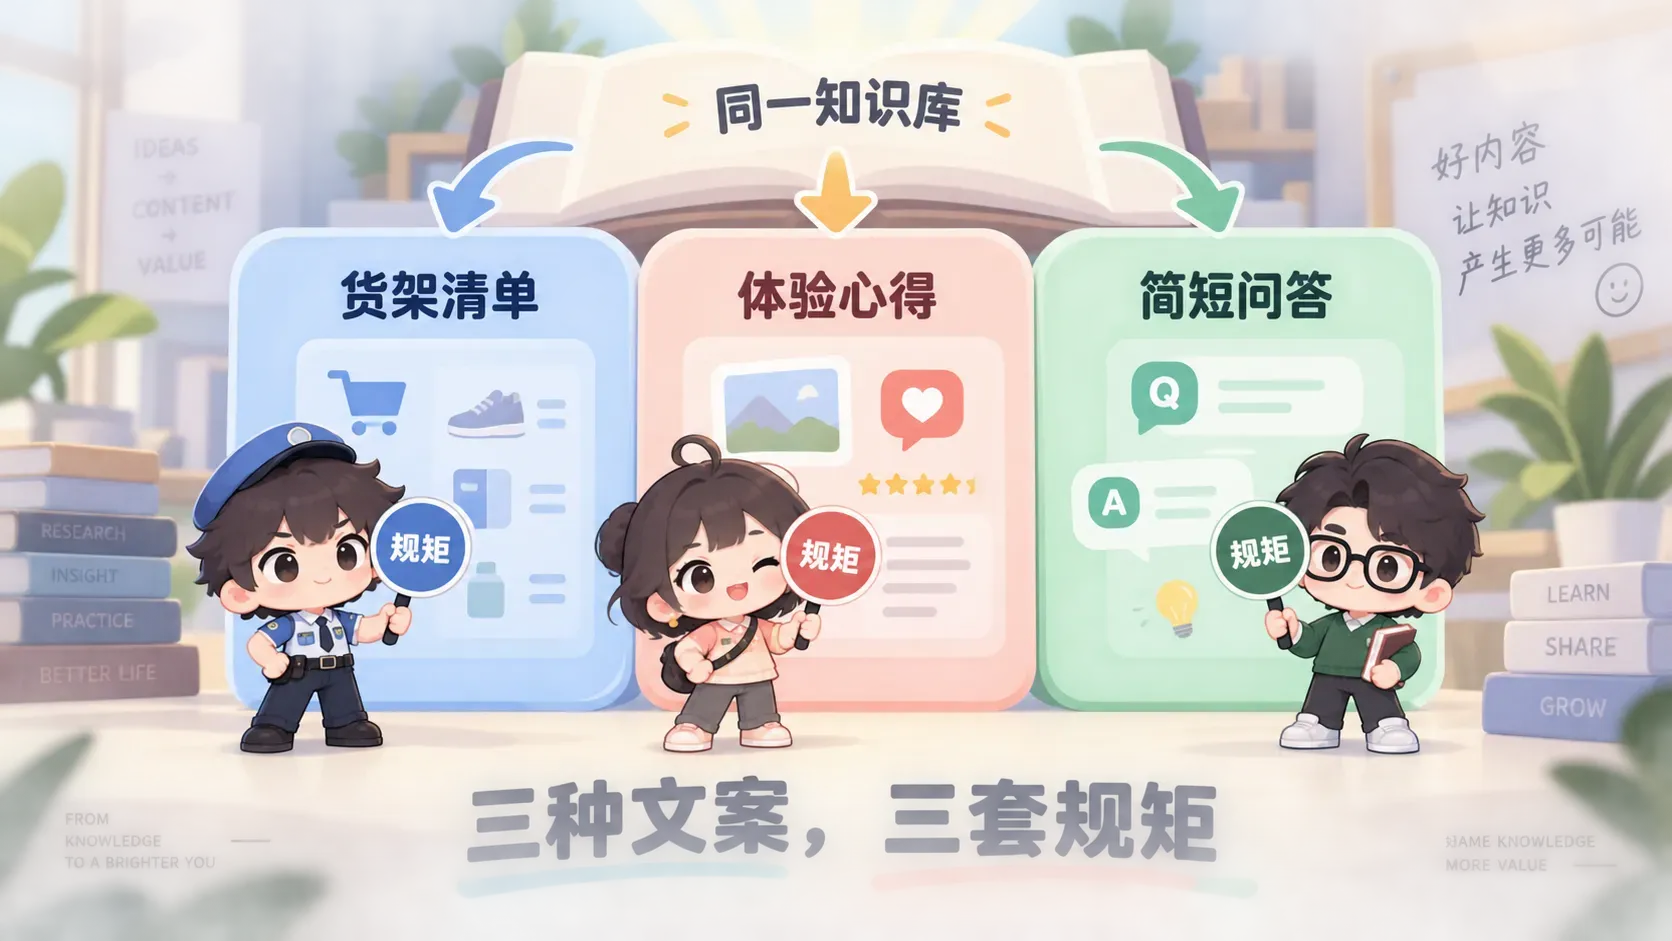
买家问答这条路,纪律最硬。两百字以内,知道就答,不知道就明说不知道,所有引用标注来源。客服场景里,一句「这个参数我不确定,建议咨询店铺」,远比一段编出来的漂亮话值钱。
三种策略摆在一起,你会发现一个规律,给 AI 的自由度越低,产出的内容越能直接上架。这不是限制,是护栏。
别的行业,能不能抄
先回答最常被问的问题,这套东西只有跨境电商能用吗。
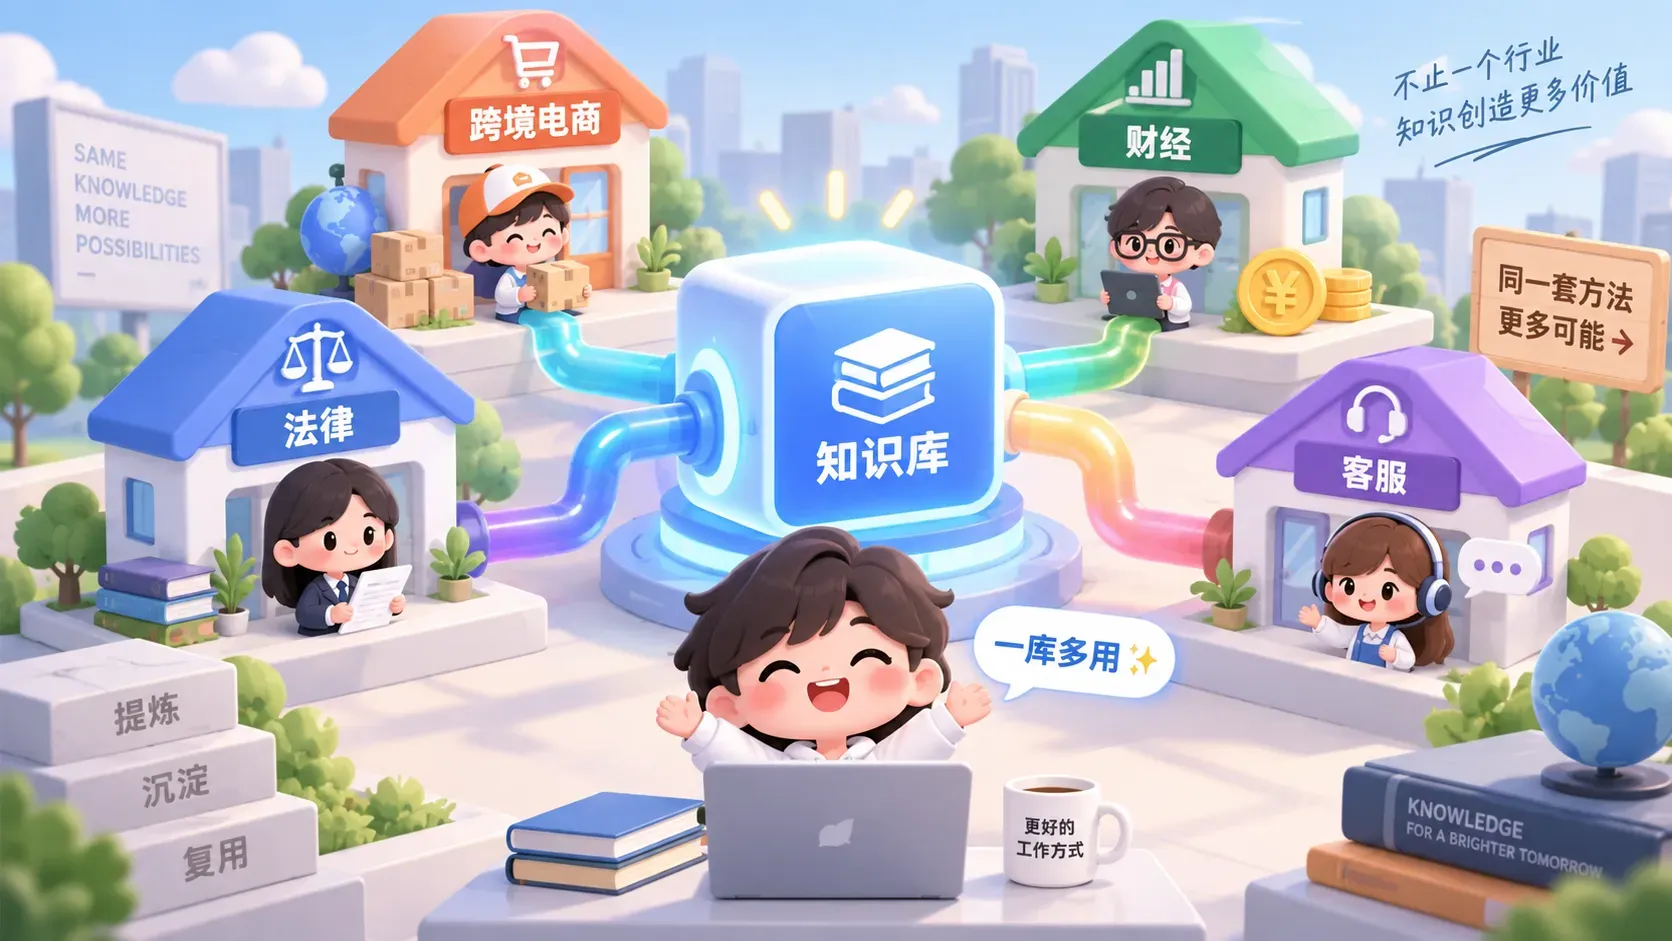
不是。它的内核是「基于私有知识生成内容」,商品表只是个载体。把商品表换成法律条文库,就是合规文书的初稿机。换成财经数据库,就是研报摘要助手。换成产品文档库,就是技术支持的自动应答。垂直领域的专业知识库,精准度远超通用大模型直接裸写。
成本账也透明。SmartSuite 有免费额度,追求体验和生态可以换 Airtable,大约每月 20 美元。Pinecone 免费版对几百到几千条商品数据完全够用,SKU 上到万级再谈付费。Jina 的嵌入和重排按量计费,用量小到可以忽略。真正要预算的是大模型生成那一环,通过 OpenRouter 接入,哪个模型性价比高就用哪个,成本自己可控。
打算立项的老板,上线前先给自己三个判断题。第一题,换一种说法能不能检索到同一条知识,客户说口语、说外号、说错别字,系统还能不能对上,答不上来说明检索层没过关。第二题,商品信息改了之后,知识库隔多久同步,如果答案是隔天,那就等着 AI 拿旧价格跟你客户签单。第三题,系统有没有说「不知道」的机制,一个不会承认无知的客服系统,上线等于开盲盒。三道题都过了,再谈规模化。
给 FDE 的提示压缩成三条。用 Jina Embeddings v3 时,文档嵌入和查询嵌入的任务类型要分开设置,一个是 retrieval.passage,一个是 retrieval.query,混用效果差一截。向量维度统一 1024,Pinecone 建库时必须对齐,算法选 Cosine。长文档别整篇塞,表格按行切,PDF 按标题层级切,长文先生成摘要,再把摘要附到每个片段里,检索命中率明显提升。
最后说说平台选型,这块误会最多。Make 是自动化工具,两千多个应用集成,解决的是流程效率。Coze 和 Dify 是 Agent 平台,解决的是对话和代理。两者不是竞争对手,完全可以把 Coze 和 Dify 当成 Make 的第 2001 和第 2002 个应用模块,流程编排交给 Make,需要 Agent 能力的环节单独调用。
回到朋友那顿饭。他最后问了一句话,你们搞这么复杂,为什么不直接让 ChatGPT 写。
答案很朴素。通用大模型知道的,是全世界的平均知识,它不知道你仓库里那批货的真实参数。企业落地里最值钱的动作,从来不是找一个更聪明的模型,是把你手里那点别人没有的真东西,变成 AI 随时能查的资产。
产品参数如此,公司积累的行业经验,也如此。