老雷AI实验室
爆款不是玄学,是一套能拆出来的指令
先给你看一个标题,「从水中飞鱼到千寻军子,一个冠军的成长之路」。
我看到的时候愣了几秒。这种爆款味很冲的标题不是人写的,是一条 Make 工作流自动生成的。同一条产线出的正文,代入感、修辞、结构编排,都明显强过随手丢给 ChatGPT 的那句「帮我写一篇爆款文章」。
差距出在哪。不在模型,在指令。你那句需求等于让一个新员工凭感觉发挥,而这条产线背后,是一套从真实爆款文章里逆向拆出来的写作指令,十几项约束一起起作用。
老雷把这套东西叫提示词工厂,逻辑一句话讲完,用爆款训练爆款。把真正跑出来的爆款喂给模型分析,提炼写作规律,再用规律驱动新内容。听着简单,整条产线三十三个模块,是这几年我们搭过的最复杂的一条 Make 工作流。好在它分三段,每段都能拆出来单独用。
产线分三段,Notion 是传送带
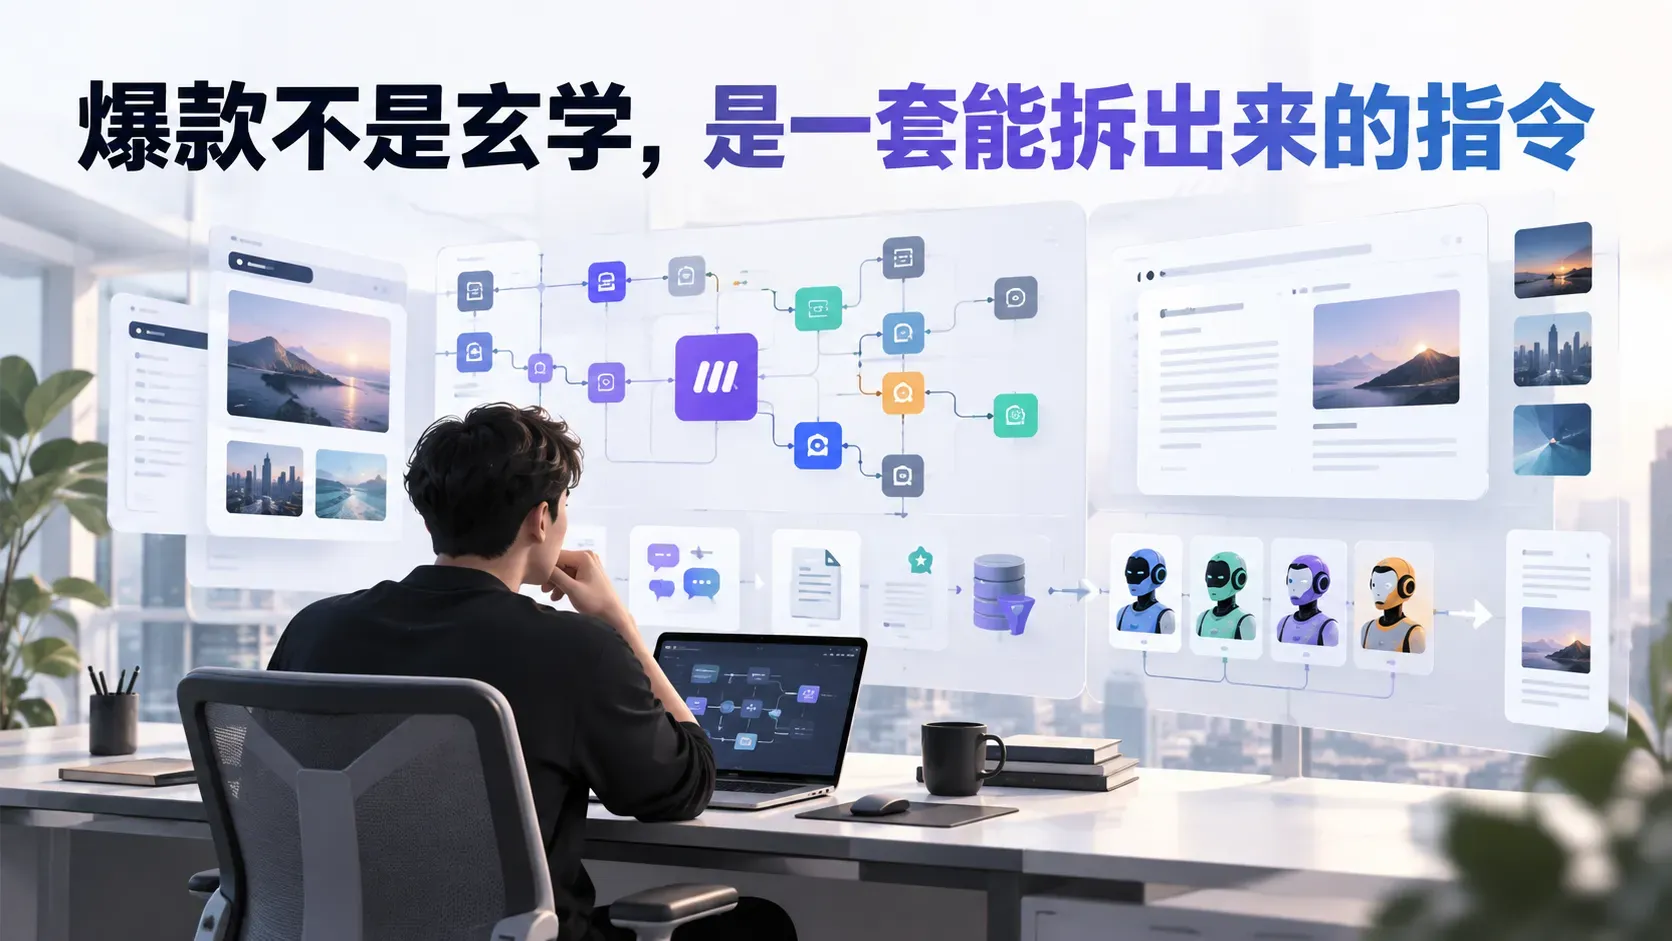
三十三个模块按功能切三块。上半段约十五个模块,把爆款文章变成写作指令;中间约八个,抓社会热点;下面约十个,拿着指令和热点出最终文章。
三段不直接连线,靠三个 Notion 数据库接力。爆款文章分析库存原文,提示词库存生成好的写作指令,写作库存热点和成品文章。上一段往库里写,下一段从库里读,状态字段就是传送带的开关。
这个结构对交付团队有个隐藏好处。三段解耦,你可以只上第一段。提示词生成是整条线里价值最密的部分,热点和成文模块后面再接,风险小一大截。
爆款是怎么被拆成指令的
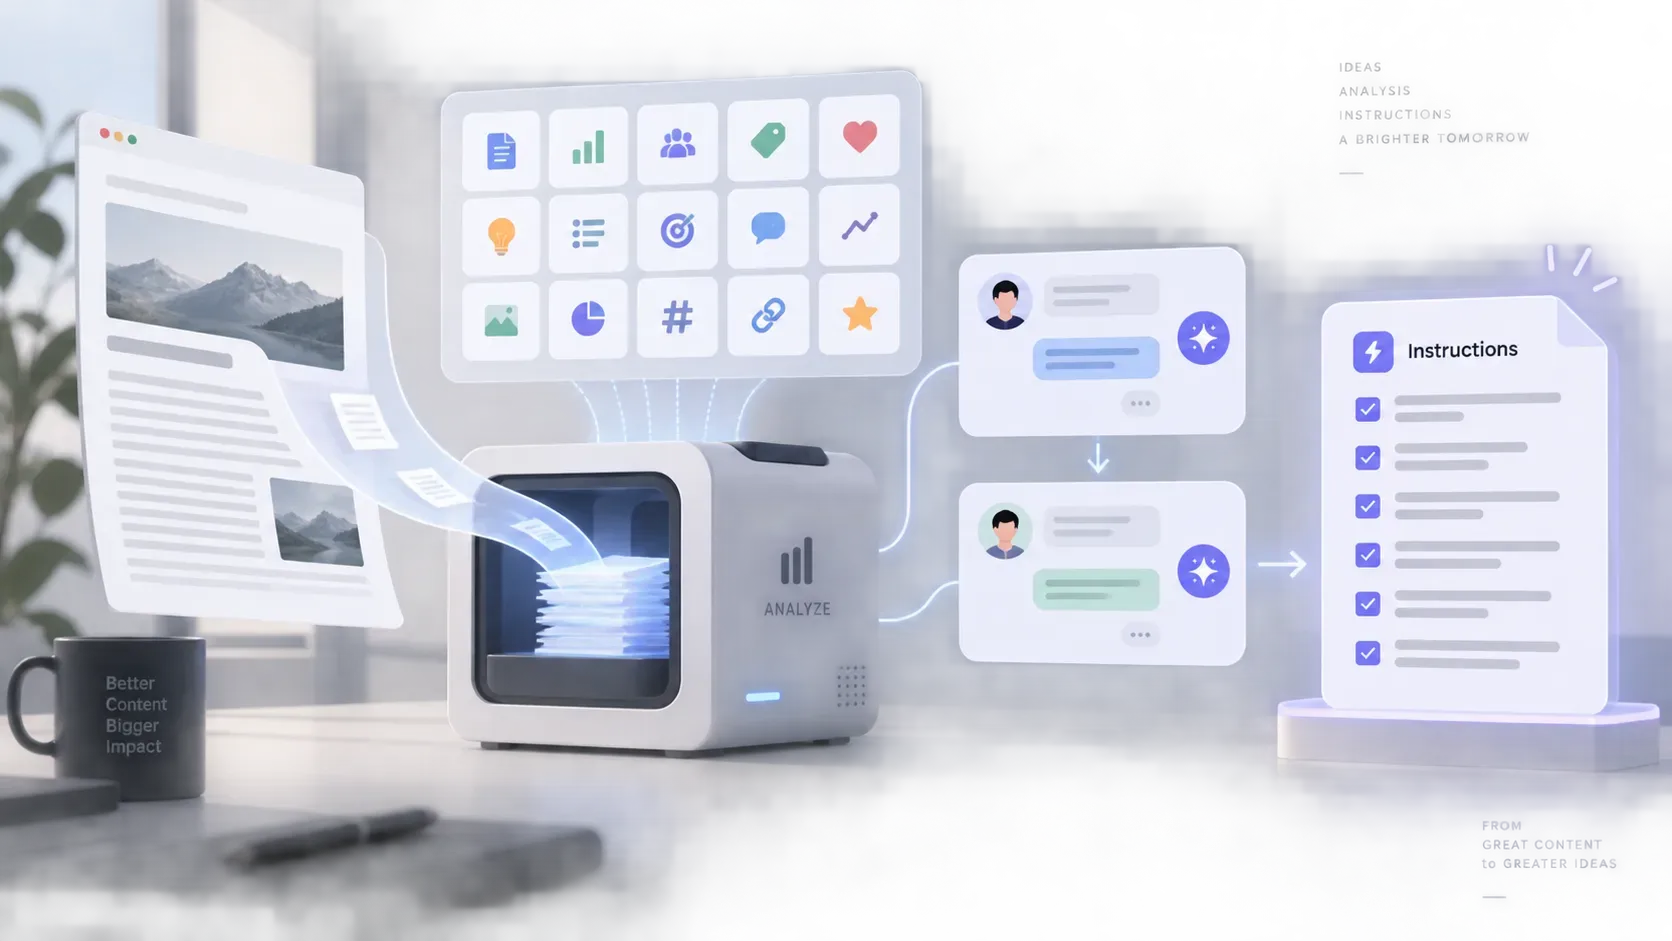
这是全产线最值钱的一段,核心是一个十五维度的分析框架。我把这十五项摊开给你看,创作视角的确立、标题设计方法、开头写作技巧、文章结构编排、语言风格把握、表达方式与修辞、写作技巧应用、叙述角度选择、表达特色展现、句式变化运用、写作风格选择、名言金句引用、SEO 关键词优化、结尾写作方法、整体风格一致性。爆款文章里能捞的要素,基本都在这十五个格子里了。
分析一篇,提炼一份覆盖这十五个方面的写作指令。分析五篇、十篇,指令越合越准。
实现上有个关键技巧,多轮对话。分析模块走 OpenRouter 的 HTTP 调用,不是一个模块一把梭,是两个模块接力。第一个模块发 System 角色和文章正文,System 里定义角色为文章写作特色分析助手,User 里放标题和正文,拿到分析结果;第二个模块把前一轮的完整对话历史原样带上,请求体里的 Messages 数组摆四条消息,System 的角色定义、User 的文章内容、Assistant 的分析回复,再加一条新的 User 指令,要求基于分析结果逆向生成写作指令。
单轮分析和两轮接力的差距,比想象中大。模型先充分理解这篇文章好在哪里,再带着这份理解去反推指令,产出的指令质量完全不是一个量级。
为什么新指令用 User 角色不发 System。System 权重太高,属于终极指令,后面的分析要求还要持续追加,用 User 更灵活,实测效果也更好。
把上一轮的输出完整喂回下一轮,产线的智能就是这么一轮一轮攒出来的。
中间有个坑必须提前说。爆款原文存在 Notion 页面的 Block 里,只要正文留了空行,每个空行都会被当成独立 Block 返回,一篇文章被拆成七八段,下游直接乱套。两个解法,源头保证整个页面只有一个 Block,或者加一个 Text Aggregator 模块兜底合并。老雷的建议是后者,不管 Block 有几个,聚合器都能拼回完整文本,稳。
分析五篇就有五条指令,但下游对话一次只吃一条,所以要做合并。遍历提示词库拿出全部指令,Text Aggregator 拼成一段,再让模型把多条总结成一条综合指令,状态标成「使用中」,方便下游精确定位。实测合并后的指令覆盖面明显高于任何单条,创作视角、标题设计、开门见山、结构编排全都在。
分析一百篇会怎样。那就不只是一条提示词了,是一本自己长出来的爆款写作指南。
顺带说一句这套架构对团队的意义。指令沉淀在提示词库里,状态字段标着「使用中」,谁来接手都能看懂当前产线用的是哪一版写作风格。换赛道的时候不用推翻产线,把库里换一批新风格的分析素材重新合成一遍就行。提示词库才是这条产线真正的资产,模块只是厂房。
素材太薄,就别硬写
中段抓热点。一个 HTTP 模块调免费的豆瓣热点接口,一次回来三十条实时热点。再过一个分类模块,让模型按情感、体育、娱乐、社会这些类目逐条打标,以 JSON 输出分类和理由,Router 按条件只放行目标类目。我们做情感类内容,政治文化类的热点就直接拦在外面。分类让模型顺手写一句理由,这一句不是废话,跑批的时候抽查分类准不准,看理由比看结果快得多。
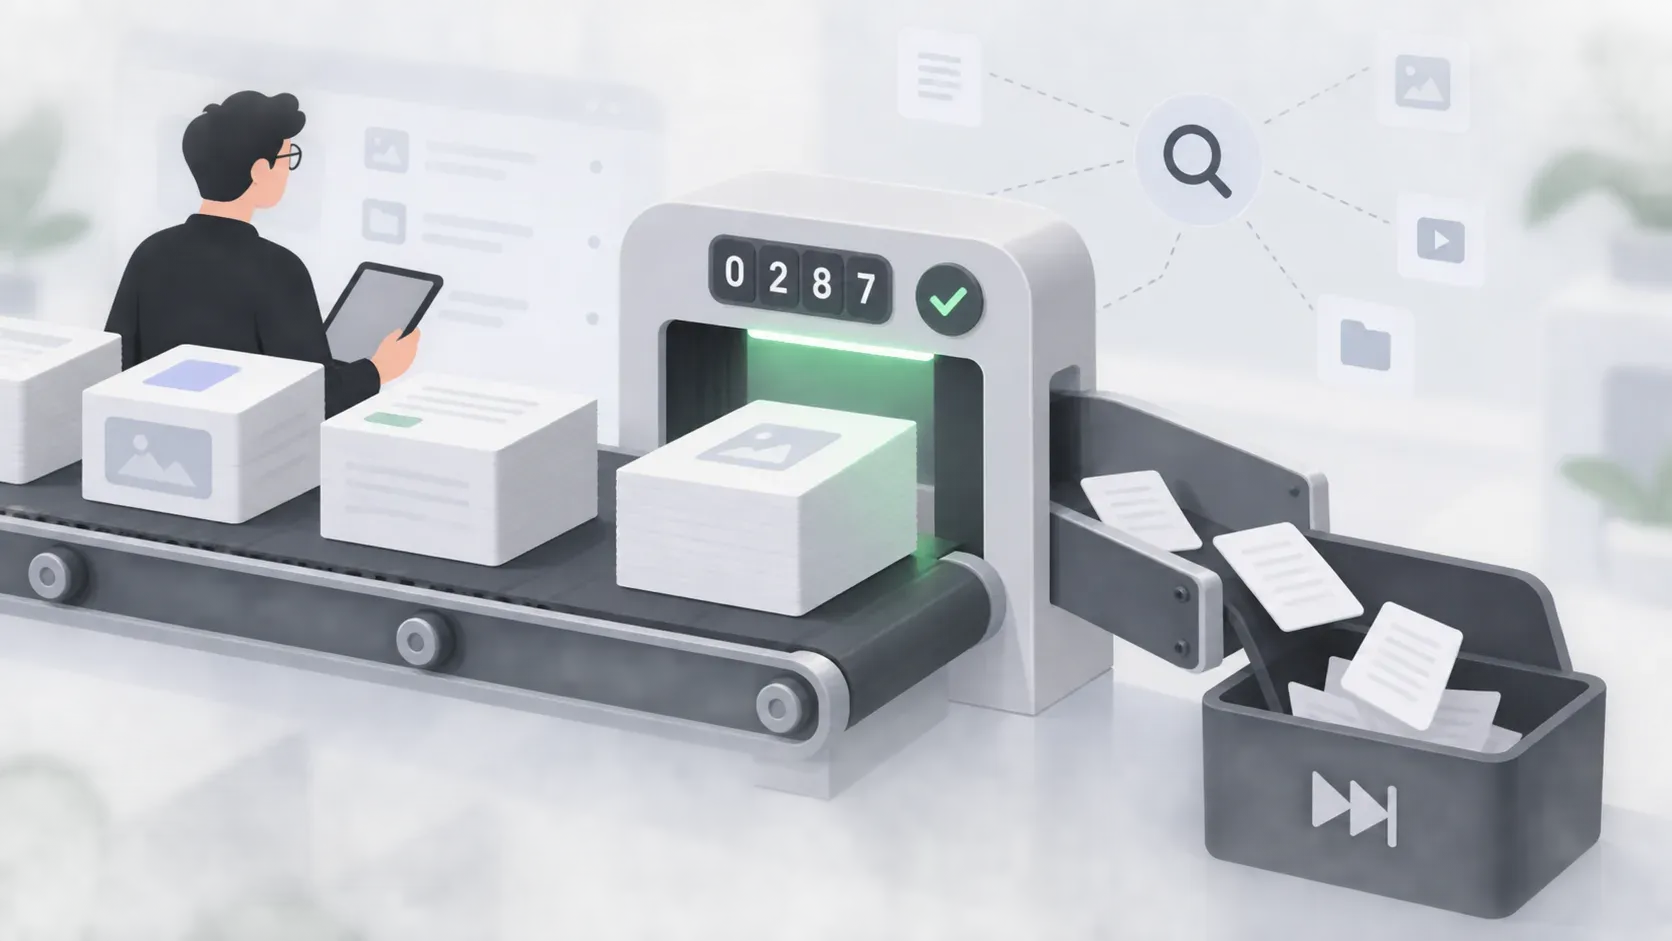
下段生成前还有一道容易被忽略的质量闸。用热点标题去 EXA 检索十篇相关素材,素材拿回来先过一个 Jina 的免费 Token 计数接口。为什么多此一举,有些热点太新,互联网上还没沉淀出足够的中文内容,素材 Token 不到一万,硬生成的文章质量一定稀碎。
Router 在这里设一道门槛,Token 够一万走生成分支,不够就把状态标成「素材不足」,直接跳过。
自动化产线最贵的不是算力,是批量生产垃圾的成本。
薄素材硬写,产线越自动,废品出得越快,这道闸拦的不是流量,是口碑。
过了闸的文章生成模块,请求里三样东西齐活,「使用中」的写作指令、热点标题、EXA 检索并预处理过的素材。指令给专业度,热点给时效,素材给血肉,成品存回 Notion,状态改「已完成」。
一条工作流,四个范式全占了
给 FDE 同行一个视角,这条线顺手把智能体教科书里的四大范式全实现了。
反思,两个模块接力做多轮对话,第二轮基于第一轮结果继续深化;工具使用,EXA 检索、热点接口、Token 计数全是外部工具调用;规划,Router 条件分支让流程按数据状态自己选路;多智能体协同,三个工段互相不认识,全靠 Notion 状态字段接力,像三个微服务隔着消息队列干活。
这四样凑齐,产线的行为就不再是线性的了。同一条热点进来,素材够走生成,素材不够自己标记跳过,下一次运行和这一次运行可以走完全不同的路径。排查问题的时候思路也要跟着换,别再顺着连线找,去库里看状态,状态就是这条产线的日志。
所以别再把 Make 当连线工具看。加了模型判断和状态驱动之后,它已经是能做决策的智能体编排层。
上线前过一遍这五道检查
收尾给一份交付清单,照着过一遍再上线。
素材要同风格。五篇里三篇煽情两篇理性分析,合成出来的指令自相矛盾,产线会稳定输出精神分裂。数量五到八篇起步,能凑到二十篇以上高度一致的爆款更好。
Notion Block 保持干净,空行的坑再提一次,Text Aggregator 兜底永远值得。
JSON 请求体里的双引号是第一事故现场。在代码编辑器里写好、校验通过再粘进 Make,手滑多删一个引号,那个报错能查到你怀疑人生。
鉴权头前缀要背下来,OpenRouter 用 Bearer 加空格,Replicate 用 Token 加空格,前缀用错或漏了空格,都是 401。
别一口气上三段。先只跑提示词生成段,跑稳了再接热点和成文。想提质也有三个实测有效的方向,加大分析篇数,换更强的模型档位,扩素材检索渠道。
这套模式也不止能产文章。拆口播稿的风格再生新脚本,拆竞品文案再出差异化内容,凡是要模仿学习的场景,都能套这个架子。真正值钱的资产,是你库里那批越合越准的写作指令。
写作这门手艺传了几千年,一直都是师傅带徒弟,拆名篇、仿写、再慢慢长出自己的腔调。现在这套流程被拆成了模块和数据,爆款进库,指令出库,机器照着规律出活。老雷不觉得这会抢走谁的饭碗,它只是把「模仿」这个最枯燥的阶段自动化了,真正的判断,选哪个赛道、追哪个热点、留哪种腔调,还在人手里。产线搭好那天你会发现,你收获的不是文章,是一套可以被反复训练的写作方法论。
下一步很具体,挑五篇你所在领域公认的爆款,丢进 Notion 建库,今晚就把第一段跑起来。