老雷AI实验室
不用开麦录音,Notion 新闻库每天自己长出一期播客
做播客的门槛,从来不是不想做,是流程太重。找选题、写稿、录音、剪辑、发布,五道工序道道要人,一期节目从想法到上线小半天就没了。新闻类的播客更狠,时效就是生命,你今天录的明天的听众就不想听了,日更的压力能把人压垮。
配音这一步还有个隐形门槛,你的声音、你的麦克风、你家的环境音,全是变量。多少人卡在「今天不想开口」,节目就断了。周末攒了七条选题,周一到周五全泡汤,这是我见过最多的一种播客死法。
这篇拆一条我跑通的全自动播客流水线,七个模块串起来,从新闻库取材到成品音频归档,一期只要一到两分钟,全程无人工。Notion 新闻库里取当天三条新闻,ChatGPT 写成口播稿,OpenAI 的 TTS 直接合成 MP3,传上 Google Drive,回写 Notion 存档。你的新闻库要是一直有前道流水线自动喂料,这个播客就是每天自己长出来的。
场景也不止新闻播客。企业内部简报、教育资讯速递、金融市场日报、科技动态汇总,换个新闻源加一段提示词,就是一个新领域的节目。对没有录音条件的团队和个人,这条线几乎是零门槛起步的路径,你需要的只是一间安静的服务器机房,而它本来就安静。
先看全局,七个模块一条线
整条线我按数据流的顺序过一遍。
Notion Search 从新闻知识库取素材,Text Aggregator 把多条新闻拼成一段文本,OpenAI 对话生成口播稿,Parse JSON 拆出标题和稿件,OpenAI TTS 把稿子变成语音,Google Drive 上传音频拿链接,Notion 创建条目存档。一次运行,一期完整播客就躺进你的库里了。
前面几步和常规的自动化链路差不多,这期真正的两个新面孔是 Text Aggregator 和 OpenAI TTS,一个管喂料,一个管开嗓,值得各讲一节。
先交代一下前提,这条线吃的是 Notion 新闻知识库,这个库本身也可以是自动的。RSS 采集加全文抓取那条产线跑起来,新闻每天自动进库,播客这条线跟在后面吃现成的,两条线首尾相接,从新闻发布到播客上线全程没有一个真人出场。库还是空的也不用急,先手动塞几条新闻把播客线跑通,采集线随时可以补上。
喂料有讲究,Text Aggregator 合并三条新闻
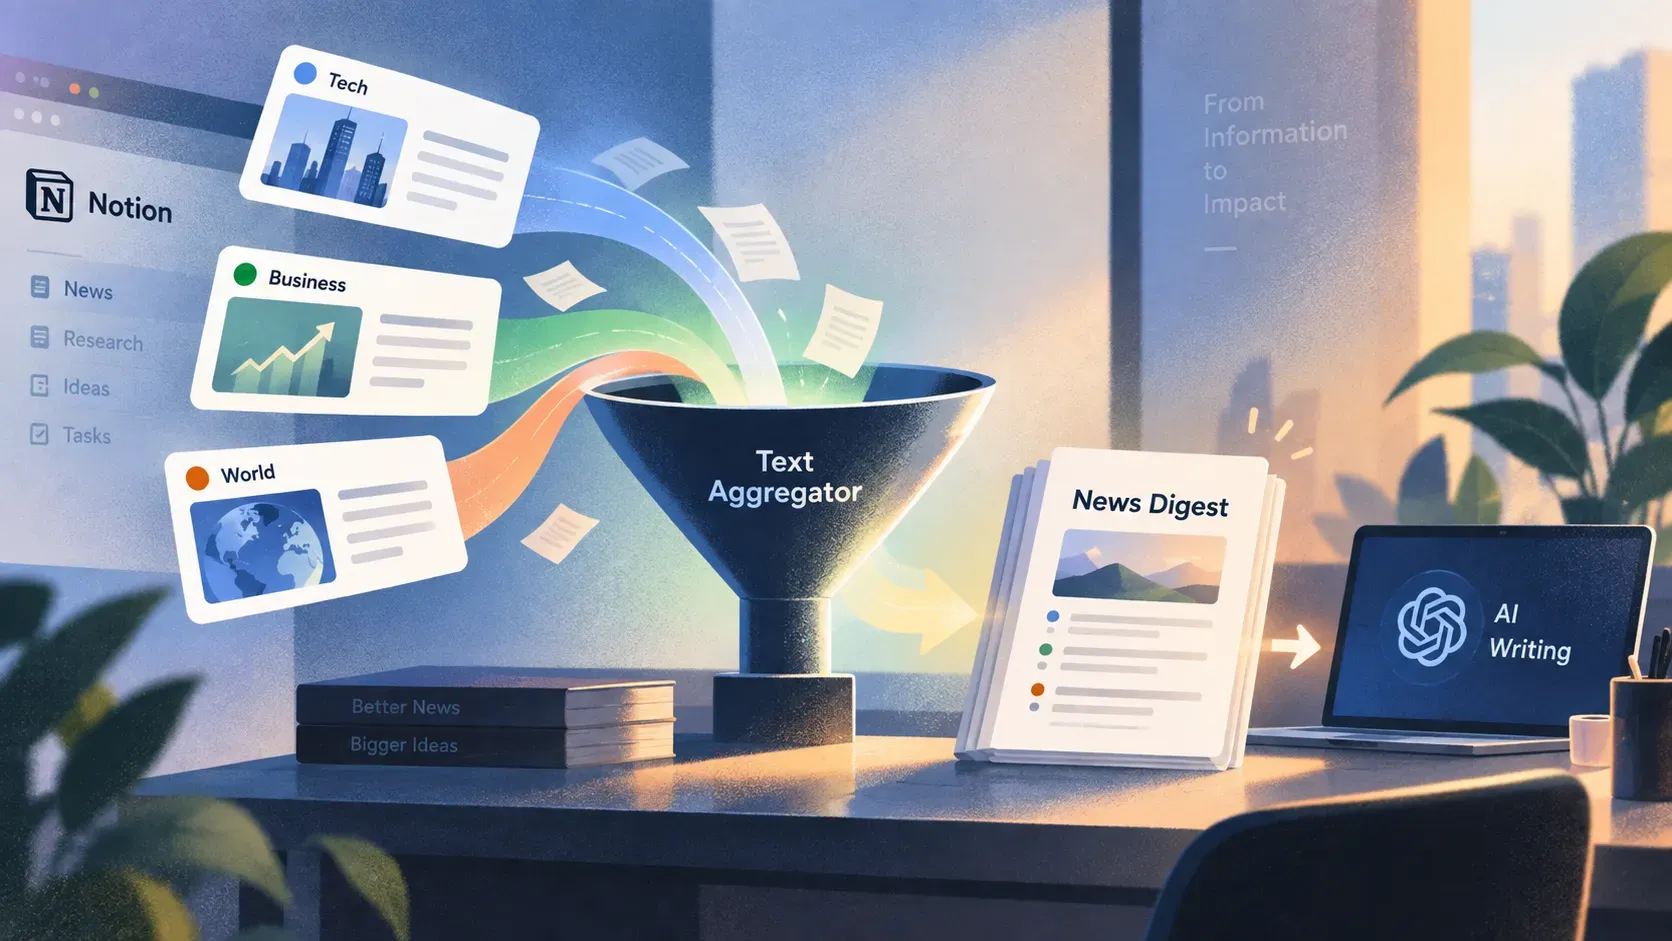
Notion 取回来的不是一段文字,是三条独立的数据,Make 里叫三个 Bundle。直接把三个 Bundle 塞给 ChatGPT,模型会把它们当三件不相关的事,写出来的稿子是三段拼接,生硬得很。
Text Aggregator 这个模块就是干合并活的。在 Tools 里找到它,Source Module 选上一步的 Notion 模块,Text 字段选新闻内容属性,三条新闻的内容就拼成一个整体文本,作为单个输入传给下一步。
这个模块本身没有任何花哨的参数,朴素到容易被跳过,但它在这条线里的位置是承上启下的,没有它,后面的写稿模块拿到的永远是散装原料。
这一步赚了两笔。一笔是操作数,三条数据并作一条,后面链路只跑一次,成本直接下来。另一笔在生成质量上,模型拿到的是一份完整的新闻合辑,能通盘权衡哪条放前面哪条带一句就够,写出来的是一期节目,不是三段朗读。
取材这边还有个实用细节,Notion 模块的数量设 3,一期覆盖三条新闻,你可以按节目体量调。想只抓当天的内容,在 Filter 里加日期条件,创建时间等于今天,老素材就不会混进来,播客的时效性靠这个小开关锁死。
口播稿质量,看提示词和给不给 JSON 示例
写稿模块选 OpenAI 创建对话,模型推荐 GPT-4o,口播稿对语言的流畅度要求高,这一步的模型钱不该省。
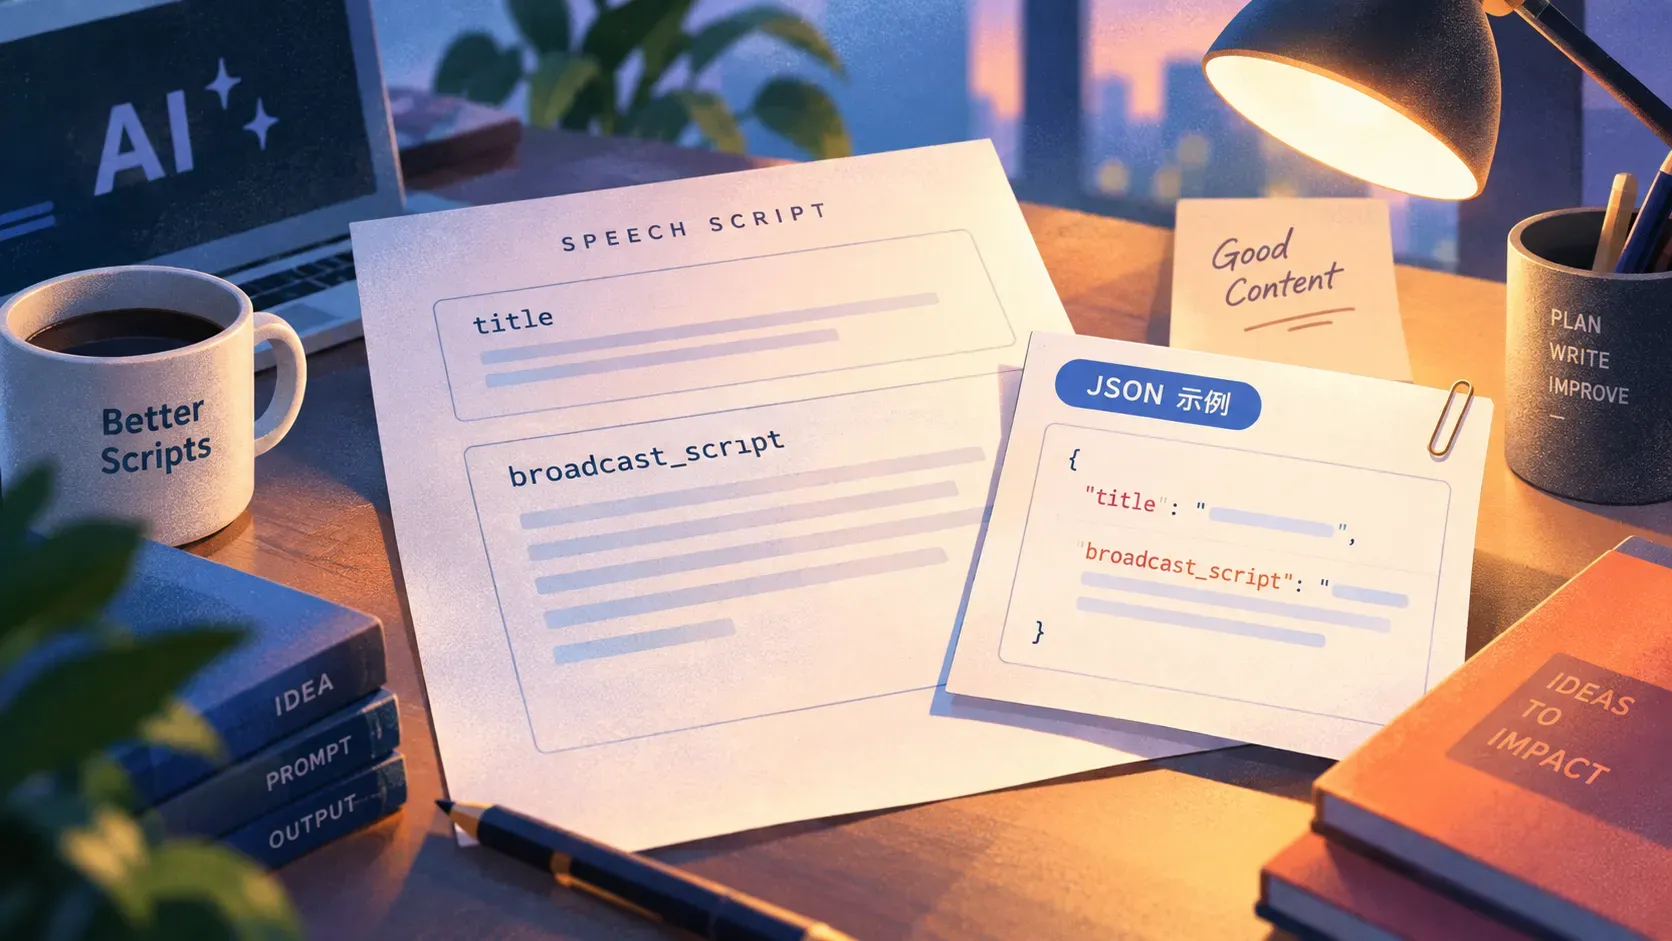
System 提示词几个关键约束。角色定义成口播稿撰写助手,任务是把新闻内容改写成自然流畅的中文口播稿。字数控制在 1000 字左右,这个数不是拍脑袋,一千字按正常语速念出来三四分钟,正好是一期资讯节目的舒服体量,再长听众就划走了。以固定开场白开头,让每期节目有辨识度,频道名换成你自己的。输出 JSON 格式,字段两个,title 和 broadcast_script。
这里有个新手最容易栽的坑,提示词里要给 JSON 一个明确的示例。不给示例会怎样,模型每次的字段名随心情,这期叫 title,下期叫「标题」,你的 Parse JSON 模块按固定字段名解析,当场断链。断链的排查还特别折磨人,工作流看着都对,就是数据过不去,翻半天日志才发现是字段名换了个叫法。给示例不是多余的动作,是把输出格式焊死。
User 消息传两个内容,一个用 now 函数取当天日期,告诉模型生成哪天的新闻,一个传聚合后的新闻文本。高级设置里 Token 数设 2000,口播稿比较长,上限给足,输出格式选 JSON。
开嗓这一步,OpenAI TTS 参数给全
Parse JSON 拆出标题和稿件之后,就到了这条线的灵魂环节,OpenAI 的 Generate Audio,文本转语音。
参数直接给你。Model 选 tts-1,标准模型,延迟低。Input 填解析出来的 broadcast_script。Voice 按喜好挑,OpenAI 提供多种音色,建议试听一遍选个耐听的,你的听众要天天听它。Format 选 mp3,兼容性最好。Speed 设 1.1,比常速略快一点,符合现在听众的耳朵习惯,资讯类内容尤其合适。
语言这件事完全不用操心,TTS 按输入文本的语种自动出声,中文稿出中文音,英文稿出英文音,几十种语言都支持。也就是说这套流水线改天做英文节目,配音环节一个字不用改。
对音质有更高要求的,tts-1-hd 模型等着你,代价是生成速度慢一些。日常资讯类节目,tts-1 够用,别为听不出来的差别多花钱,省下的预算拿去补 API 额度更实在。
播客的产能瓶颈从你的声带,移到了你的新闻库更新速度。
归档和收尾,两个模块四行字段
TTS 输出的是二进制音频文件,得先传到云存储才能拿到能访问的链接。Google Drive 模块选 Upload a File,选好目标文件夹,文件来源接 TTS 产出的 MP3,文件名用解析出来的 title,上传完返回一个 Web View Link,点开就能播,转发给同事也不用教人家怎么下载。
收尾前的归档动作,Notion 建一个播客库,三个字段收编一切。播客名称用 Title 类型,填 title。口播稿件用 Text 类型,填 broadcast_script,文字稿留着,改稿和检索全靠它。媒体文件用 URL 类型,填 Drive 的链接。每跑一次,库里多一条完整的播客记录,稿件和音频手拉手躺在同一条记录里。
顺手答几个高频疑问。TTS 服务不是非 OpenAI 不可,Google Cloud TTS、Azure TTS 都能走 HTTP 模块接进来,国内的阿里云和讯飞也都有 API,哪家性价比好用哪家。音频想直接进播客平台,在工作流尾部追加步骤,小宇宙、Apple Podcasts 的上传接口都能接,Drive 只是中转站不是终点。
节目风格全在提示词里调,这条给你展开讲。人称视角决定亲近感,第一人称念起来像主播在跟你唠,中立第三方像正规电台,企业简报建议后者。语气风格管调性,严肃专业、轻松幽默、通俗易懂,一句话的事。内容深度决定篇幅结构,简要概述就三条新闻各一段,深度分析就得给模型留出展开的口子。品牌元素是辨识度,开场白、结束语、频道名称写进 System 提示词,每期自动带上。这四类参数改的都是同一处,System 提示词里对应的描述,改完重跑一次立刻能听效果。
给要交付这条线的工程师一份上线路径。一,Notion 建播客库,三个字段建好,先手动塞三条新闻进知识库。二,七个模块按顺序接,每个模块单独跑测试,尤其是 Text Aggregator 的输出,展开看一眼拼接结果再连下一步。三,TTS 先用一段短文本试音,选定 Voice 和语速再上全长口播稿,音色的决定不该留给运气。四,整线跑通后连跑三天,每天检查 Notion 记录里稿件和音频是否成对、链接是否可播,稳定了再接进调度。
收个尾。这条线跑起来之后,你每天的真实工作量是打开 Notion 点一下播放键,听听今天这期质量如何。老雷的建议是,别把省下来的时间全拿去多开几档节目,先花一周听懂 AI 配音的语感边界,哪些稿子机器念得自然,哪些需要你在提示词里加口语化的缓冲,摸清这个,你的播客才立得住。机器开嗓的时代,听感把关的人反而更值钱。
回过头看这条线,它真正改变的不是播客的制作成本,是内容形态的选项。一支没有主播的团队也能拥有自己的电台,一个不敢开口的人也能天天发声。老雷这些年看下来,很多东西做不起来,不是能力不够,是那道开口的门槛太吓人,现在机器替你开口了,剩下的就看你有没有话想说了。