 老雷AI实验室
初译审校再润色,给 PDF 翻译装一道反思关
先看一句译文,「很多周日我都会在附近的披萨店买一块披萨」。
词没错,语法没错,可你一眼就看出这是英文硬翻过来的,一股洋腔。单个句子尚且如此,整本书这么翻下去,读者撑不过三章。
这事怪不到模型头上。大模型直译,七八十分稳稳拿到,问题出在流程太粗,一遍过,没有反思,没有校对,没有文体适配。人类译者的老规矩是初译、审校、润色三道工序,凭什么机器就只许跑一遍。
再算一笔账。研究者啃外文文献,跨境团队处理外文技术文档,找人工翻译按千字报价还得排队几天。模型直译把几天的等待压到几秒钟,省了等待,牺牲的是质量,你还得花一小时逐句往顺了捋,机器的活人收尾,这笔账其实没赚。要真省时间,就得把收尾那道工序也交给流程。
我们照这个思路搭了一条反思翻译产线,把审校环节做成了流水线上的正式工位。框架借的是严复的信达雅,让大模型分三个角色接力,翻译专家出初稿,评审助手按信达雅三个维度提改进清单,优化专家逐条落实出终稿。实测对比下来,终稿在通顺度和文学性上比初稿明显高一截,还是那句披萨,「很多周日」自己就变成了「经常在周日」。
一个场景,两个入口
整套产线架在 Make 上,输入输出全走一个 Notion 知识库,靠状态字段分流。
库里一行就是一笔翻译任务。状态字段三个值,标「开始 PDF」走文档路径,标「开始文本」走短文本路径,跑完改「已完成」。Router 按状态里包含 PDF 还是文本来判断走哪条支路,一个场景管两类活,不用为第二种需求复制一套工作流。短文本路径简单得多,从库里读出待译文本,过一个模型直接翻,结果写回结果字段,翻译几段话不至于兴师动众走文档那条重流程。
几个属性是给产线下指令用的。模型字段是个下拉,值直接映射到 OpenRouter 的 model 参数,必须和官方模型 ID 一字不差,写成 openai/gpt-4o-mini 就精确调用那一个模型。文本粒度下拉给 100、300、600、1000 四档,管后面长文切多细。源语言、目标语言、术语表都是文本属性,翻译模块直接引用。
模型切换的体验值得单独说一句。想从性价比档换到效果档,不用碰工作流,在 Notion 里改一下下拉选项,全场景的模型调用一起跟着换。追求性价比选 GPT-4o-mini,百万 Token 不到十元,要效果就挂 Claude。
PDF 进来,先拆成段
文档路径的第一步是提取。Notion 的文件属性会给一个 PDF 地址,HTTP 模块直接调 Jina Reader,回来就是全文的 Markdown。有个小门槛要提前知道,Notion 免费版单文件限 5MB,大文件先拿 iLovePDF 压一道再入库,别等报错了回头找原因。
第二步是整条产线里最见功力的部分,长文自动切割。一篇 PDF 几万字,模型单次输出有限,必须切段喂。这里用两个模块配合,Repeater 决定分几段,Set Variable 决定每段取哪截。
Repeater 的公式是全文长度除以文本粒度再向上取整,九千字符、粒度一千,就重复九次。Set Variable 用 substring 截取,第 i 次迭代取上一段的结尾到这一段的结尾,一截一截正好铺满全文。
英文源文本在这里埋着一个经典陷阱。length 函数对英文返回的是字母数不是单词数,Hello 会返回 5 而不是 1,按单词粒度设计的切段公式直接就错位了。解法是先判断源语言,用 contains 函数查源语言字段里有没有「中」字,中文直接除以粒度,英文就把粒度乘以六再除,按平均一个单词六个字母折算。
切出来的每一段先过一道格式整理模块,删页眉页脚页码,清多余空行,不翻译只清理,统一成标准 Markdown。别省这道工序,喂给翻译模块的文本越干净,译文格式越稳。学术 PDF 的参考文献一节尤其受用,页眉页脚混进来,译文里就会凭空多出一堆断句诡异的碎段落。
长文翻译的正确姿势不是一口吞,是切成一口一个的段落,再按顺序拼回去。
信达雅怎么变成三张工单
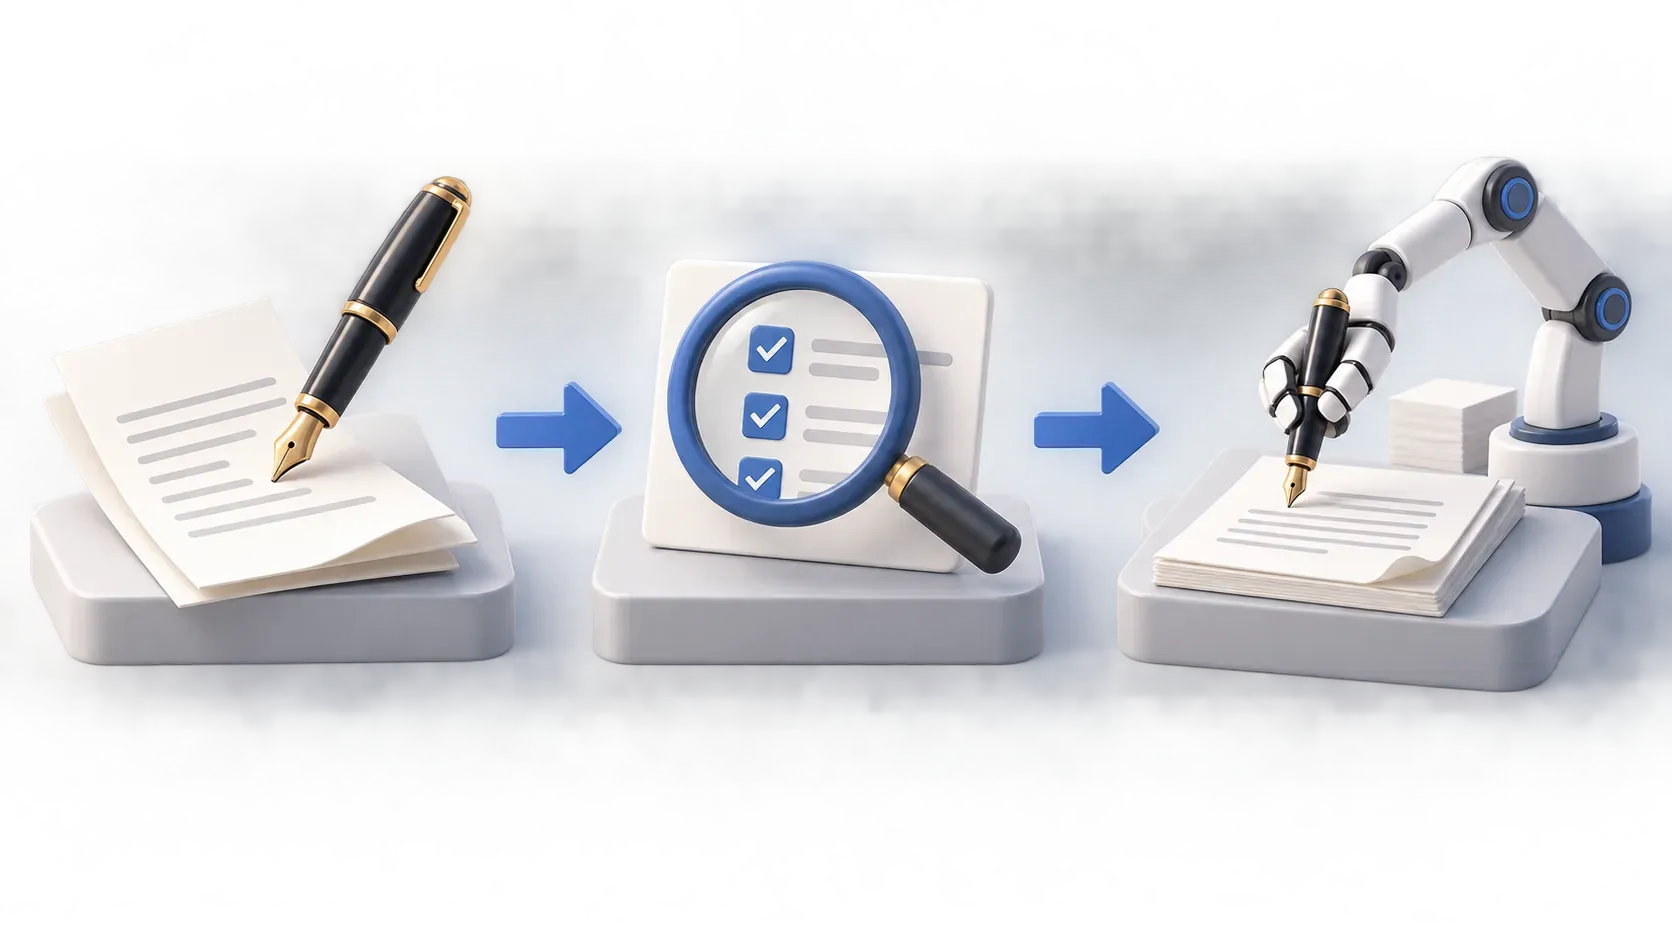
初稿模块定义一个资深跨语言翻译专家角色,要求先识别文本类型,技术文档、文学作品、法律文件各走对应的翻译策略,遵循信达雅标准,专有名词保留原文不音译,对照术语表保持一致,货币、日期、度量单位做本地化。源语言、目标语言、术语表都从 Notion 属性动态映射进去,真正的参数化翻译。
评审模块是这套产线的灵魂。它扮演翻译评审助手,不改稿,只出一份改进清单,每条建议都带三样东西,问题描述、原译文、改进后的译文,审的就是信达雅三个维度。给两个实测改出来的例子感受一下。「编辑人工智能代码是新时代的识字能力」,改成了「AI 编程,新时代的必备技能」,这是达的维度。「职业是一段长达数十年的旅程」,改成了「职业如同一场漫长的旅途,绵延数十载」,这是雅的维度。
改进建议给几条,不是拍脑袋,是个公式,文本粒度除以五十向上取整再加六。一千字的段对应二十六条,五百字对应十六条。这个数是实测调出来的,老雷一开始也试过要求一百五十条,结果模型提不出那么多有效意见,开始编造无意义的建议来凑数,评审就失真了。建议数量和段落长度挂钩的道理也在这,段越长可挑的毛病越多,量给少了审不出东西,量给多了逼着模型注水,公式就是把刻度卡在中间。
终稿模块扮演翻译优化专家,吃三样输入,原文、初稿、改进清单,规则只有一条,严格按清单逐条落实,不许自行发挥。这条约束保证了每处修改可追溯,验收的时候拿清单对着终稿逐条核就行。评审只出清单,终稿只对清单,权责分开,机器的活才验得动。
藏在细节里的三个坑
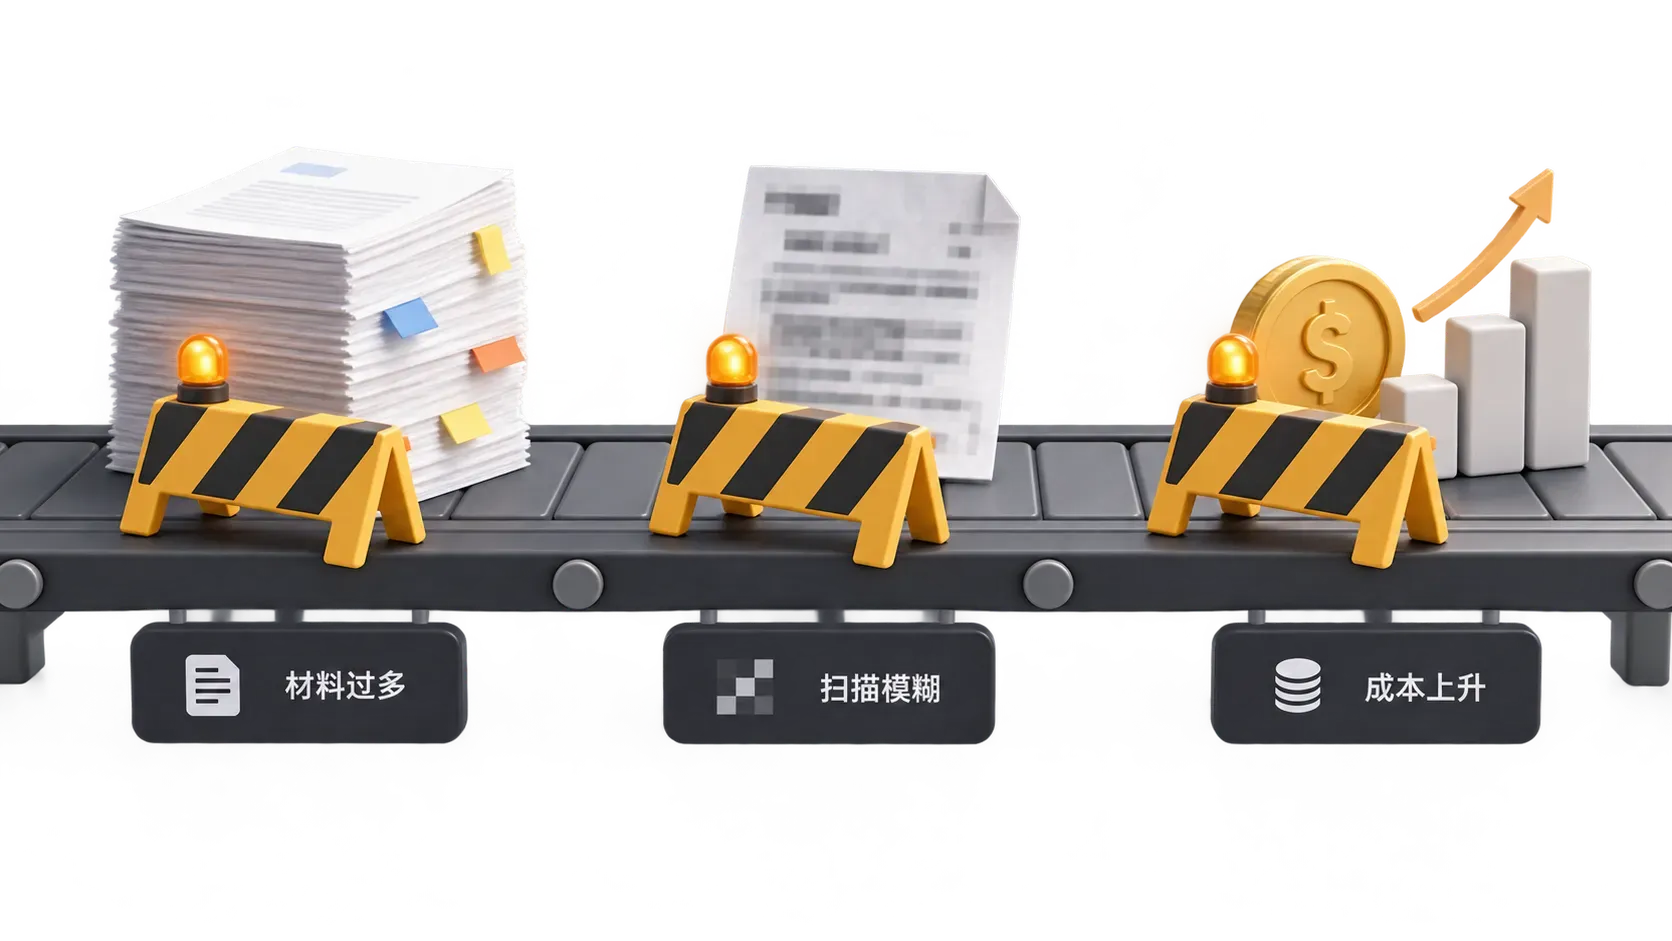
交付的时候有三个坑,先替你踩过了,都是跑起来之后才暴露的那种。
第一个,Notion 的文本属性有 2000 字上限,长文档的译文塞不进去。解法是让每段译完追加写进 Google Docs,它当译文的大仓库,全部段落跑完再把 Notion 状态改成「已完成」,一条任务从头到尾状态可查。
第二个,扫描件和复杂排版的 PDF,Jina 解析效果会崩。格式整理模块能兜一轮,兜不住就换 Kimi 的 PDF 解析 API,别在一棵树上吊着。
第三个,成本和轮数成正比。想再榨质量,有信达雅各反思一轮的加强版,三轮共六十条建议,效果确实更好,API 账单也跟着翻倍。按文本的身价选档,合同和出版物上加强版,内部资料标准版足够。
顺带交代切割粒度怎么选,这是唯一一个由你手调的质量旋钮。长文档赶进度选一千,效率优先;文学文本、合同条款选一百或三百,段越短模型嚼得越细,Token 成本也越高。老雷的建议是先拿三百跑一章看看手感,再决定整本的档位。
老雷给大家提个醒,验收反思翻译别只看终稿顺不顺,抽几段对着改进清单看,清单里的意见是不是真落在终稿里了。清单和终稿对得上,产线才是健康的。
反思机制不止翻译
这套架构真正的价值,是那个「初稿、评审、优化」的三段式,它跟翻译本身没有绑定关系。把中间那张反思工单换掉,两头模块原样不动,就是一条新产线。评审维度换成 AI 味检测,它是文章去 AI 味的改写线;换成目标作者的文风特征,它是风格模仿线;换成学术规范,它是论文润色线。反思这个词听着玄,落到工程上就是一件事,给输出加一道独立的质检工位,让模型自己当自己的审校。
严复在一百多年前提信达雅,靠的是译者一个人的功力,今天这三个字被拆成了三张提示词工单,进了流水线。方法论没变,变的是执行它的成本,从一个人的十年功力,变成一次几分钱的 API 调用。
下一步很好落,挑一段你一直翻不顺的英文,今晚把三个模块串起来,初译和终稿各读一遍,差距会替你做决定。