老雷AI实验室
几十页 PDF 丢进 Notion 就出核心观点,Kimi 文档速读产线拆解
下午四点,文件夹里躺着五份 PDF,两份行业研报,一份白皮书,一份别人转来的会议纪要,还有一篇拖了一周没动的论文。每份几十页,认真啃完一份,半小时起步,一小时不封顶。一下午就这么交代给阅读了,还没算读完之后写摘要的时间。
做投研的、做产品的、做研究的,谁没过过这种下午。
我是被这种下午磨烦了,才把这件事整个交给了产线。现在的流程是,PDF 拖进 Notion 数据库,状态改成「开始」,人就可以走开了。Make 会自动下载文件、把文本抽出来、调 Kimi 生成十个核心观点,再写回同一条目,状态自动翻成「已完成」。整条链路全自动,人的活只剩收尾看一眼摘要,判断哪份值得精读。
这篇把它拆开讲,八个模块各自干什么、哪里有坑、怎么保证不趴窝,一次说清。
选型这笔账,Kimi 赢在门槛
文档总结这个活,难点不在「总结」,在长。几十页的 PDF,普通对话窗口塞不下,硬塞就会被截断,摘要变成猜谜。
Kimi 在这件事上是把好手,上下文窗口给到 128K,几十页甚至上百页的文档能整本吃进去。模型挂 moonshot-v1-128k,文档只有几页的话换 moonshot-v1-8k,成本直接降一档。老雷的建议是先看自己文档的典型厚度再定档位,短文档占了日常大头就别执着于最大的窗口,那是拿钱烧带宽。
另一个选型理由是获取门槛。API Key 在月之暗面开放平台注册就能拿,注册送免费额度,充值走微信支付宝,不用折腾海外信用卡。对申请 OpenAI API 有困难的团队,这条路基本没有门槛,试错成本几乎为零。
还有一个很多人不知道的点,Kimi 提供了独立的文件接口,POST https://api.moonshot.cn/v1/files,purpose 填 file-extract,专门干「从 PDF 抽文本」这件事。
这个设计值得单独夸一句。把 PDF 喂给模型,常见的土办法是把文件内容读出来拼进提示词,格式损耗、乱码、超长截断,每一样都够你调半天。专门接口把这些脏活全包了,传上去返回一个文件 ID,文本抽取交给它,你只管拿结果。而且抽出来的纯文本既可以喂回 Kimi 自己的对话接口,也可以转手喂给任何别的模型,OpenAI、Claude 都接得住。这个接口是整条产线的地基。
丑话也说在前面,这条产线不是人人都值得搭。一周就读一两份文档的人,手动读加口头摘要反而更快,搭产线的时间够读一个月的量。它值回成本的量级,是每周几十份的稳定吞吐,或者「每一份都必须过一遍」的合规场景。先掂量自己的量,再动手。
Notion 里新建一个「文档分析」数据库,属性只要三个。文档名称,Title 类型,放 PDF 的名字。状态,Select 类型,两个选项,「开始」和「已完成」。文件,Files 类型,PDF 附件就传在这儿。
看着朴素,但状态字段是整条产线的触发机制。Make 每次运行只检索状态为「开始」的条目,处理完自动改成「已完成」,同一条目永远不会被二次消费。你要做的事从头到尾只有一件,把 PDF 丢进去,状态点成「开始」。
八个模块,一条直线
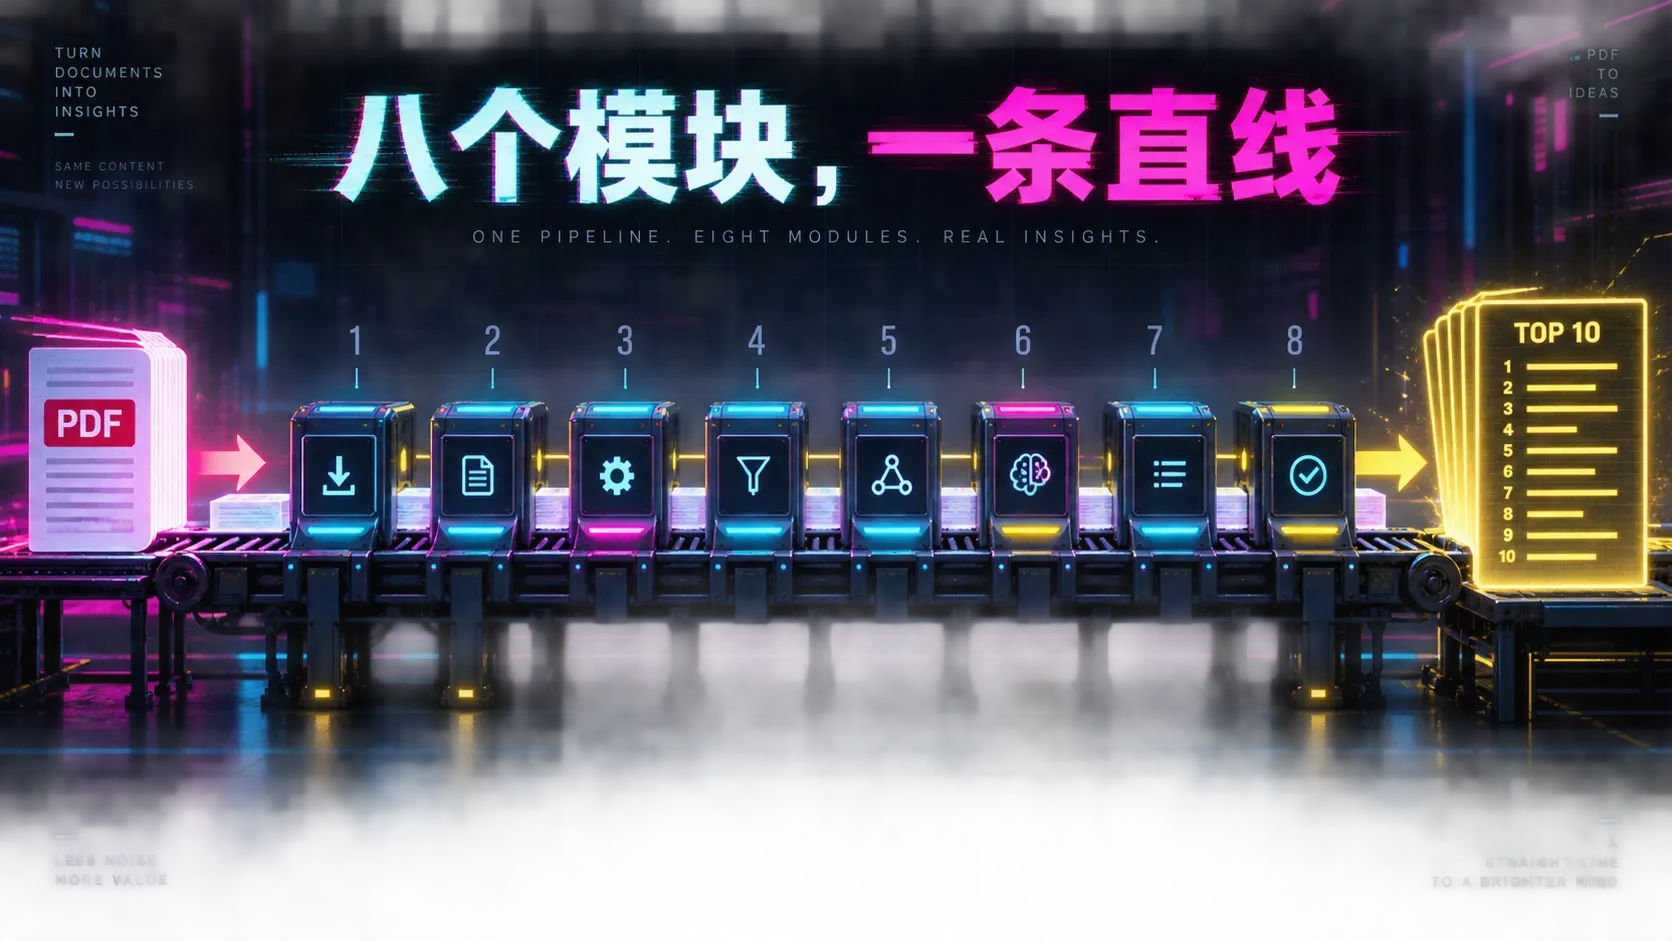
整条产线八个模块,串成一条直线,没有分支。
Notion 的 Search Objects 模块打头,关联这个数据库,筛选条件设状态等于「开始」。注意这里的文本必须跟 Notion 里的选项一字不差,选项叫「开始」筛选就写「开始」,多个空格都匹配不上。一次只取一条,后面细说为什么。
取到条目,HTTP 的 Get a File 模块把 PDF 下载进 Make 的临时存储,URL 直接映射 Notion 返回的文件链接字段。
第三个模块 HTTP Make a Request,把这份 PDF 发去 Kimi 的文件接口。Method 选 POST,请求头里带上 Authorization,值是 Bearer 加你的 API Key,Body Type 选 Multipart/form-data,file 字段映射上一步下载的文件,purpose 字段填 file-extract。发送成功,Kimi 返回一个文件 ID,后续步骤全靠这个 ID 串起来。
然后 Sleep 等一会儿。文档短,等 1 秒就够,几十页的大文件建议给到 60 到 120 秒,让 Kimi 有时间把文本抽完,抽一半就去取,拿到的会是不完整的结果。
等待结束,再发一个 GET 请求到 https://api.moonshot.cn/v1/files/{file_id}/content,file_id 替换成上一步拿到的 ID,Parse Response 打开,返回的就是整份 PDF 的纯文本。
拿到文本别急着用,先过一遍 Text Parser 的 Replace 模块做清洗。这是进对话接口前最重要的一道工序,值得单独展开,下一节说。
清洗完的文本进收尾那个 HTTP 模块,发去 https://api.moonshot.cn/v1/chat/completions,Body 用 Raw JSON。messages 里放两条,system 角色写清楚「你是 PDF 文档总结助手,从文档中提取十个最重要的核心观点,简明扼要地总结」,user 角色把清洗后的文本拼进去,temperature 压到 0.3 求稳。高级设置里把超时时间拉到 300 秒,长文档的处理不一定快,默认超时会掐断正常请求。
Notion 的 Update Database Item 收尾,状态改成「已完成」,Append a Page Content 把十个观点写进条目正文。回到 Notion 一看,条目从光秃秃一个文件变成了带摘要的档案。
最容易翻车的一步,正则清洗
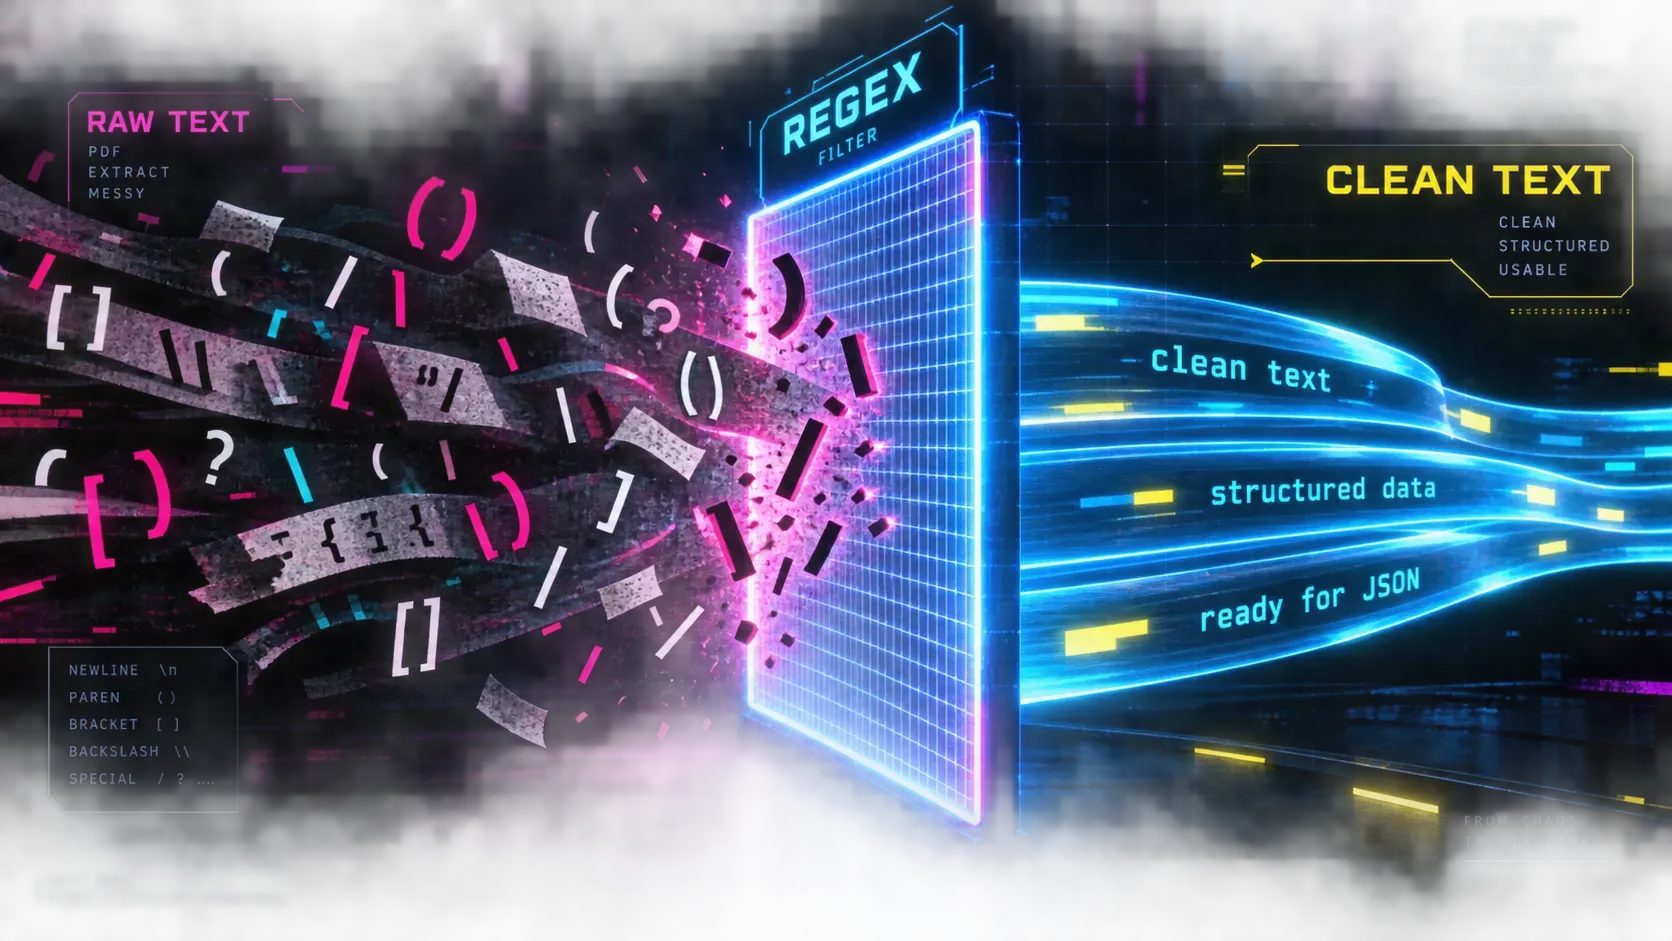
PDF 抽出来的文本从来不干净。换行符、中括号、大括号、反斜杠,还有成对出现的英文双引号,这些字符单看无害,塞进对话接口的 JSON 请求体里就是炸弹。
道理不难懂。JSON 是靠结构字符说话的,引号圈定字符串的边界,大括号中括号圈定层级,反斜杠是转义开关。文档正文里冒出来这些字符,解析器就会把它们当成结构指令去理解,请求体当场被撕碎,接口直接报错,报错信息还特别难读懂。
修法一条正则。Text Parser 选 Replace,Pattern 填一个字符类,内容是英文双引号、大括号、中括号、反斜杠、换行符这几种字符,Replace 填一个空格,Global 和 Case Insensitive 都打开。所有可能破坏 JSON 的字符统一替换成空格,接口拿到的就是一份合法干净的输入。
一行配置的事,漏了就是连环报错,而且是那种让你对着日志怀疑人生的报错。这条正则是整条产线的保险丝,写的时候一个字符都别抄错。
稳定性,三道保险
产线搭通只是及格线,跑得稳才算交付。三道保险都上上。
第一道,状态码筛选器。每个 HTTP 模块后面加一个条件筛选,只放行状态码 200 的响应。哪一步 API 调用失败,产线就在那一步停住,后面的模块不空转,操作数也省下来了。老雷的原则是产线上每一环只信确认过的成功,状态码就是那句确认。
第二道,拿状态字段当锁。为什么检索一次只取一条,因为并发是自动化的隐形杀手,两个条目同时跑,配额、限频、写回冲突全找上门。状态字段处理完立刻改「已完成」,同一条目不会被下一轮二次消费,一进一出,账永远清楚。
第三道,清理文件仓库。Kimi 的文件存储有 100 个的上限,处理完的 PDF 记得在链路末尾加一个 HTTP Delete,调 DELETE https://api.moonshot.cn/v1/files/{file_id} 删掉。仓库满了,新文件传不上去,整条产线就得停摆,这种故障还特别隐蔽,等发现的时候已经积压了一堆。
批量跑的时候也别贪。Notion 里同时把十几个条目设成「开始」,调用太密容易撞限频,建议一批 3 到 5 个,跑完再下一批。
边界与延展,这些场景直接搬
几个交付里常被问到的边界。
Notion 免费版单文件限 5MB,大 PDF 传不进去怎么办。把文件放 Google Drive,Make 里换成从 Drive 下载,产线其余部分一概不动,链路是解耦的,换哪一段都不伤全局。
英文文档行不行。实测一份英文的特斯拉研报,出来的中文观点总结准确度完全够用,长文本理解这块 Kimi 不怵英文。
只想借文件接口行不行。行。Kimi 抽文本、别的模型做分析,两个接口本来就是独立的,混搭完全允许,长文本能力跟对话能力可以分开采购。
这套链路稍微改改提示词,就是合同审查的初筛、论文速读、竞品分析、研报速览。凡是「大量 PDF 等着被读一遍」的场景,都是它的主场。老雷给大家提个醒,别把产线产出当终稿直接往上报,模型总结也有丢重点的时候,它筛出来的十个观点是「值得精读的线索」,不是结论本身。
顺手给一条验收标准,交付的时候照着核对。状态字段翻了没有,翻了说明全链路走通。观点条数齐不齐,缺了说明文本抽取半路打折。摘要开头结尾连不连贯,断了多半是清洗那步误伤过度。三处都对,这条产线才算能签字。
阅读的瓶颈从来不是读速,是筛选。让模型先把不值得精读的部分筛掉,人的时间才花在值得读的那几页上。
回到开头那个下午。五份 PDF 还是五份 PDF,只是现在十分钟就能知道哪三份值得精读、哪两份扫一眼摘要就够。工具链就摆在这里,API Key 申请加产线搭建,一个下午能收工,之后每个「下午四点」都能轻松一点。