老雷AI实验室
万字长文别一口气生成,先大纲后章节的 Make 流水线
给模型下一条指令,让它一口气写一万字,这种活儿多数人都试过。前两千字像模像样,中间开始车轱辘话来回说,写到后半段它自己都忘了结构,编号从第七章直接蹦到第十二章。。。
你要是也收过这种稿子,问题不在提示词,在路线。
一次生成万字,这条路本身就走不通。
拆成两次反而稳。先让模型只干一件事,出结构化大纲。再让自动化工具拿着大纲,一章一章地喂给模型扩写,最后拼装成篇。每次生成只盯着三千字,模型的注意力是够用的,质量自然就稳了。
这条流水线我在 Make 加 OpenRouter 上完整跑过,七个章节合计约一万五千字,全程两三分钟跑完,出来的 Markdown 编号齐整、层级清楚,基本不用再手动排版。为什么选 Make,因为这类「触发、检索、循环、回写」的胶水活儿它全是现成模块,你一行代码不用写。为什么选 OpenRouter,后面讲到模型路由那节你会明白。每个环节的配置、参数和坑,这篇全拆开给你。
先想清楚拿什么喂模型
动笔搭流程之前,先定内容从哪来。四条路线,成本和深度差得很远。
最省事的是让模型吃自己的知识库,给个主题直接生成。覆盖面广,通识类主题够用,代价是深度一般,偶尔还会一本正经地胡说。这篇讲的就是这条路线,后面三条都是在它基础上加料。
想扎实一点,就接搜索引擎。Google、Bing 的检索结果先抓回来,清洗完再投喂给模型,内容的详实度上一个台阶,只是成色跟着搜索质量走,搜到什么吃什么。
再往深走是拿书喂。把 PDF 书籍当知识库,生成的东西接近一份高质量的读书笔记,覆盖面窄但准,适合定向深挖某个领域。
最后一条是检索科研论文的预印本库来写报告,专业度拉满,做行业综述的时候特别好用。
四条路线没有高下之分,先问自己要什么。做批量的常规稿,第一条够用。要做企业白皮书这种要过审的东西,老雷的建议是老老实实走搜索或者书籍路线,让模型裸想出来的内容,审稿人一眼就能看出底子虚。
全局就一条线,五个模块
流水线不长,画出来是一条直线。
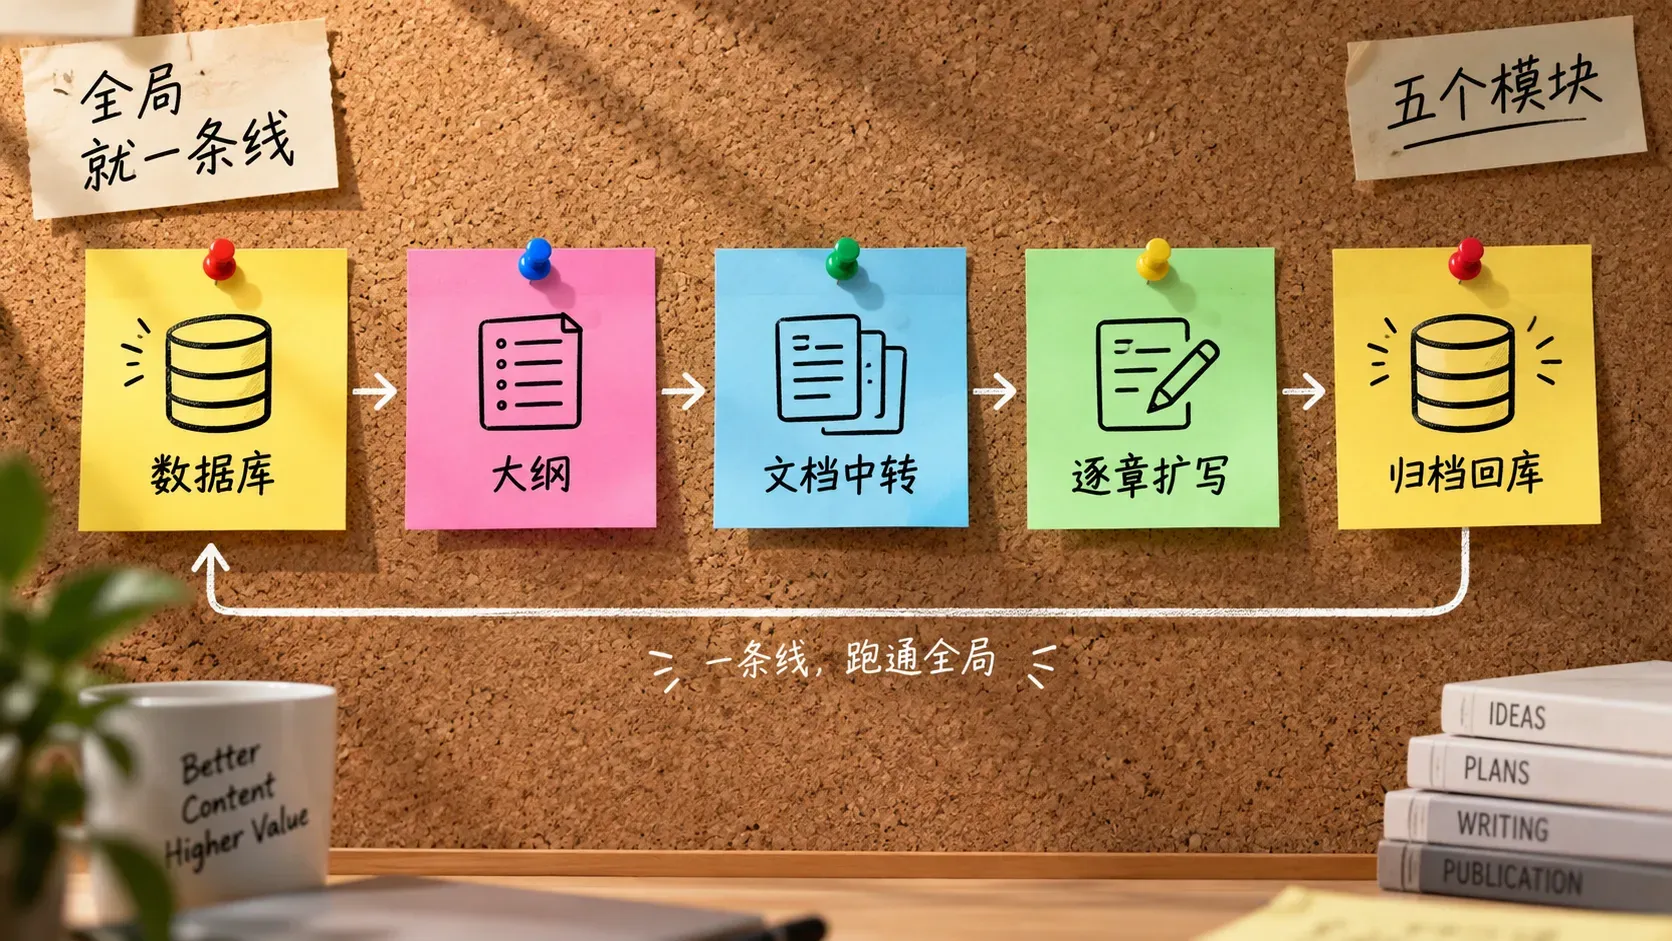
Notion 存主题并触发,模型生成大纲,Google Docs 当中转站,Iterator 逐章扩写,最后整体回写 Notion。逐个说。
先在 Notion 建一个长文库,数据库三个字段就够。标题用自带的,状态设成单选,「开始」触发流水线,「完成」表示已生成,再加一个文本字段存主题。用的时候在主题里填一句「ChatGPT 提示词的使用技巧」,状态拨到开始,Make 那边自动检索处理,跑完自动标完成,批量任务做到哪一篇,数据库里一目了然。
这里有个几乎人人会撞的坑。新建的 Notion 页面,Make 里经常搜不到。别急着怀疑自己配错了,去 Connections 里把 Notion 连接重新授权一遍,勾选新页面的访问权限就好。老雷提一句,这个动作没什么技术含量,但基本每新建一个页面都得来一次,忘一次卡一次,第一次撞上的人多半会在这白耗半小时。
场景建好后,第一个模块是 Notion 的 Search Database,选中长文库,过滤器设成状态文本等于「开始」,跑一次测试,确认能拿到目标条目。这个设计的妙处在于,你往库里扔十个主题,状态全拨到开始,流水线会一篇一篇消化掉,你该干嘛干嘛去。
第二个模块生成大纲。用 OpenAI 的对话补全就行,也可以直接换 OpenRouter 的模型。提示词里把角色定成大纲生成助手,要求输出严格 JSON,一层是文章标题,一层是章节数组,每个章节带编号、标题、内容描述三个字段,章节数量按主题复杂度自动定,每章的大纲描述写够五百字,章节之间内容不重复、区分度拉开,末尾再加一条硬约束,不得杜撰,符合事实与逻辑。
提示词里一定要手写一份 JSON 结构示例。这件事再强调都不为过。不给示例,模型每次返回的字段名都可能变样,后面的解析模块直接瘫掉,整条流水线停在半路。高级设置里再把输出格式选成 JSON,双保险。
大纲出来先过一道 Parse JSON,把标题和各章节信息拆开,接着用 Google Docs 的建文档模块,在预先建好的「长文」文件夹里按文章标题创建文档。Docs 在这条线里就是个中转站,每一章生成完先追加进去,全部写完再一次性同步回 Notion。为什么中间要垫一层 Docs 而不是直接写 Notion,因为章节是分批到达的,Docs 追加段落是天然适合流式写入的容器,攒齐了再走一遍整存整取,账目干净。
Iterator 加一个位置参数,编号不再乱
接下来是整条流水线的心脏。
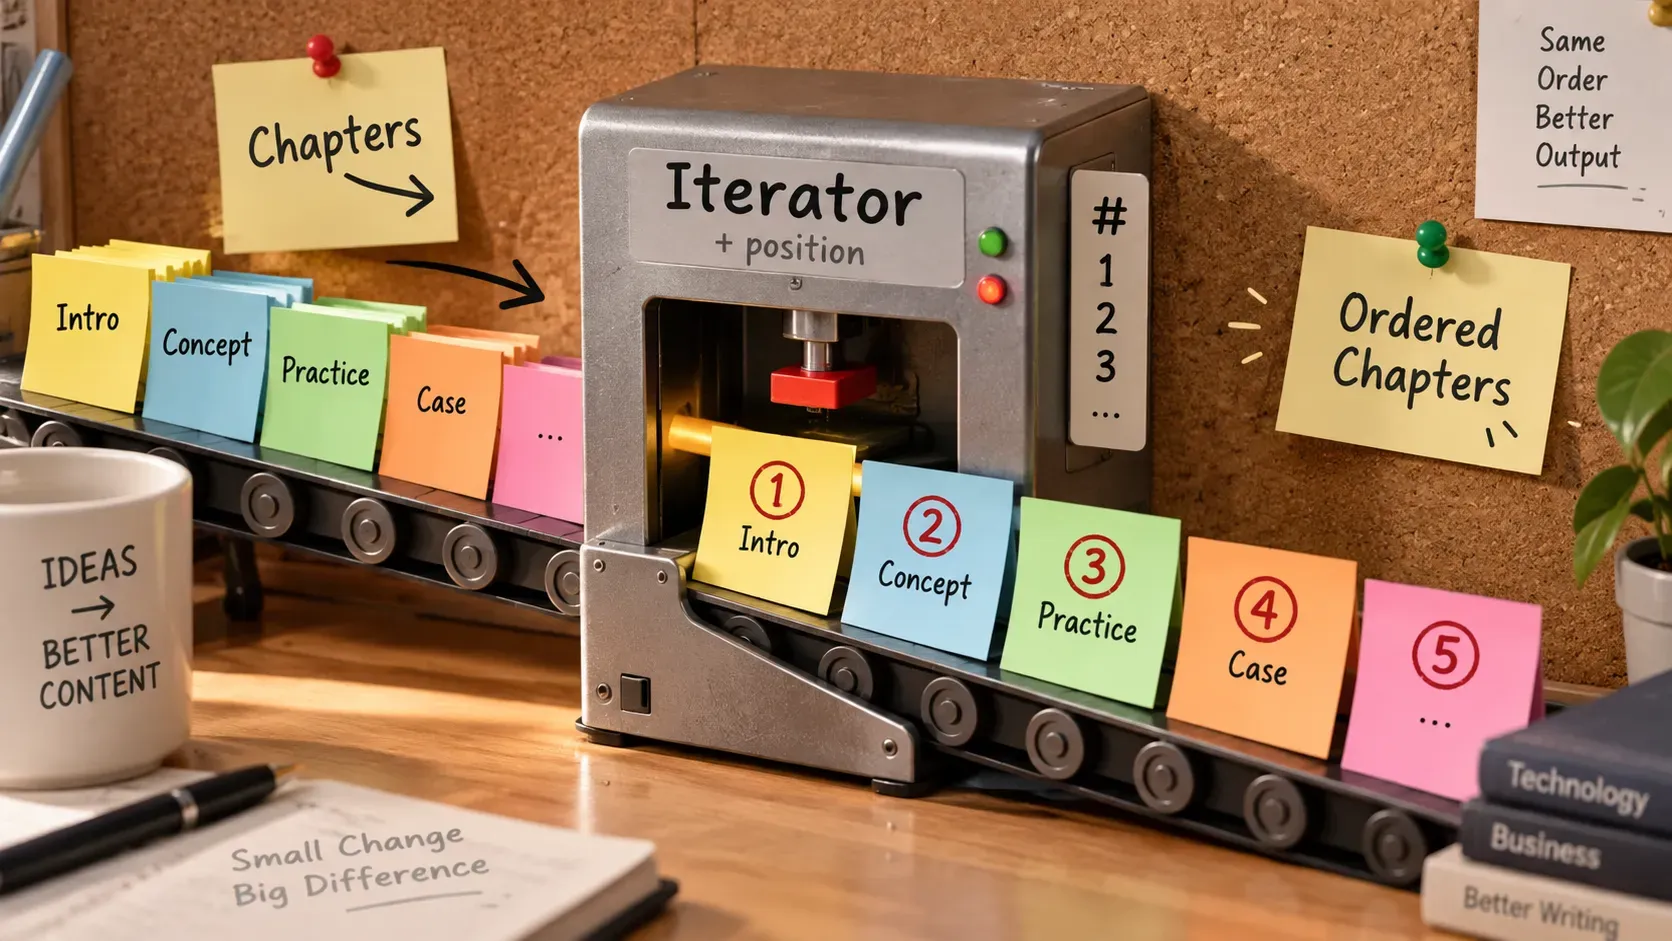
加一个 Router 路由器,上分支接 Iterator,下分支接保存模块。Iterator 选大纲解析出来的 chapters 数组,它会把六七个章节拆开,逐个发给下一个模块,相当于每个章节独立走一遍生成流程。
Iterator 后面接 HTTP 模块,请求打到 OpenRouter 的对话接口 chat/completions,POST 方法,Content-Type 用 application/json,鉴权头带上 Bearer 加你的 Key。System 提示词定三件事,每章三千字左右、独立成章,直接输出正文、不带开场白和结束语,内容符合逻辑、不得编造。请求体里把大纲解析出的章节标题和内容描述塞进去,模型就知道自己这轮该扩写哪一段。
真正的技巧藏在一个叫 Bundle Order Position 的变量里。它是 Iterator 自带的位置编号,第一次遍历是 1,第二次是 2,顺着排下去。在提示词里写上一句,需要生成第 {{Bundle Order Position}} 章的正文,模型就会把编号自动排对,正文里 6.1、6.2、6.3 这样的小节号全部有序,你不用再逐章人工校对。
编号是流水线算出来的,不是模型猜出来的。凡是要序号的地方,都优先让工具给。
至于为什么走 OpenRouter 而不是绑死某一家,它的价值在一个接口后面挂着几十种模型,Claude、GPT-4o、Gemini、Llama 都在,改一个模型名就完成切换,后面验收那节会讲怎么用这个特性省钱。
少了 Router,这条线会自己炸
Router 不是摆设,它决定哪些模块跟着 Iterator 一起遍历。
不加路由器会怎样呢,Iterator 后面的所有模块都跟着跑七遍。取 Docs 全文执行七次,写回 Notion 也执行七次,而且是滚雪球式的重复。第一遍存一章,第二遍存两章,第三遍存三章,七遍跑完,Notion 里躺着十几万字的高度重复内容,删起来都想哭。
这个坑属于那种「不踩不知道,一踩记忆力终生」的类型,逻辑上谁都觉得理所当然,真搭的时候就是会忘。老雷给大家提个醒,搭完先小规模试,章节数临时改成两个,确认分支行为对了再放大批量,别一上来就让它跑七章。
正确姿势是拿 Router 分成两条支线。上分支 Iterator 加 HTTP 生成加写入 Docs,老老实实遍历七次。下分支三个模块,先把 Notion 状态从开始改成完成,再取 Docs 的完整文档内容,最后整体追加进 Notion 知识库,只执行一次。路由器里把上分支的顺序排在前面,确保章节全部写完,下分支再去搬运成品。
一句话记住这个结构,遍历的归遍历,搬运的归搬运,两边不能混。
交付前过一遍验收清单
流程能跑和能交付是两回事,几条硬标准给你。
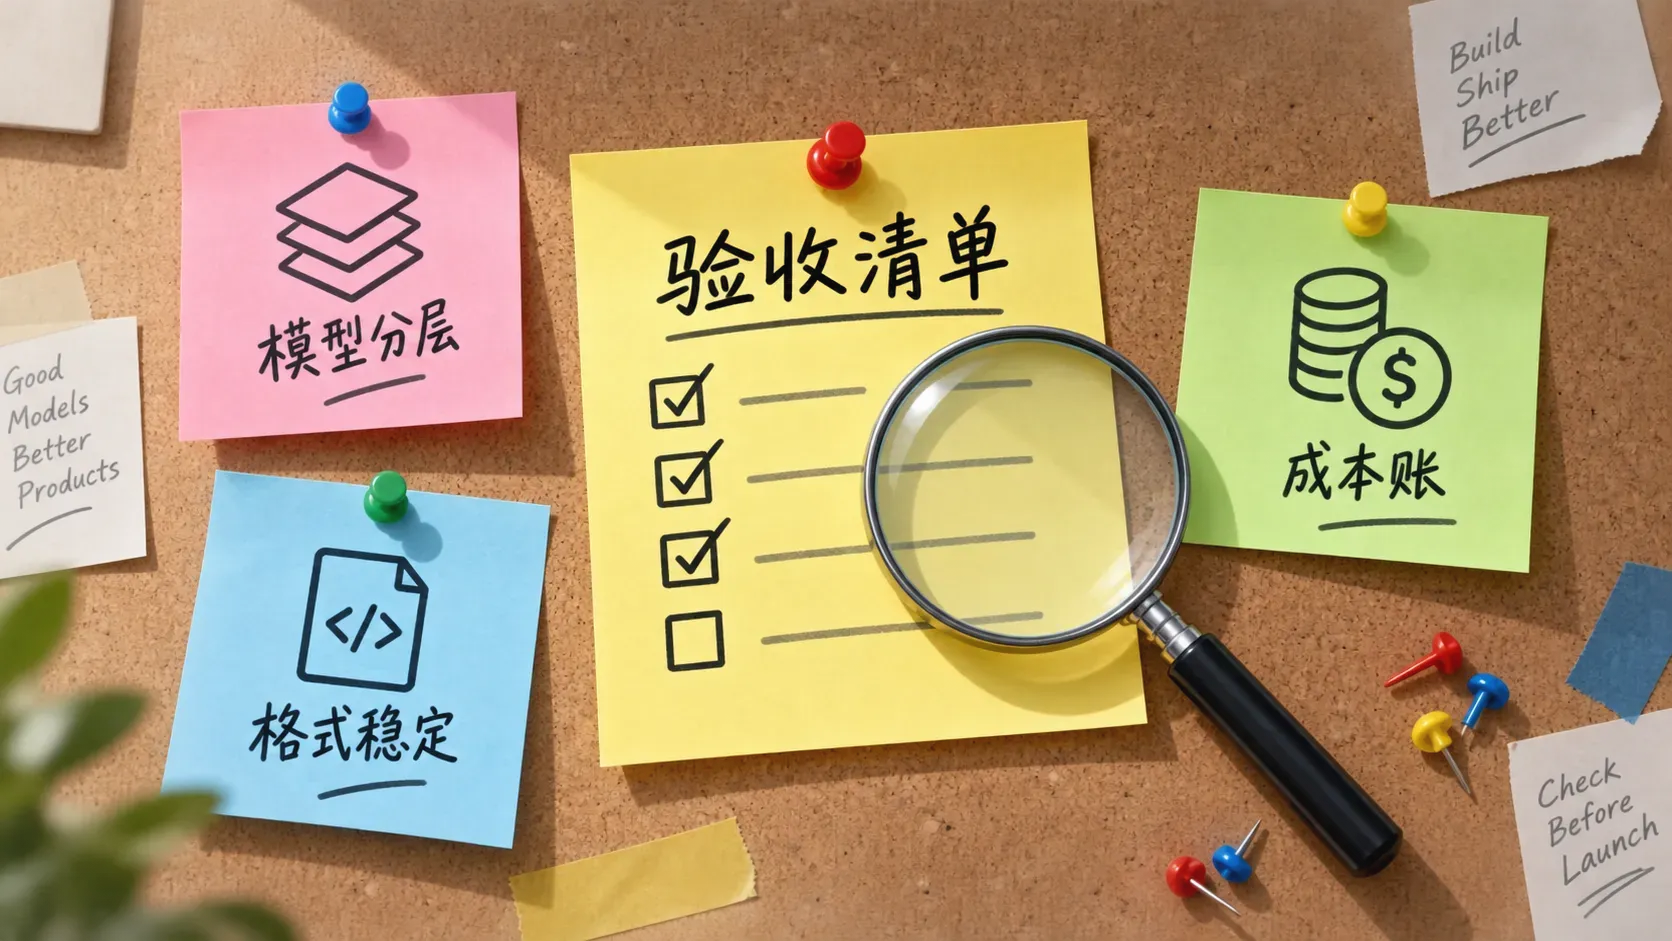
模型怎么分钱。OpenRouter 上的免费模型干粗活没问题,提取网页正文、做格式转换这类高消耗低难度的活儿,全交给它们,成本直接归零。写长文正文还是得 GPT-4o 或 Claude 这个级别才压得住。省钱的分法是大纲用强模型,一次才几分钱,章节扩写换性价比款,这一步才是 token 消耗的大头。花销不用靠猜,OpenRouter 的 Activity 页面里每个模型的消费记录和剩余额度都摆在明面上,跑几篇就能算出单篇成本。
JSON 又飘了怎么办。回到大纲那一步,示例给全,明确写上不得改变结构,高级设置强制 JSON 输出,三件套齐了基本就稳了。
想出更长的稿子,有两个旋钮可以拧。章节数往上加,或者把每章三千字提到五千,三五万字也出得来,token 账单跟着涨,自己权衡。
实测的基线数据放这儿,七个章节约一万五千字,全程两三分钟,Markdown 格式规整,层级标题、引言、概念定义都在,拿来当初稿改,比从零写省的不是一星半点。
流水线接管的是扩写,人要守住的是大纲。框架对不对,比句子漂不漂亮值钱得多。
工具会越来越便宜,判断力不会。把「想清楚写什么」这一步留在自己手里,剩下的交给流水线跑,这才是内容自动化该有的样子。