老雷AI实验室
千字新闻拧成128字推文,三轮压缩比一次摘要强在哪
先说一条实测出来的账。我们自己运营推特账号期间对比过,同样的事件、同样的发布节奏,压到 128 字的高密度推文,互动率比长推文高出三倍以上。短内容平台上注意力就是这么分配的,字越少,每个字越值钱。
值钱归值钱,产出它的过程特别熬人。每天盯着订阅源筛新闻,点开长文读完,压成一条短推,再找一张配图,手动跑一套下来个把小时就没了,质量还时好时坏。热点更不等人,你压推文的功夫,话题已经凉了一半,配图再耗半小时,发出去的时机就全错了。
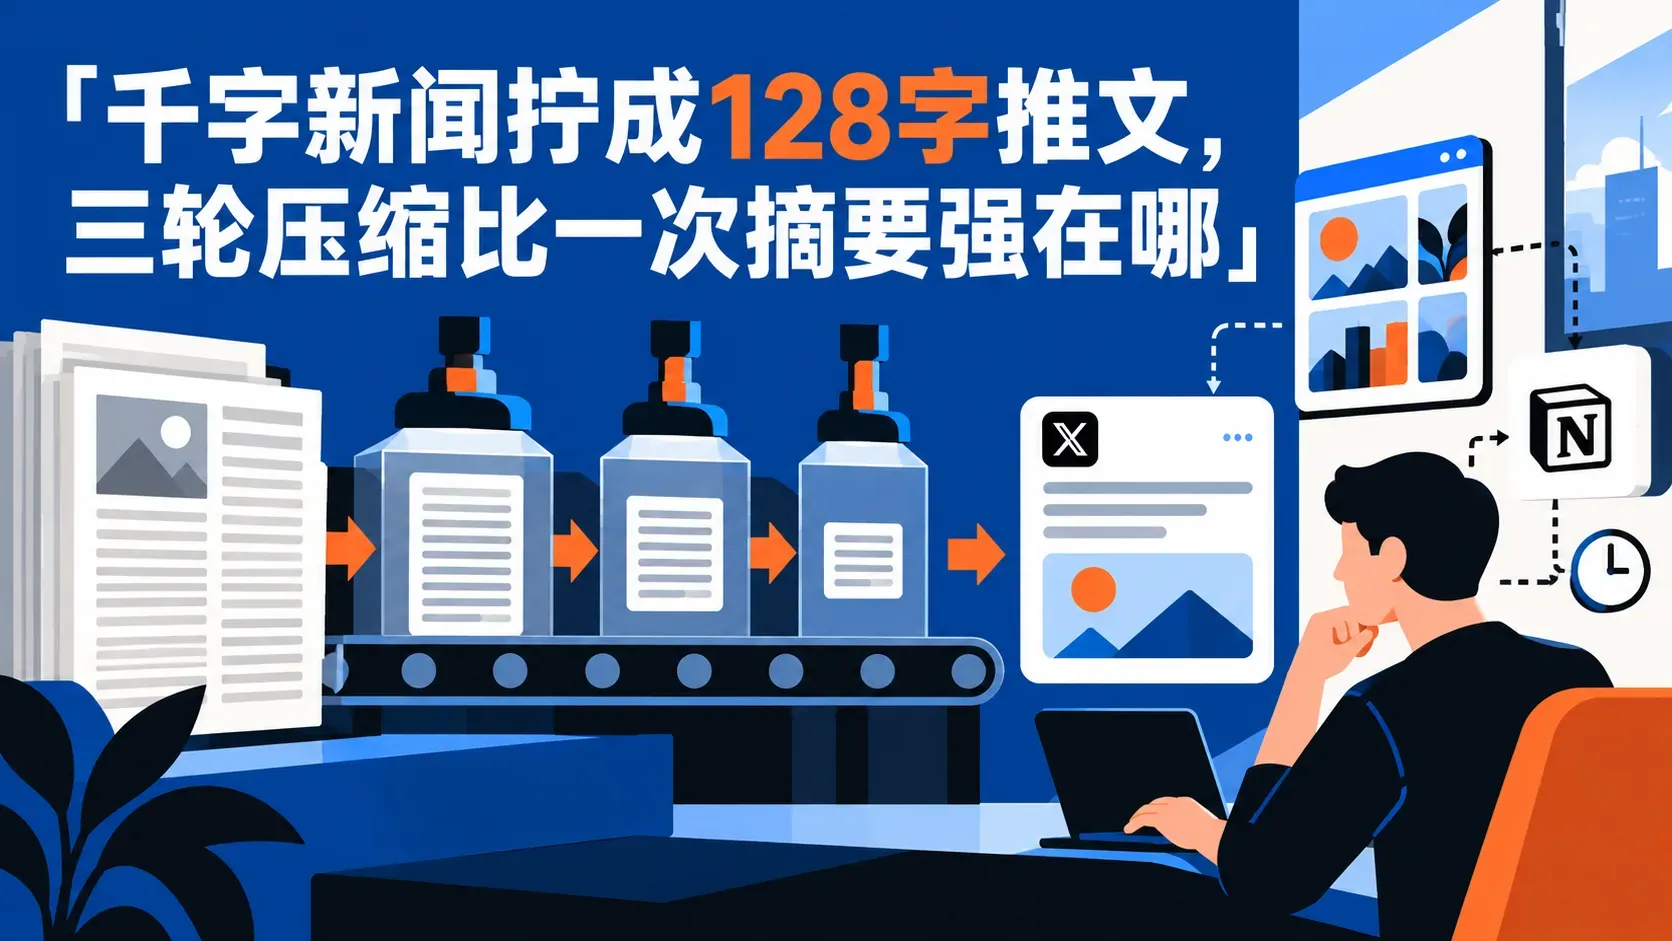
后来我们把整条链搬进了 Make,RSS 进,带图的推文出,人只管收尾扫一眼。整条线的走法是,Notion 里把任务状态一点,工作流从 RSS 拉新闻,Jina Reader 抓全文,切段喂给大模型做三轮压缩,再按推文关键词搜配图,结果连同关键词一起存回 Notion。下面按交付顺序把每一站拆开讲。
摘要是压薄,浓缩是压实
这条产线的灵魂是一个我们叫它迭代总结法的东西,跟传统摘要的思路正好拧着。
传统摘要是丢信息换长度,模型挑自以为重要的留下,其余全砍,压得越狠丢得越多。迭代总结法反着来,字数锁死,信息往里堆,分三轮压完。
第一轮,提取文章核心信息,生成不超过 110 字的初始概要,顺手把关键实体圈出来,公司名、产品名、数字、时间点。第二轮,字数保持不变,往里新增三个关键实体,让模型把新旧信息融合再压缩,密度抬一档。第三轮继续叠实体,压到 128 字以内,每个词都得带信息,虚词连接词能删全删。有个细节要盯住,每一轮的字数都不能放开,一轮松口,模型立刻退回丢信息换长度的老路,前面的轮次就白压了。
拿实测过的一条成品感受一下。一篇讲 Figure 人形机器人的长文,三轮压完是这句,「Figure 突破博士动力空翻专利,推出高智能人形机器人,掌握咖啡拉花、分发、遛狗等多项技能,专注通用机器人及自研电机技术,预计年底实现商业应用」。一条里塞进了专利突破、产品发布、技能演示、商业化时间表四层事实,没有一个是过渡句。
这套玩法不挑平台,推特能用,抖音文案能用,任何在短篇幅里抢注意力的地方都能用,它压的是信息密度,不是某个平台的格式。
摘要删信息,浓缩堆密度,两个动作方向相反,别指望一个提示词顺便都做了。
喂进去的料,先要切得匀
整条线的入口是 Notion 的搜索模块,按创作状态字段筛任务。我们设了「开始有水印」和「开始无水印」两个状态,条件用 OR 连着,匹配到任何一个就往下走,后面的模块只管干活。这个设计让加不加图变成任务的一个字段,不用为两种姿势复制两条工作流。
压缩的前提是模型把长文吃透,这半条线的关键词是切段。
新闻从 RSS 进来,HTTP 模块直接调 Jina Reader,调用格式就是 Jina 的阅读域名加目标链接,记得把 Parse Response 打开,不然拿回来的是没法解析的原始返回。抓回来的内容偶尔会缺斤少两,中间加一道分类器判断,确认是完整正文再往下走,宁可在这一步多花一次调用,也别让半篇文混进压缩环节。
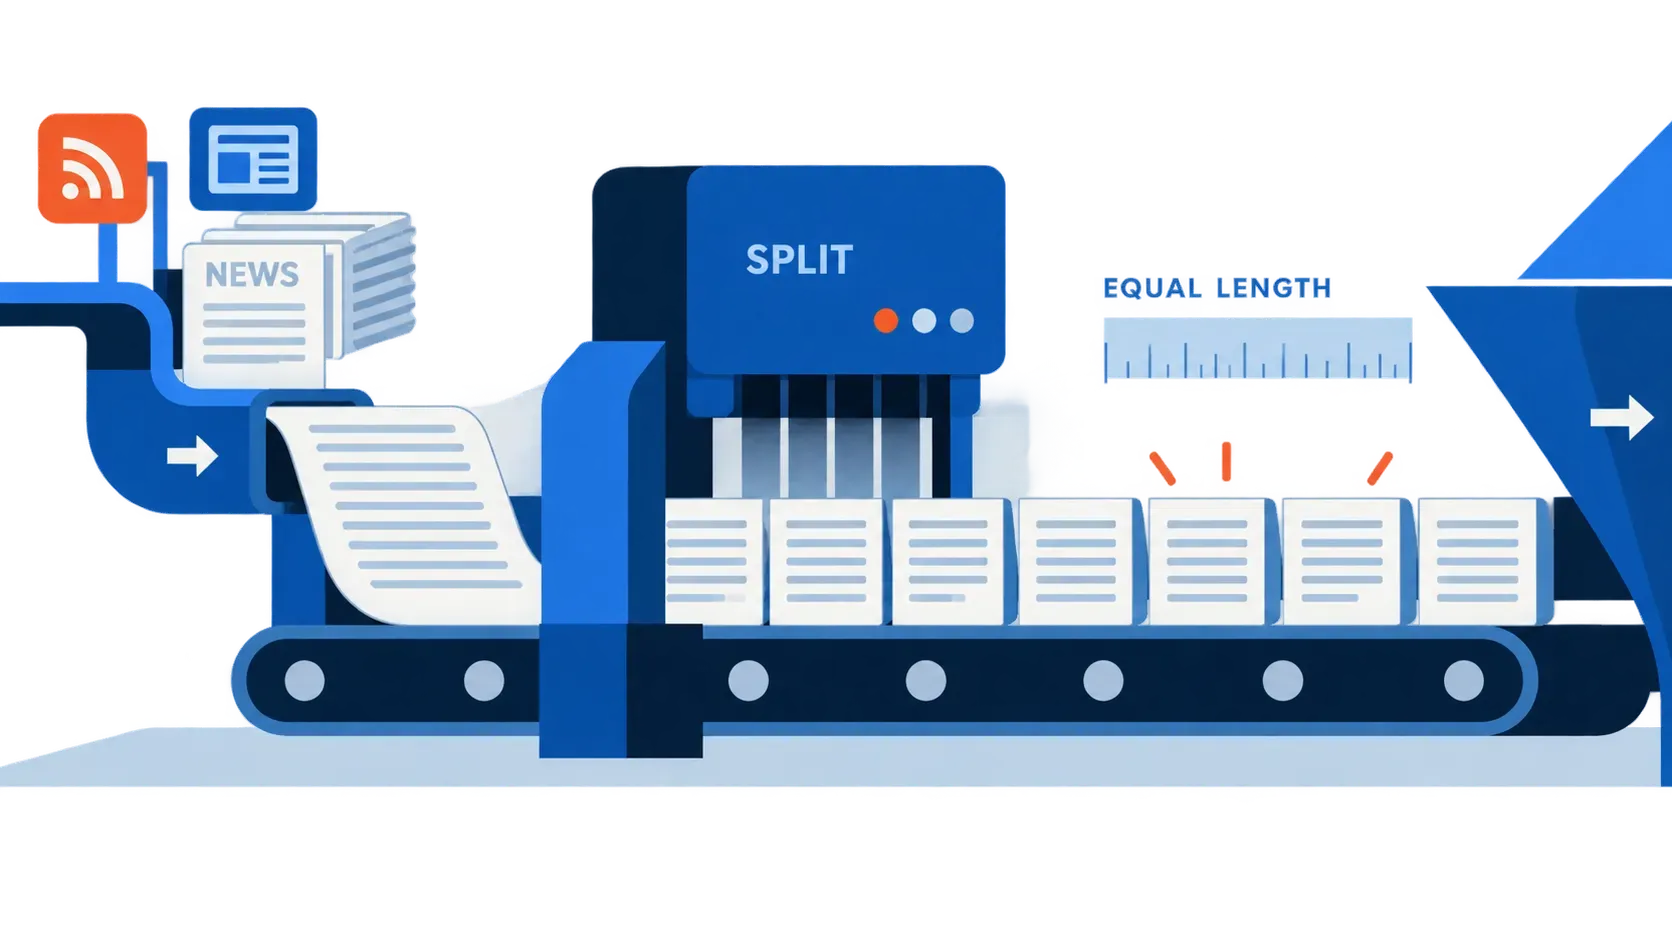
长文到手再过 Jina 的分段器,按 Token 数切块,我们定的是一段 2000,这里有个容易翻车的选项,创作式模式必须开,不开它只返回每段多少 Token,不返回内容,等于白切。段长这个参数也别拍脑袋,调大是省 Token,但每段得足够模型看清上下文,切太碎压缩就开始丢事实,2000 左右是实测下来比较稳的中位值。
想让这条线千字万字都能接,就把分段做成动态的。用一个变量模块算文章长度除以 2000 再向上取整,得数传给 Repeater,一段一段把全文铺满,来多大的文章都接得住。
有个权限坑提前交代。Notion 那边检索不到数据库,九成是没给 Make 的集成授权,尤其是授权之后新建的库,要手动到数据库设置里把 Make 集成加进去,这一步藏得深,第一次搭基本都会在这儿卡一把。
改写不注入新信息,就是把词换皮
压缩之外,这条线上还有一类活是改写,把一篇现成的文章变成另一个平台可用的版本。多数人让模型干这件事,拿回来的东西把措辞换了一遍,句式换了一遍,信息量一分没涨,一眼就是机器洗稿。
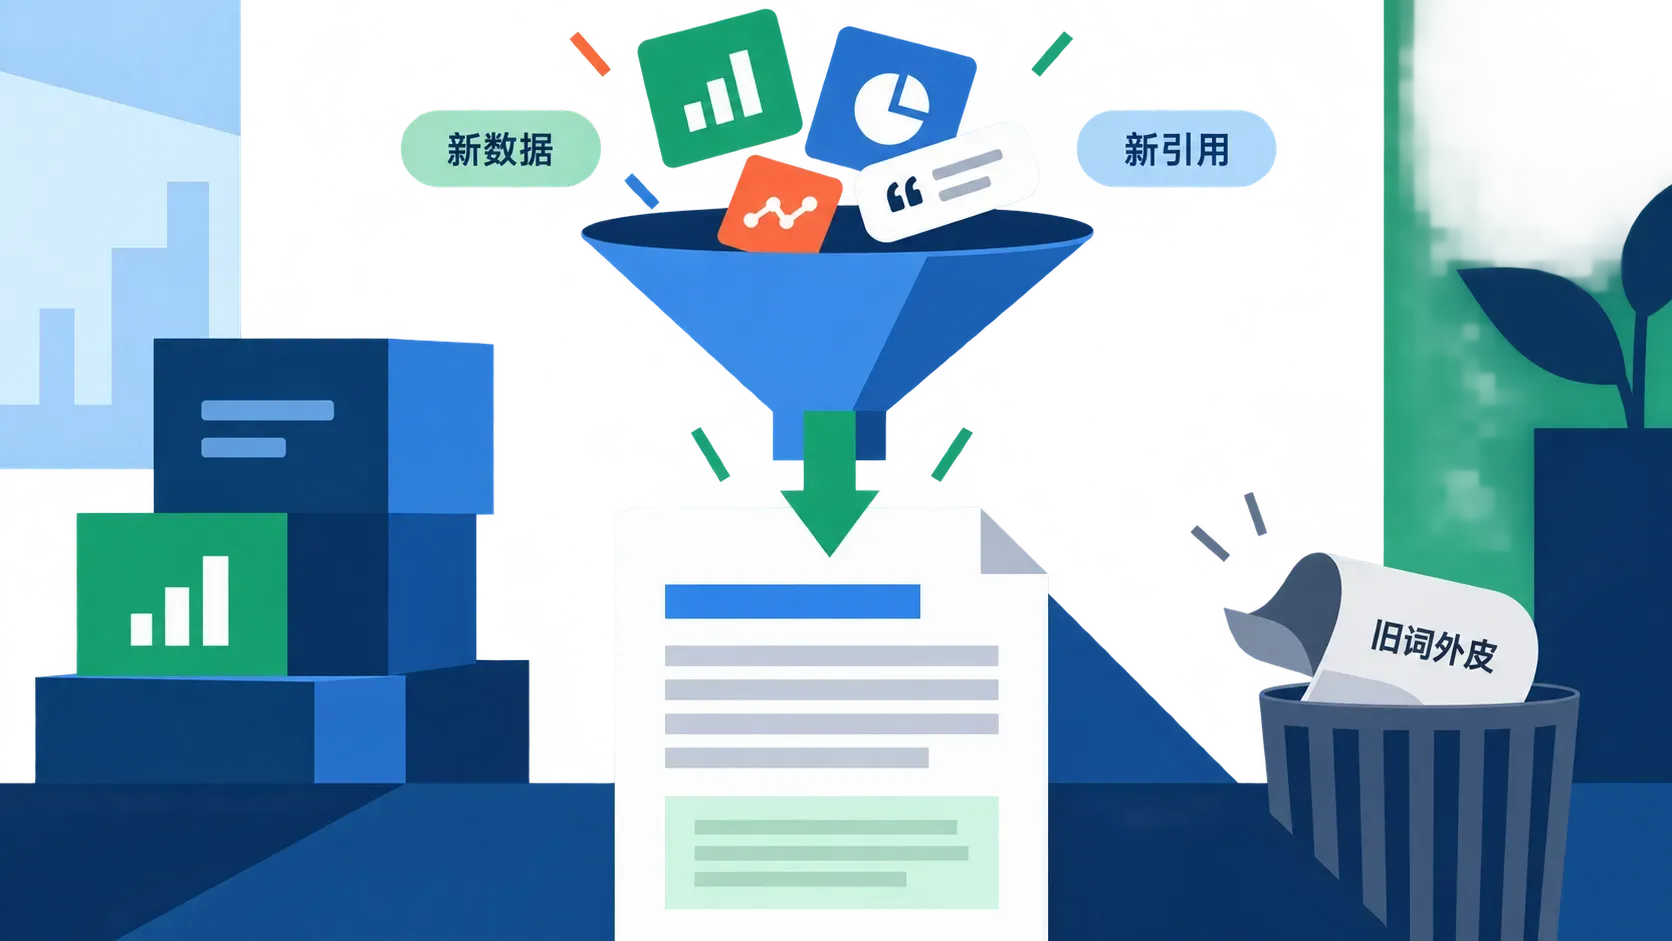
我们的做法是先注入再改写。借物理里熵增那个理,封闭系统只会越来越乱,想让它有序,就得从外面灌进新的东西。文章同理,改写前先用 Perplexity 抓一圈主题相关的背景信息、数据支撑和权威引用,把这些新鲜料注进去,改出来的东西才有增量。验收也简单,改写稿里要是找不出一条原文没有的信息,这次改写就是失败的,不管句子捋得多顺。
风格上分三个档位,按平台选。要人格化强的,用 Claude 3.7 走 IP 风格,技巧是把要求写实,指定用某某作者的写作风格,再在额外需求里写明把哪些经历和关键词揉进正文,Medium 这类吃个人故事的平台特别认这一套。情感生活类赛道图省事的,DeepSeek V3 直接指定现成风格就够用,莫言体、记者体这类模型都认得,成本还低。严肃领域求准的,还是 Claude 3.7,自己一句话定义风格,比如简洁犀利,信息准确度优先,风格特征点到为止。老雷的建议是别贪,一个账号锁定一个档位跑熟,别这周文艺下周犀利,把人设跑散了。
配图落库,收尾也有讲究
推文压好了,配图这条支线不复杂但有几个细节。
图源用 Apify 按推文关键词抓谷歌图片,关键词就是压缩时圈出来的实体,命中率高。抓回来的图经常带着底部的水印或者杂边,我们接了一道 Cloudinary 动态裁切,用正则从文章里匹配图片链接,上传到 Cloudinary 拿到新地址,再用 Replace 模块把链接里的固定部分替换成裁切参数,按宽高比把底部那一条裁掉。不在源头挑图而是统一过一道裁切,是因为图源根本不可控,与其挑到眼花,不如把工序固定下来,这步免费额度充足,性价比很高。
容错要写上,图片上传这类环节挂了很正常,Error Handler 兜住,图没了就保留纯文本继续跑,别让一张图卡死整条产线。
成品推文连同关键词存进 Notion,状态一改就进发布队列,推文和图自动发出去,从新闻发生到推文上线,人不碰一个字。这个库跑几个月下来就是你的素材资产,哪条互动好哪条扑了,翻一翻就有数,下一批选题从高互动的实体里挑,命中率高得多。
轮数不是越多越好
交付前被问最多的问题是,三轮之后还能不能再压,十轮是不是密度更高。
实测下来三轮是个均衡点。轮数往上加,密度确实还能抬,但可读性开始掉,实体堆太密读起来像绕口令,互动反而往下走。这条线是自动化的,轮数就是个参数,你可以自己拿五轮十轮各跑一批对比,找到自家账号的甜点位,别迷信任何一个固定值。要对比就把一次性摘要和三轮压缩放在一起跑同一篇文章,发出去各挂一周,互动数据会告诉你差距。
老雷给大家提个醒,验收这类产线别只看推文通不通顺。抽三条成品出来做三件事,数字数是不是真在限制以内,圈一遍实体看密度够不够,回原文对一遍关键事实有没有被压丢。三样都过,这条线才敢挂到正式账号上。
短内容这个趋势不用再论证了,推特在压,抖音在压,所有信息流都在把注意力切成更小的口子,谁能在更少的字里装下更多的信息,谁就抢到了那几秒钟。这条线搭起来不难,一个下午的活,换来的是每天省下一小时的手工浓缩。你今晚就可以从订阅源里挑一篇攒了很久没读的长文,把三个提示词轮着跑一遍,压出来的那条推文会替你判断这条线值不值得搭。