老雷AI实验室
三千五百个链接一次抓回来,Firecrawl 采集产线怎么搭
三千五百五十三个。
这是我把一个网站根地址丢进工作流之后,Map 端点几秒钟吐回来的链接数。整个站点的子页面,整整齐齐躺在一个数组里,等着被逐个处理。
做内容引流的人都懂这种饥渴。SEO 要喂养,博客要日更,手动找素材、翻译、去推广、排版、发布,一篇折腾半天,节奏永远追不上计划,断更两天,排名和心态一起掉。我们实测这条产线之后,账变成了另一个算法,配置一次,每天定时跑,三千多篇存量文章按天分批喂进来,每篇自动出一篇图文混排的博客文章,捎带一条小红书笔记。
爬的活交给 Firecrawl,串联交给 Make,中间三个大模型模块负责翻译、洗推广、顺格式。整条链路没有一个环节需要人守着。
这篇按交付视角拆,选型怎么定、三个端点怎么分工、链路每一段怎么配、三千多篇怎么分批不翻车,最后附一份上线前的自查清单。照着走,今晚就能跑通第一段。
选爬虫,先看你要什么
Firecrawl 和 Jina Reader 干的是同一类活,把网页转成大模型爱吃的干净 Markdown。怎么选,把三笔账摆在一起看就清楚了。
部署方式,Jina Reader 是纯在线服务,一个 API 调到黑;Firecrawl 开源,可以本地部署,也有在线版。额度,Jina 一个 key 给一百万次,量大管饱;Firecrawl 在线版每月五百页,个人跑采集基本够,真要大规模上就自部署开源版,没有页数限制。输出质量,这是分水岭,Jina 偏纯文本,Firecrawl 的 Markdown 保留原文的图片链接、表格、加粗,抓回来的东西是图文混排的。
老雷的判断标准就一条,你的下游要不要图。要图选 Firecrawl,省掉整个手动配图环节;海量纯文本处理选 Jina,一百万次的额度摆在那。两条产线也不互斥,文本类走 Jina 跑量,图文类走 Firecrawl 出精品,同一个 Make 场景里各占一条分支。
工具选型不看电影情节,看你产线的下游吃什么。
三个端点,各管一段
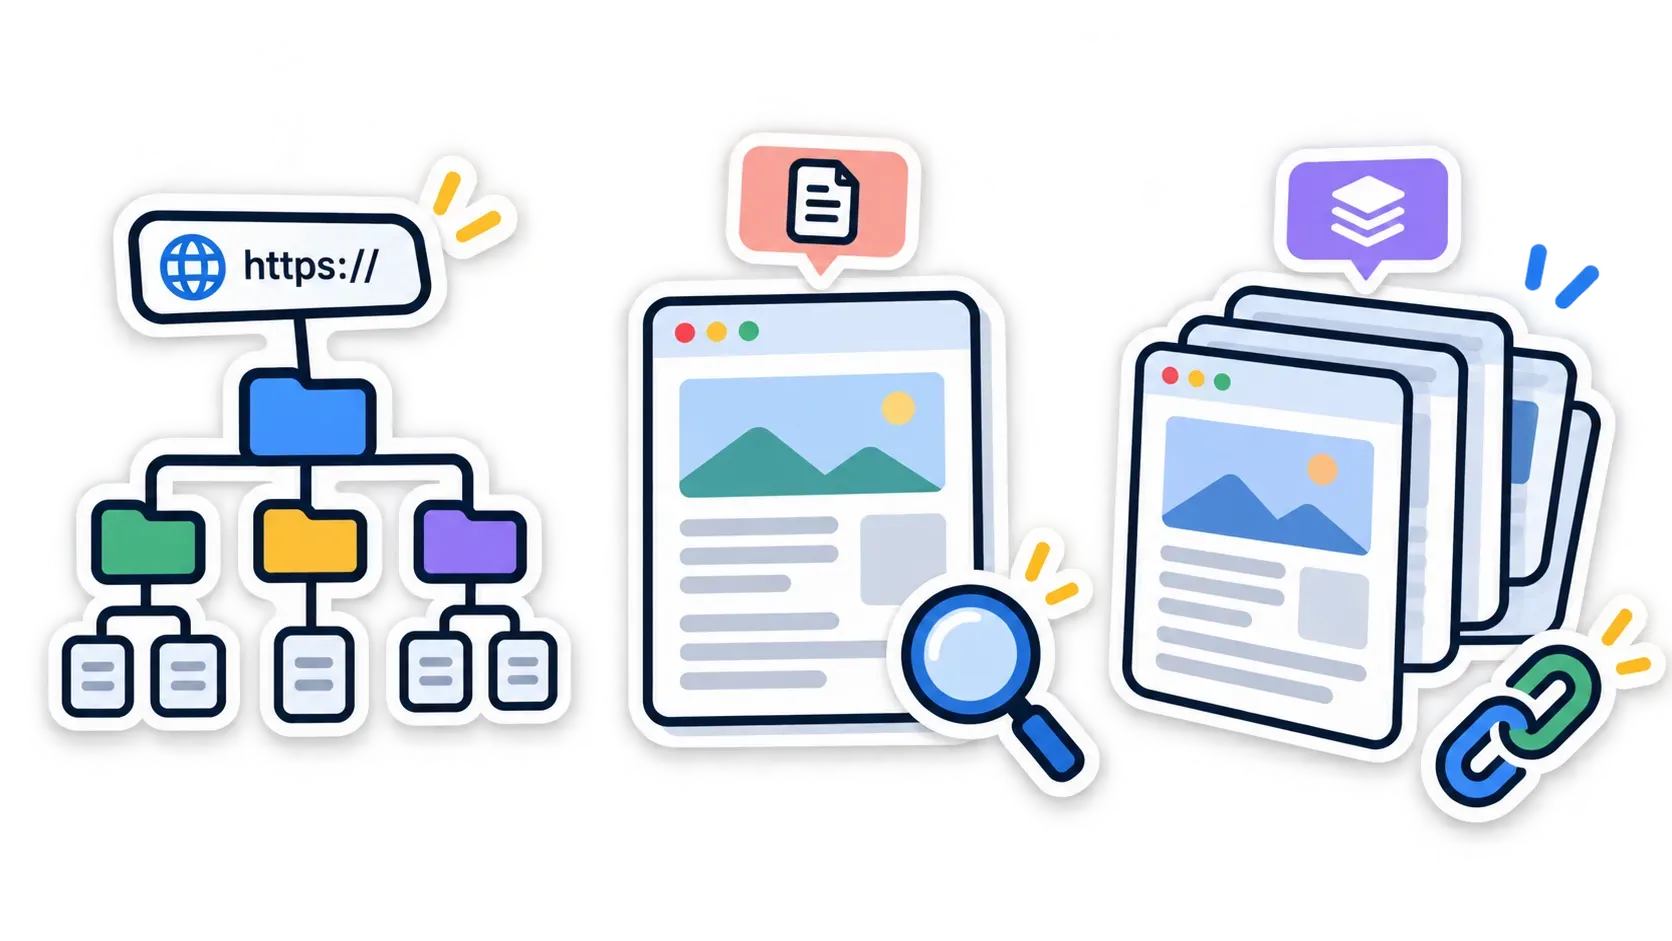
Firecrawl 就三个核心端点,各司其职,记一句话就够,Map 拿目录,Scrape 拿正文,Crawl 全都要。
Map 端点管链接发现。输入一个网站根地址,返回该站所有子页面的 URL 列表,速度快得离谱,开头那个三千五百五十三条就是它的实测成绩。还支持关键词过滤,请求体里带上搜索词,比如只收 URL 里带 RSS 的页面,三千多个链接当场缩成一个小集合,后面 Iterator 的压力小得多。
Scrape 端点管单页正文。给它一个具体页面地址,返回这页的 Markdown,图片链接、文本格式、表格结构原样保留。
Crawl 端点管整站。从指定地址开始递归遍历所有子页面,批量往回搬内容。整站归档的场景用它,日常按篇出的产线用前两个就够。
分工记熟了,排错也快。链接少了查 Map,正文缺了查 Scrape,配额莫名烧穿八成是有人误用了 Crawl。
多说一句图文混排值多少钱。纯文本采集的产线,出的稿子没有图,要么手动补,要么再接一条配图流水线,工时都补在这了。Firecrawl 把原文的图片链接原样带回来,翻译模块只要在提示词里交代一句保留图片,成稿出来就是图文混排的,直接能进发布队列。我们实测这一项省下的配图时间,比爬虫本身省的还多。
链路怎么串
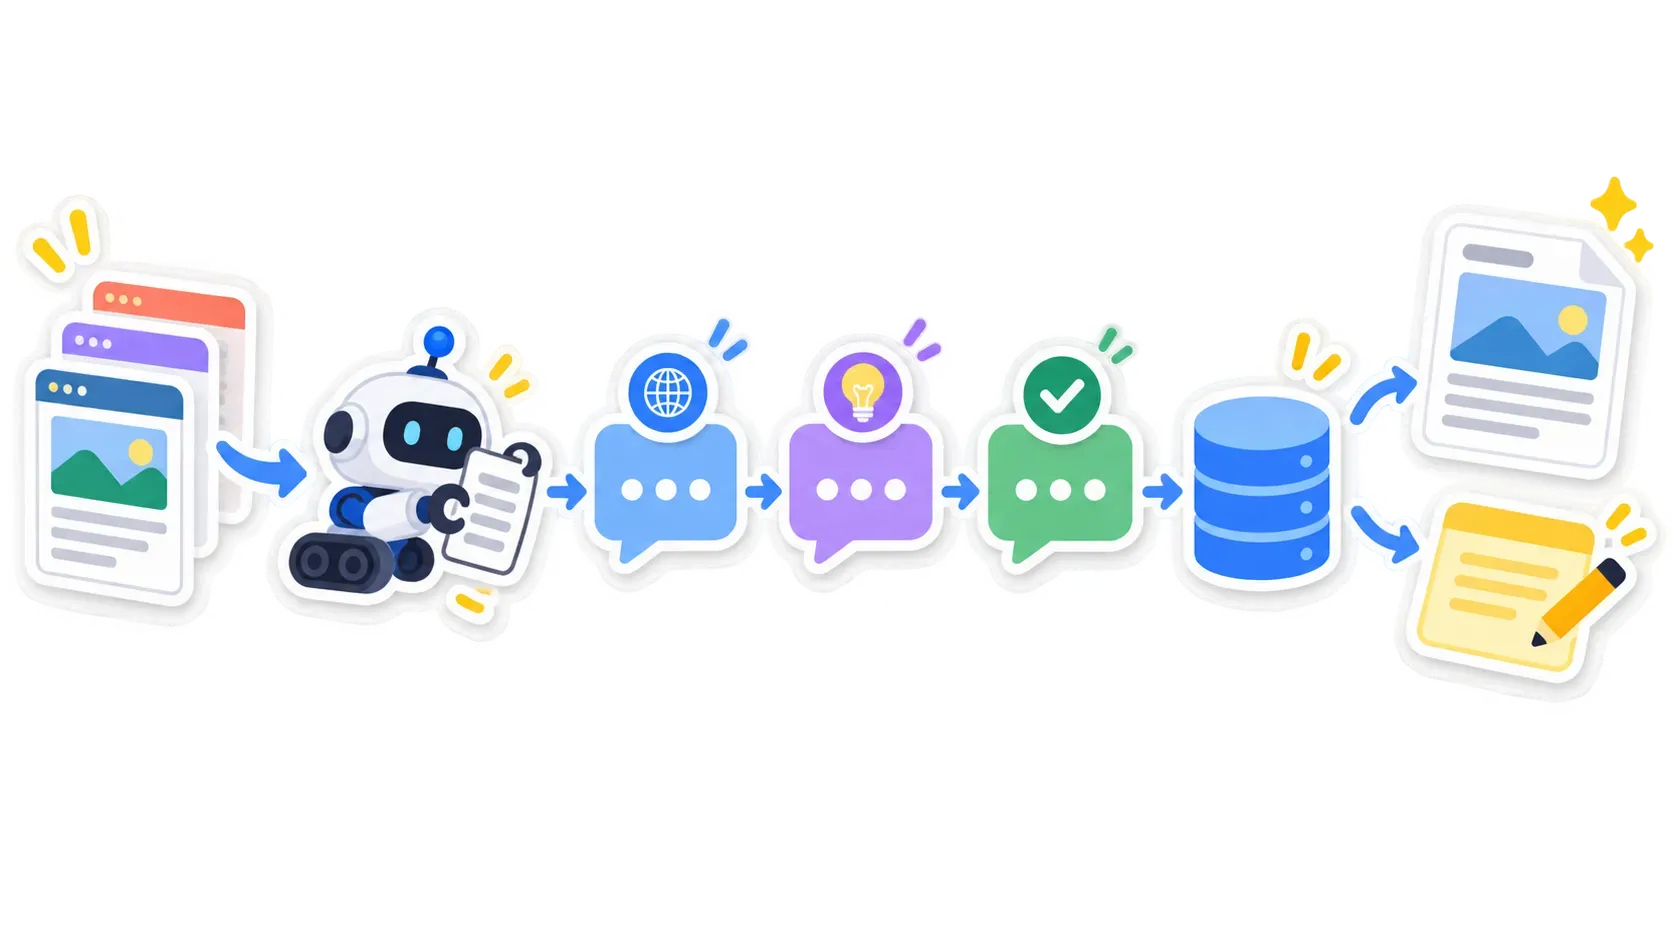
整套工作流分上下两段,中间靠 Notion 接力。
上半段管链接入库。Basic Trigger 里填目标站地址,HTTP 模块调 Map 端点拿到链接数组,Iterator 遍历器把数组拆成单条逐个发射,Notion 逐条建条目,库里四个字段够用,标题、采集状态、网址、小红书笔记。
这半段有三个容易翻车的细节。目标 URL 要填到父级目录那一级,想采某个站的博客区,就填到它的 /blog 这层,Map 会自动收下面的所有页面。HTTP 模块用 POST 发起,Header 里放 API 密钥和 Content-Type,Parse response 记得打开,不然下游映射不到数据,慢站再把 Timeout 从默认四十秒调到三百。Iterator 取数组要用 map() 函数提取 Value 字段,直接选数组经常拿不到东西,这是这条产线最隐蔽的一个坑。
去重逻辑放在 Notion 侧。每个 URL 入库前先跑一次 Search Objects 查重,返回的条目数等于零才创建新条目,采集状态标「开始」。没有这道闸,分批采集跑到第二天就会开始吃重复数据,配额白白烧在一模一样的页面上。查重这半步不能省,它管住的是产线的重复建设。
下半段管采集成稿。HTTP 调 Scrape 端点抓单页 Markdown,然后三个大模型模块接力。第一个模块翻译并去推广,系统提示词要求翻成中文的同时删掉原站推广、作者信息、站内链接,只留核心内容,Token 上限给 4096。这一步是整条产线的心脏,提示词里删什么留什么写得越具体,下游校对越轻松。
第二个模块从译稿里提炼小红书笔记,以 JSON 输出标题、三百到四百字正文和标签,Token 上限 1000,打开 JSON 解析。一篇正经的博客文章换一条轻量笔记,同样的素材吃两遍,两个渠道同时喂。
第三个模块做校对。删完推广内容之后,原文的编号、表格条目经常对不上数,比如原文写「以下五点」删掉一点只剩四点,这个模块负责理顺编号、优化段落结构、清掉冗余的格式符号,保证进 Notion 的是能直接看的稿子。
最后写回 Notion,状态改「已完成」,标题、正文、小红书笔记各归各位。跑一次,一篇博客加一条笔记同时落地。
三千篇别一次跑完
三千多条存量,一次性全跑是自杀式操作,API 配额瞬间见底,中途出一个错整批数据都得回来排查。解法是一个日期公式,让产线每天自己知道今天该搬哪一段。
拿今天减去一个固定起始日期,得到天数差,乘以每批数量,就是今天的起始位置,加上批量数就是结束位置。比如每批十条,第一天搬第零到十条,第二天搬第十到二十条,往后顺延。Iterator 的过滤条件里卡住 Bundle Order Position,大于等于起始值、小于结束值,再把场景定时设成每天固定时间,产线就自己转了。
算一笔账就明白这个设计的好。三千五百多篇按每天十篇,一年之内匀速搬完,配额曲线是平的,人的精力曲线也是平的,每天扫一眼当天那批的成稿质量就行。突然跑三千篇,出的错也是三千篇规模的。
这个公式还有个隐性好处,产线的日产出量是个常数,出了问题当天的影响面就是那一批,回滚和补跑都好办。
交付前过一遍这五项
收尾照例给清单,上线前逐项过。
第一项,LLM 模块报 400、提示消息里必须有 JSON 这个词,原因是提示词里没写 JSON 相关指示却选了 JSON 输出格式,不需要结构化输出就把格式改回 Text。
第二项,映射核对。跑一遍完整流程,逐个点开模块看 Input Bundle 和 Output Bundle 的实际数据,复制出来的模块要特别检查映射的源模块编号对不对。
第三项,JSON 请求体里多余的空格和特殊符号会让请求直接挂,Body 粘贴前先在编辑器里清一遍。
第四项,别指望百分之百命中率。有些站反爬很凶,Firecrawl 也啃不动,遇到就换目标站别硬磕,官方后续的 SmartCrawl 端点会结合 AI 处理复杂页面,可以盯一下。
第五项,超时设置。HTTP 模块默认四十秒超时,大站或者海外的站响应慢,调到三百,省得采到一半断掉,整条批次的日志还得重来一遍。
这五项全过,产线才算交付。老雷带项目这些年,自动化产线挂掉的原因十个里有八个是这几样,配置层面的低级伤,没有一个值得栽第二次。
老雷最后提醒一句,这类采集产线的合规边界要先想清楚,抓什么、怎么用、署名和版权问题,内部先立好规矩再放量。工具没有立场,用工具的人有。翻译改写类产线尤其注意,只采自己有授权、或者允许二次创作的来源,这条线踩一次就是事故。
这套「采集加洗稿」的架子,价值不在某一篇稿子,在于你从此拥有一个每天自动进料的素材库。引流是个慢功夫,产线保证的是你永远有明天的存货。今晚就能跑的第一步很简单,挑一个文章多的站点,把 Map 到 Notion 入库那半条链先通了,看那串链接哗哗进库的样子,剩下的明天再说。