老雷AI实验室
数据库之间老死不相往来,Make 加 ChatGPT 让 Notion 条目自己归位
Notion 用得越久,库建得越多,一个隐痛就越明显。教程库、项目库、读书笔记库、文章收藏库,每个库都整整齐齐,可它们之间像一座座孤岛。你想从「应用场景」这个角度横向检索一遍收藏,就得手动一条条打标签,打到手酸。
我第一次意识到这个问题,是想把收藏的 AI 工具按用途重新过一遍。三十多条记录,手动关联到十几个场景库里,一下午就搭进去了,而且我知道下个月新增的条目还得再来一遍。
这种活就不该人干。这篇拆一套我跑通的方案,用 Make 加 ChatGPT 实现 Notion 数据库的自动关联。你往知识库里新增一条内容,Make 每天定时扫描,ChatGPT 自动判断它属于哪个应用场景,直接把关联关系写进去。你要做的只剩偶尔抽查一下准确率,十秒钟滑一遍当天的新条目,看到挂错门的随手一改,改的过程本身也是给提示词攒调优素材。
这套方案的底层逻辑也不挑场景。把场景库换成人员库,新项目进来自动分配给对应的负责人;把场景库换成项目库,复盘记录写完自动挂到所属项目下面;把场景库换成时间线,新任务自动归入对应的月份。全都是同一个模式换皮,变的只是分类清单和被关联的库。
关联属性才是 Notion 的骨架
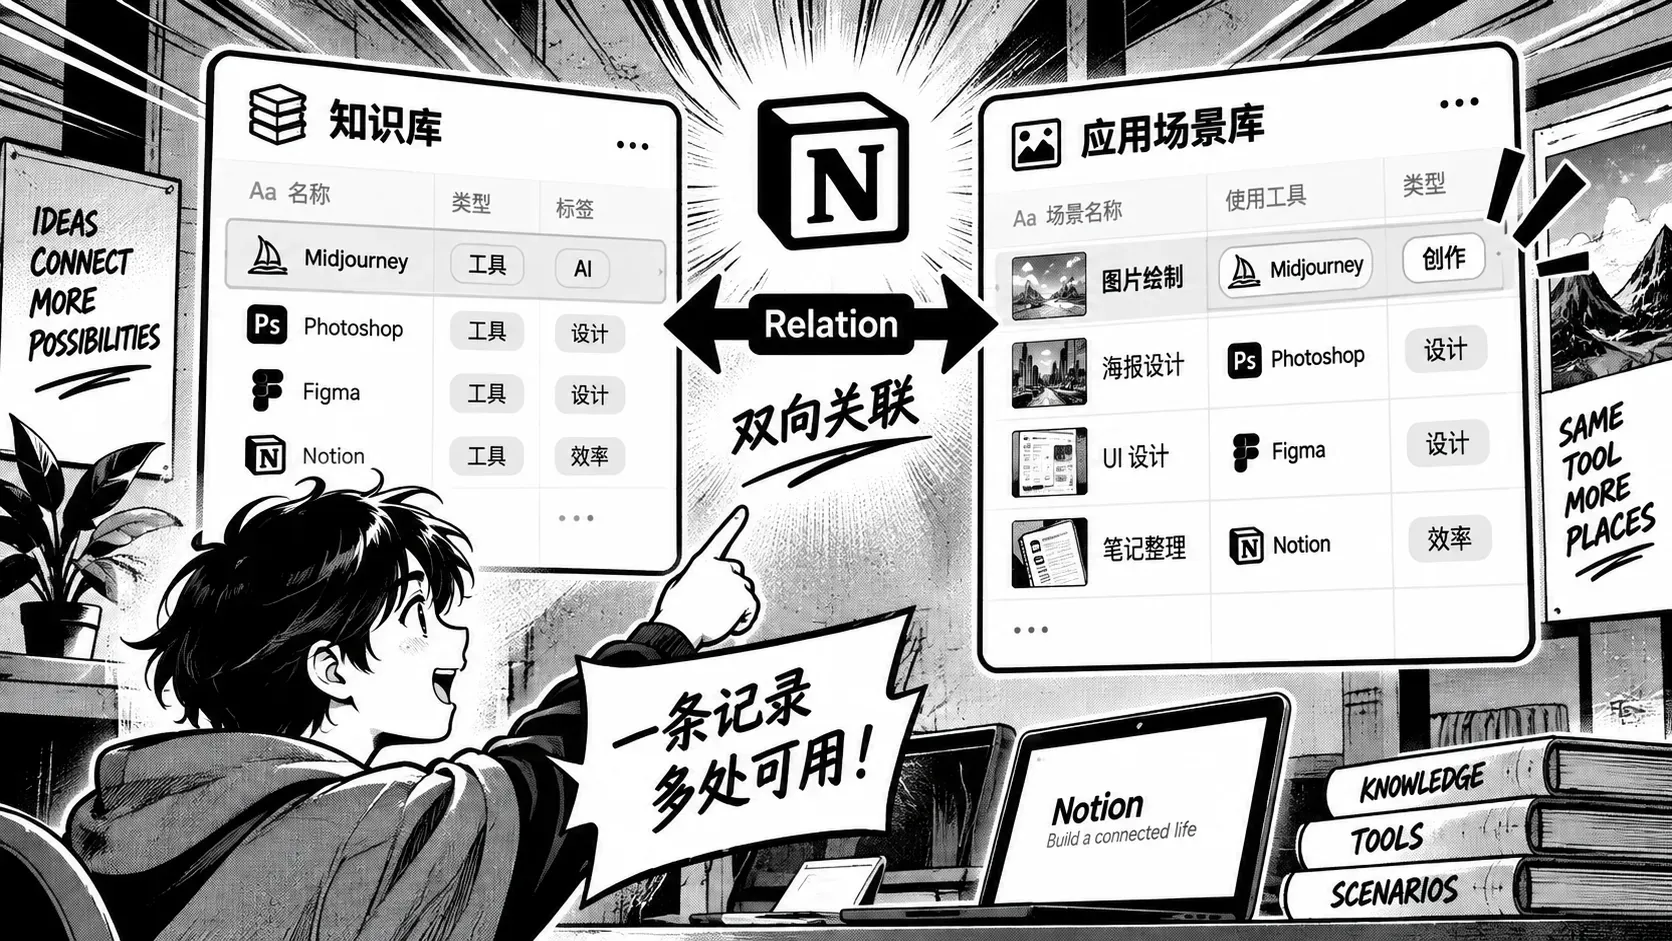
先补一个概念,Notion 数据库有一种特殊属性叫关联关系,英文是 Relation。它让一个库的条目直接链接到另一个库的条目,而且是双向的,你在 A 库的条目上挂了 B 库的条目,B 库那条的页面里会自动出现反向链接,两边都不用手动维护。
举个例子。你有一个 AI 知识库,收藏各种工具和教程,又有一个应用场景库,列着图片绘制、视频创作、文案写作这些场景。把知识库里的 Magnific AI 关联到场景库的「AI 图片绘制」,之后你点开这个场景,所有相关条目自动列队等你。检索的入口从「我记得收藏过什么」变成「我想看这个场景下都有什么」,这两种用法是两个段位。
有读者可能会问,单选多选标签不也能分类吗。差别在维度。标签只能在同一个数据库内部筛选,关联属性能跨数据库建立联系,让你从完全不同的维度审视同一批知识。库和库之间的墙,靠 Relation 这个属性拆掉。
老雷在这里提醒一句,方案设计前先想清楚你的分类维度,场景库一旦建好,后面所有自动关联都围绕它转,维度选歪了返工的是整套系统。
为什么必须自动化,账很好算
手动关联有两个痛点,一个累一个纠结。
累是工作量。知识库条目上了规模,每条都要手动选关联,纯体力活,而且这个活会随条目增长线性变重,永远做不完。纠结是判断成本,很多内容横跨多个场景,一条 AI 视频工具既算视频创作又算内容营销,手动选的时候来回来去犹豫,时间就这么漏掉了,犹豫完还常常漏选。
自动化的分工很清晰,规则你来定,判断交给模型,执行交给 Make。每天定时扫描新增条目,ChatGPT 判断最匹配的分类,直接写入关联关系。你从执行者退位成质检员,这个角色转换就是这套方案的全部价值。
还有一个隐藏收益值得单独说。手动关联的时代,你因为怕麻烦,分类只敢设五六个大类,维度被人力成本压扁了。自动化之后分类设到十六个也不心虚,分类颗粒度可以放心做细,检索的精度跟着上一个台阶。人力省下来是一方面,敢把体系建细才是更大的收益。
第一步拿 ID,第二步抄进提示词
整个方案的核心资产是 ID。Notion 里每个条目都有唯一的 ID,Make 靠它精确定位,关联写入说到底就是把两个 ID 绑在一起,一个代表新进的条目,一个代表目标分类。名称可以重复,ID 永远不会。
先建一个辅助场景拿 ID。Make 里加 Notion 模块,选 Search Database Items,连接到你的应用场景库,最大条目数设 20,保证覆盖所有分类。运行一次,每个条目都会输出名称和对应的 Database Item ID。比如「AI 图片绘制」是一串 eb685f89 开头的 UUID,十六个分类就有十六串。这个辅助场景用完可以留着,后面每次新增分类,重跑一遍就能拿到新 ID。
十六串 ID 手动抄容易出错,抄错一位整个分类就挂错了门,而且这种错误藏得很深,跑起来不报错,只是条目静默消失在错误的分类里。用一个取巧的办法把抄写环节直接砍掉。Airtable 建一个三列的表,名称一列,ID 一列,再加一个公式列把名称和 ID 拼接起来。Make 里把 Notion 模块的输出接到 Airtable 模块自动写入,跑一次就得到完整的分类汇总表,直接复制粘贴进下一步的提示词,一个 ID 都不会错。
主场景三步走,监听判断写入
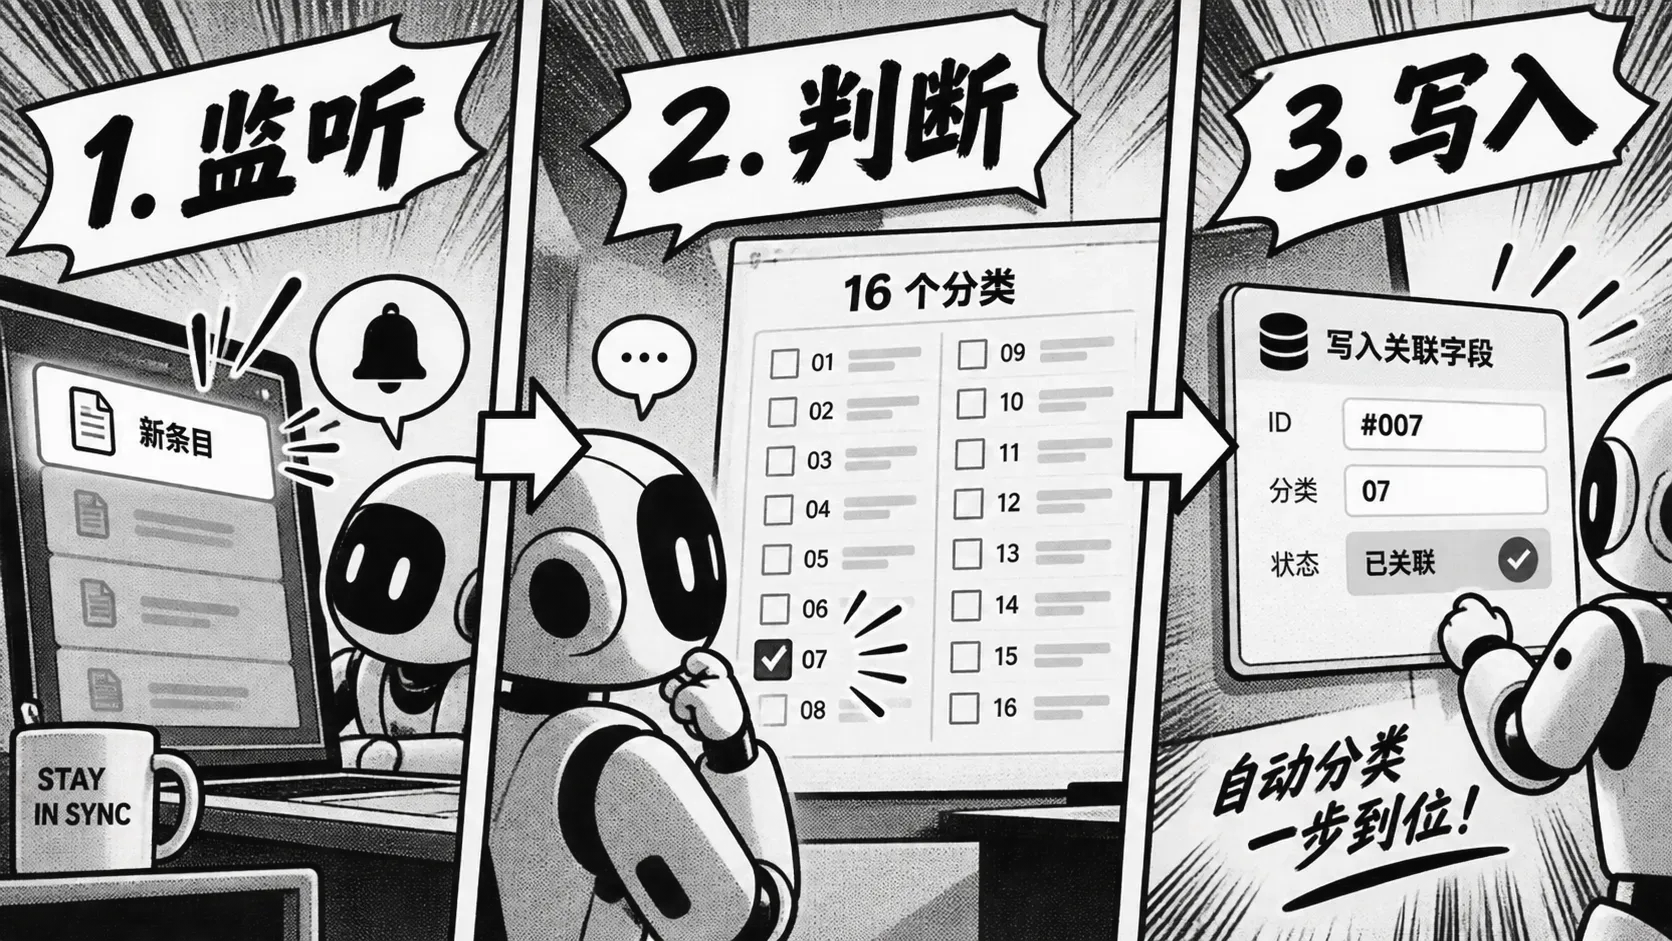
真正干活的是第二个场景,三个模块串成一条线。
第一个模块,Notion 的 Watch Database Items,监听知识库,按创建时间抓取新增条目,拿到标题、关键词、知识总结这些字段。它记着上次运行的位置,每次只抓新进来的部分,不会重复处理旧条目。
第二个模块,OpenAI 创建对话。System 提示词的结构是,先声明它是一个专业的文章分类专家,然后把十六个分类的名称和 ID 全部列进去,要求它根据发来的文章内容选出最匹配的首选分类和次选分类,输出 JSON 格式,包含首选分类、首选 ID、次要选项、次要 ID 四个字段。User 消息传 Notion 抓到的标题、关键词和知识总结。
模型选 GPT-3.5 这一级的就够了,分类是个简单任务,用贵模型纯属浪费。高级设置里务必打开 JSON 输出格式,格式一漂,后面的流程当场断掉。
第三个模块,先过 Parse JSON 把返回拆成独立字段,再加 Notion 的 Update Database Item。条目 ID 填第一个模块抓到的那条,告诉 Notion 更新谁。关联属性的 Map 字段里,单选关联直接填首选 ID,解析出来的那串 UUID 原样传进去就行。
多选关联要稍微讲究一点,同时写入首选和次选要用 add 函数,写成 add 括号 emptyarray 分号首选 ID 分号次选 ID 的形式。这里的原理是 add 把两个 ID 合并成一个数组交给关联属性,emptyarray 是起点的空数组。有个坑要记牢,add、分号、emptyarray 这些关键字必须在 Make 的公式面板里输入,识别成功的标志是它们显示灰色底色。手打在普通输入框里,公式不会被认出来,运行时只会得到一串没用的文本。
自动化的颗粒度是 ID,模型的判断再准,终究要落到一串 UUID 才算数。
定时怎么配,清单一起交
这套工作流不是实时触发的,靠 Make 的调度功能定时跑。
配置思路是先估算你的知识库每天新增多少条目,最大条目数按两倍设。日增十条就设 20,留出余量防某天集中收藏。运行时间设在一天的低频时段,比如每天晚上八点,Make 自动扫描当天新增,逐条分类关联。想升级成实时触发也可以,Notion 的 Webhook 或 Make 的 Instant Trigger 能做到库一变动就分类,但我建议先跑定时版稳定一两周再考虑,一步到位的调试成本高。
上线后头几天多看一眼 Make 的运行历史,哪条记录分类失败、哪条 JSON 解析报错,日志里一目了然,趁问题还少的时候修掉。
给要交付这套系统的工程师一份落地路径。一,先把分类维度定稳,场景库建好拿 ID。二,Airtable 汇总表和 ChatGPT 提示词里的分类清单要保持同步,新增分类后必须重新生成这段清单,这是本方案唯一需要手工维护的点。三,多选写入先在单条记录上试跑,确认公式面板识别正常再放开。四,跑一周后抽查二十条分类结果,统计准确率再决定要不要调提示词。
准确率不理想怎么调,路子是给模型更多信息。知识库条目只有光秃秃的标题,模型只能猜,用 Notion AI 先自动生成摘要和关键词再传给分类模型,判断依据多了,准确率自然上来。反过来讲,摘要本身就是你写提示词时最该喂进去的东西,标题加摘要加关键词三件套齐了,大多数分类在模型那里都是送分题。
收个尾。Notion 的价值从来不是存储,是组织,知识只有连成网络才会在你需要的时刻浮出来,孤岛式的库再多也只是硬盘。老雷见过太多团队的 Notion 建了几十个库,用着用着退化成一个大型草稿箱,存进去的东西再也检索不出来,缺的就是这条让库和库自动握手的线。把分类这件事交给系统,你只管往里存东西,网络会自己生长。