老雷AI实验室
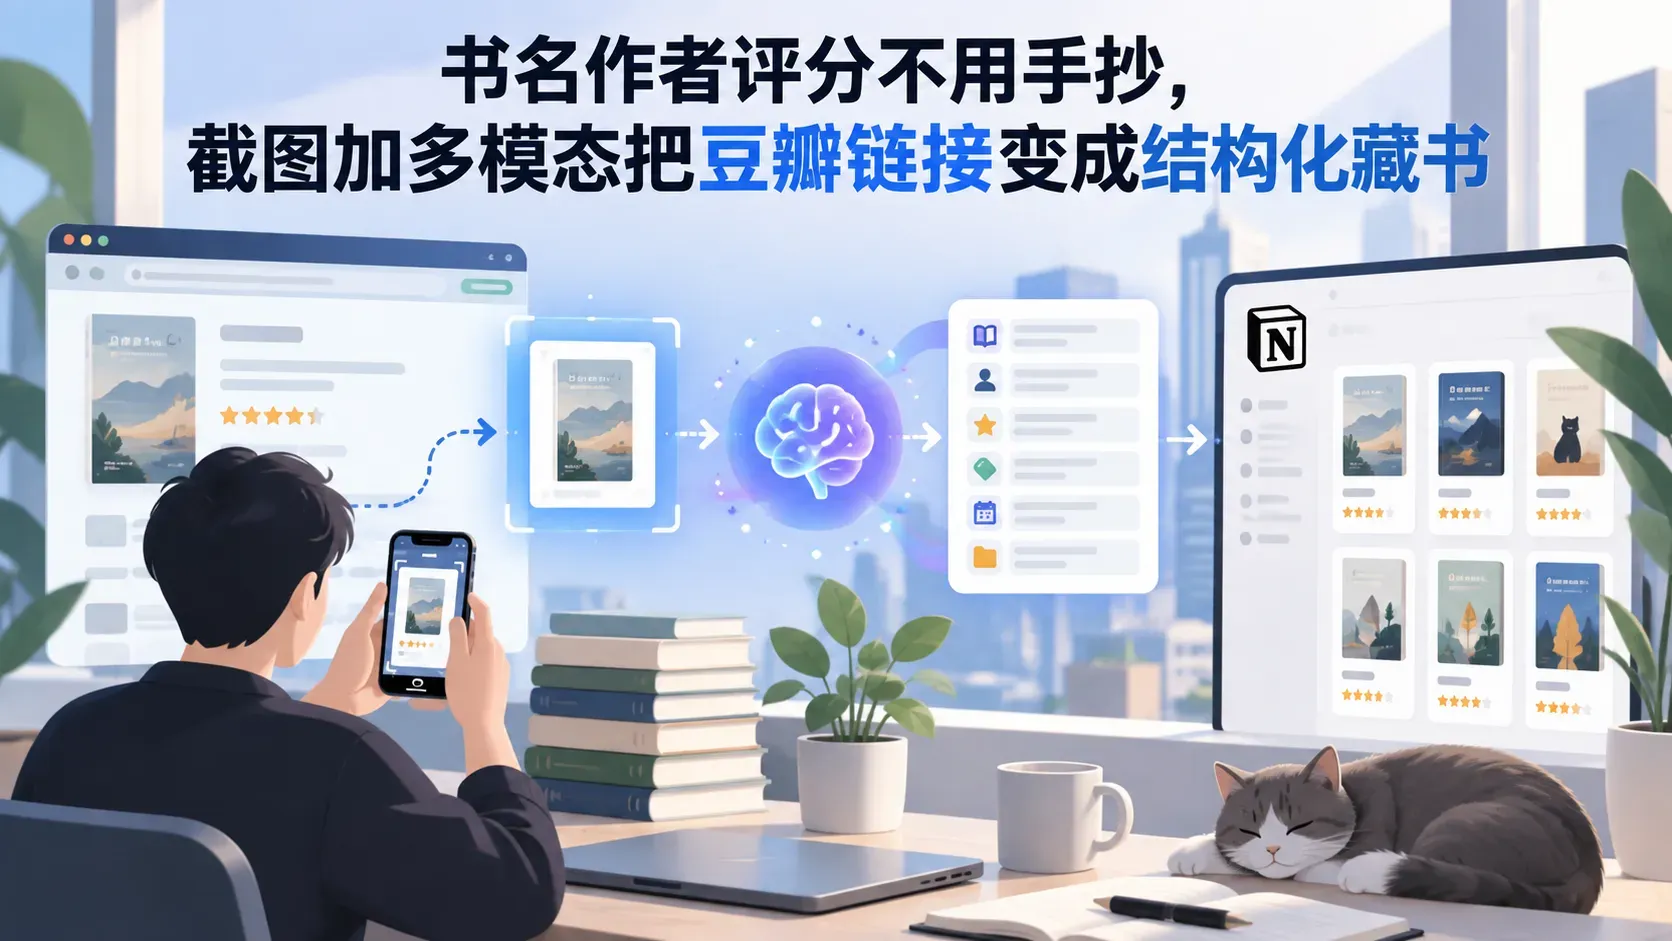
书名作者评分不用手抄,截图加多模态把豆瓣链接变成结构化藏书
在豆瓣看到一本想读的书,想把它收进自己的知识库,你会怎么做。复制书名,切到 Notion 粘贴,回来再复制作者,再切回去,出版社、出版年、页数、定价、ISBN、评分,十来个字段来回切换,一本书抄完,读书的劲头已经去了一半。抄三本就烦,抄到第十本,大多数人直接放弃。
这事诡异的地方在于,每个字段就几个字,单独看都不费劲,凑在一起就是一场消耗战。注意力来回切换的成本,比打字本身高得多。
我管着自己的电子书库,几百本,全靠一套自动化在养。豆瓣链接丢进 Notion 的「网页」字段,状态改成「开始」,几分钟后回来,书名、作者、出版社、页数、价格、ISBN、豆瓣评分、简介,整整齐齐全填好了。实测这套方案管几百本书,分类检索比手动整理快了一个量级,按评分排序、按出版社筛选,都是点一下的事。
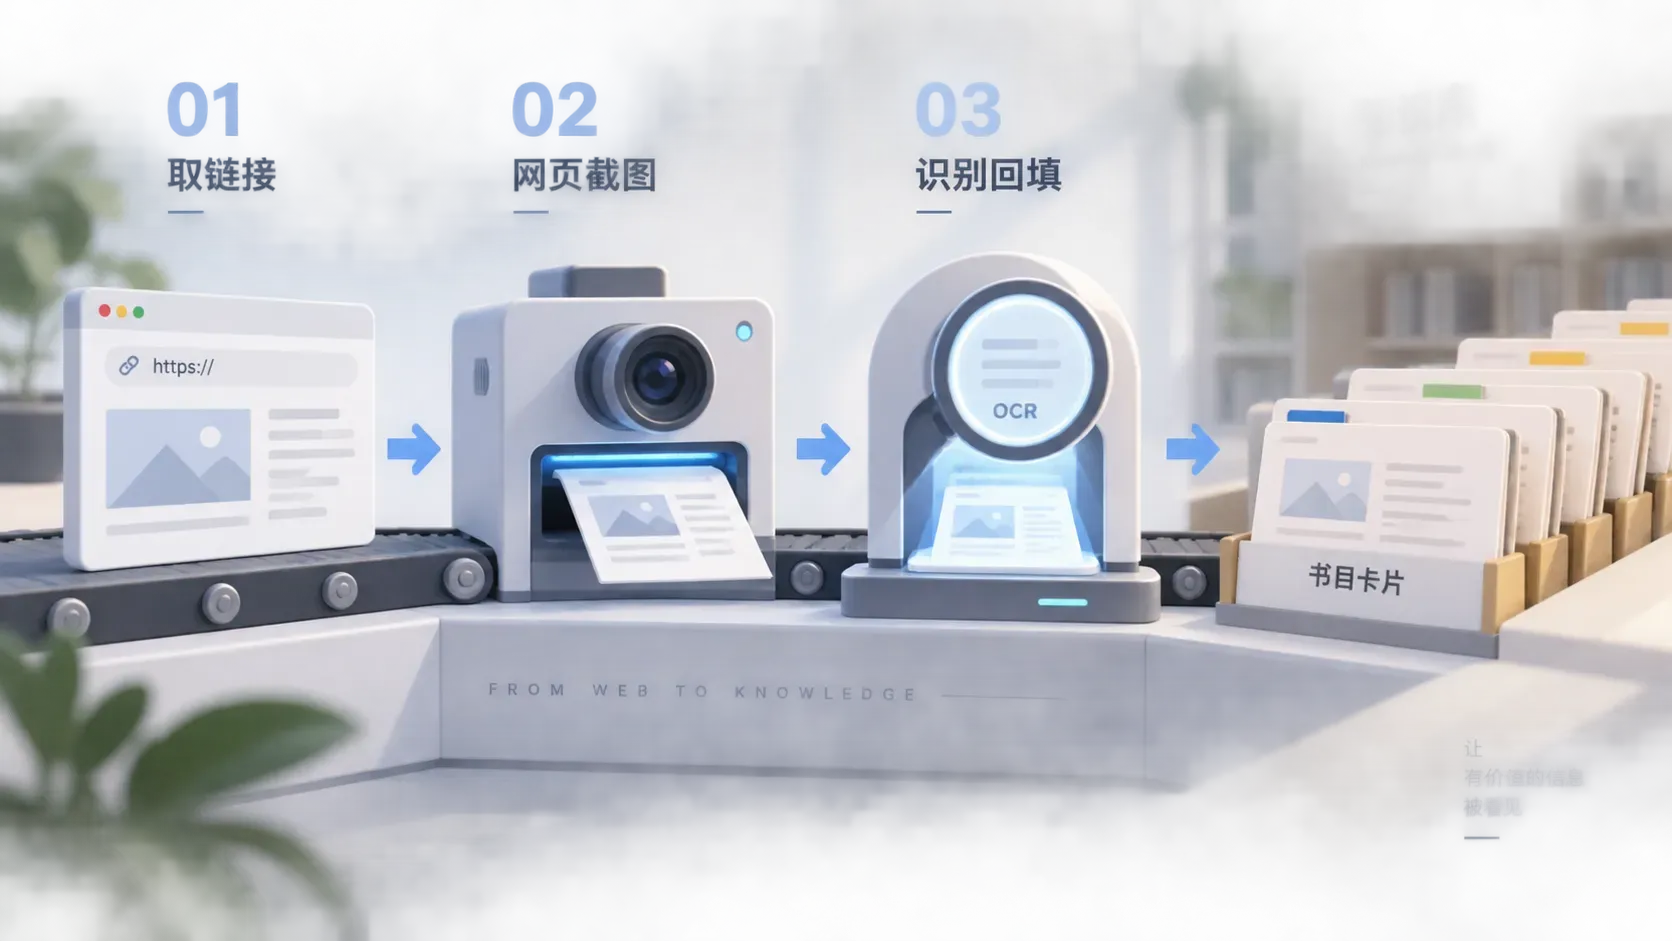
这篇拆的就是这条产线,Notion 加 Make 加 GPT-4o 的多模态。七个模块,核心思路九个字就够了,截图、识别、结构化保存。
七个模块,三段分工
先看数据库长什么样,十二个属性。书籍名称是 Title,网页存豆瓣链接,状态是 Select,两个选项,「开始」和「已完成」,作者、书籍简介、出版日期、出版社是文本,页数、价格、豆瓣评分是数字,封面用 Files 预留,再加一个 ISBN。
两个设计细节说一下。页数和评分用数字类型而不是文本,后面才能做排序和筛选,四百页以上的大部头一筛一个准。ISBN 值得单独一个字段,这是书的身份证,跨库去重、全网比价,认的都是它。日常使用就两个动作,粘链接,把状态点成「开始」。
这十二个字段平时看着静态,攒上几十本就开始说话了。按出版社聚合,能看出自己偏爱的那几家;按评分筛一遍,九分往上的那一排就是你的年度书单雏形;页数那一列还能反向提醒你,今年到底有没有啃动大部头。结构化的好处要等量变之后才看得清,这也是为什么值得一开始就把字段建全。
第一段取活。Notion 的 Search Objects 模块关联图书馆数据库,筛选状态等于「开始」,限制一次只取一条,拿到豆瓣链接就走。一次一条听着效率低,其实是刻意为之,两条同时跑,截图额度双倍烧,模型调用并发挤,出了错你还分不清是哪条出的事。串行慢一点,账清楚,排错也只有一条线可查。
第二段把网页变成图。HCTI 是个网页截图服务,Make 内置了它的模块,注册拿到 User ID 和 API Key 填进连接配置,免费账户每月 50 次截图,个人完全够用。两个参数决定后面的识别质量,Device Scale Factor 拉到 3,截图放大三倍更清晰,小字号的书名和评分数字,多模态读起来稳得多,Full Screen 关掉,豆瓣的图书信息集中在页面顶部,要的只是首屏。截图生成后,接一个 HTTP Get a File,把图片下载到 Make 服务器上。
第三段识别加回填。OpenAI 的 Analyze an Image 模块,模型选 GPT-4o,图片来源映射上一步下载的文件,Max Tokens 给到 1000 到 3000,让它把图里的书名、作者、出版社、出版年、页数、定价、ISBN、简介、评分一样样读出来。再往后,Notion 的 Update a Database Item 收尾,Database Item ID 映射检索到的条目,识别结果逐一映射回对应字段,状态翻成「已完成」。
跑顺之后把场景设成定时运行,比如每小时检查一次,库里有活就干,没活就歇。定时的粒度别拍脑袋,Make 的套餐按操作数计费,检查本身也消耗额度,收书节奏快就调密一点,一周收几本就设成每天一次,够用就好。中间还有两个模块,负责把「读到的东西」变成「能存的东西」,是整条链路最见功力的设计,单独开一节讲。
提示词的胜负手,字段名对齐
识别模块的提示词,骨架是三段。开头定义角色,一个中文信息提取助手,专注从书籍网页截图中提取准确信息。中间交代语言和任务边界。重心在 OutputFormat,九行字段清单,一行一个,书名、作者、出版社、出版年、页数、定价、ISBN、内容简介、豆瓣评分,每行后面跟一句提取要求,比如页数只保留数字。
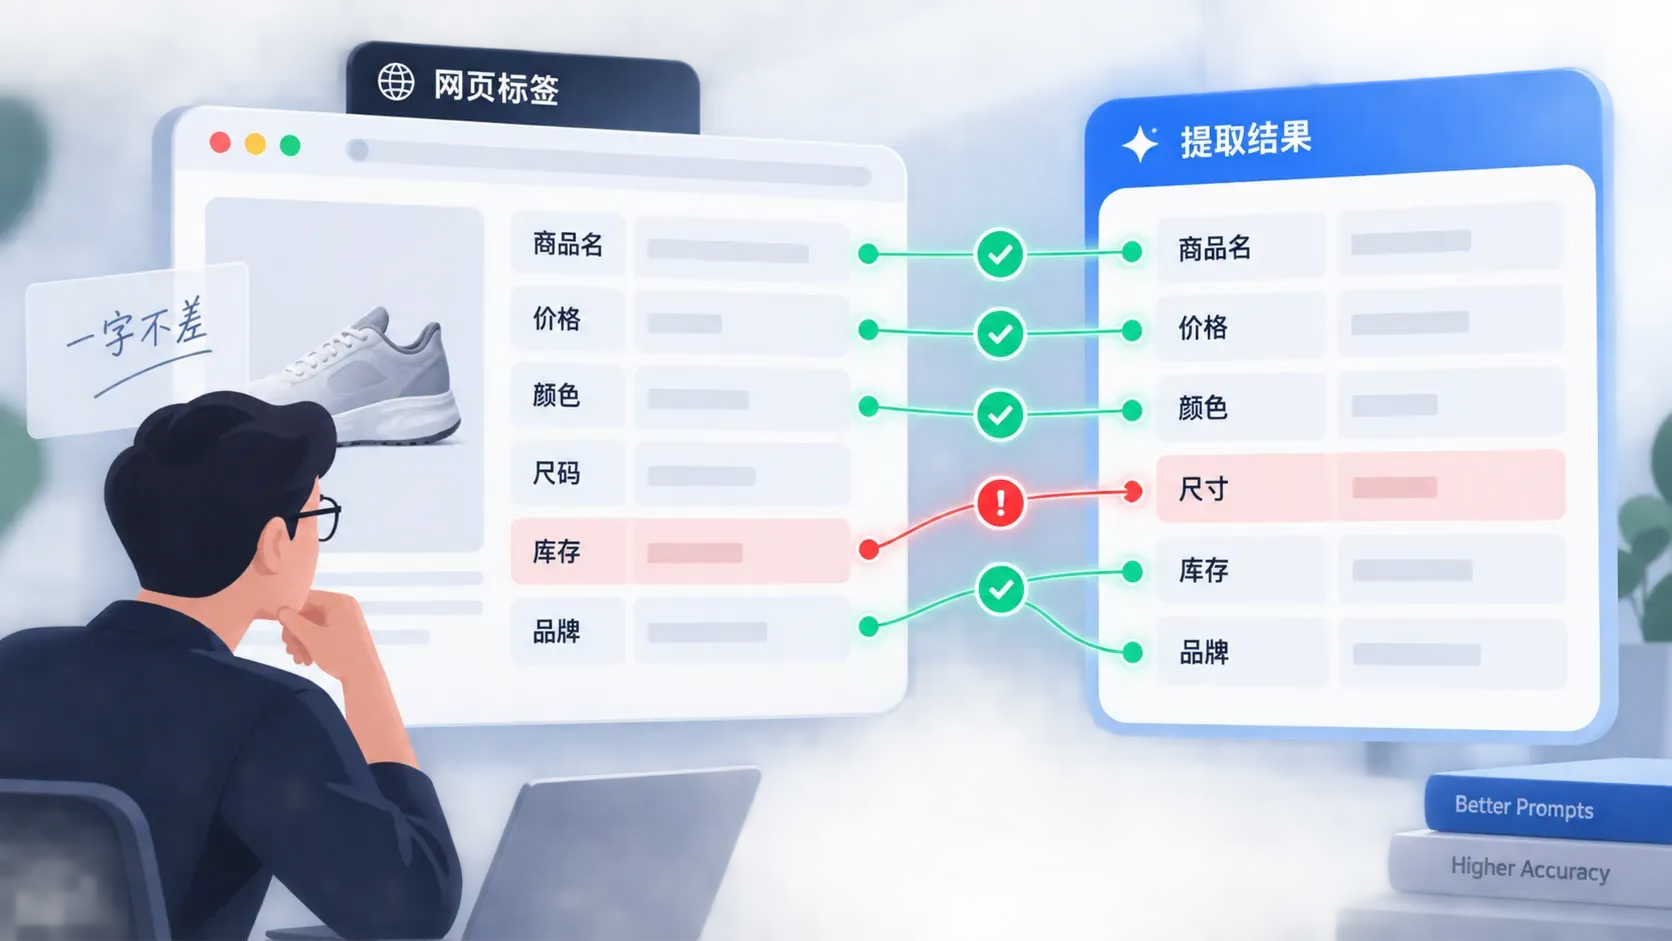
这里有个特别容易忽视的坑。OutputFormat 里的字段名必须和豆瓣页面上的原始标签一字不差。页面上叫「出版年」,你就别写成「出版日期」,页面上叫「定价」,你就别写「价格」。模型是照着页面标签找信息的,标签对不上,它就开始自由发挥,轻则留空,重则自己编一个填上去,编的还挺像那么回事。
识别完还没完,因为多模态模块管不住输出格式,它负责「看」,对话模块负责「整理」。再接一个 GPT-4o 的 Create a Chat Completion,输出格式选 JSON,Max Tokens 给 1000,提示词里给它一个固定模板,九个字段各归各位,再把识别结果原文拼给它。末尾一个 JSON Parse 模块把这串文本拆成独立变量,Notion 映射起来才有东西可接。
一个模块包办看和整理的写法我试过,输出格式忽好忽坏,拆开之后每段提示词短一半,稳定得多。提示词写长容易写短难,每一行都要有存在的理由。老雷见过不少提示词翻车,问题多半出在字段名这种细节上,不是什么高深技巧。
精度与额度,两条硬边界
实测绝大多数识别是准的,少数复杂字符会出错,比如外文书名里的特殊字母组合,模型偶尔认岔。概率不高,但你要知道它存在,抽查的时候拿 ISBN 去豆瓣反查一下,对得上就放心。
对准确度要求极高的场景,链路末尾加一道人工审核。Notion 状态从两档变三档,「开始」「待审核」「已完成」,识别完先落「待审核」,扫一眼再放行。多花十秒钟,换来的是整库数据可信,这笔账怎么算都划算。
额度那头,HCTI 免费户每月 50 次截图,按一天收两三本书的节奏,一个月用不完。真要大批量跑,升级付费计划,或者换 ScreenshotOne 这类截图服务,链路其余部分一概不动,截图这步是标准接口,换谁都能接。
还有一个预期要摆正,封面图的自动保存不在这条产线里,那是另一条拆书工作流的活。这条管的是元数据,书一进库,检索的骨架先立起来,封面属于锦上添花。
也把丑话说在选型这头,偶尔收一两本书的人不值得搭这套,手动抄加口述摘要,十分钟的事。它值回成本的门槛是稳定流入,每周十本往上,或者整库要拿来排序、筛选、统计分析的场景。量到了,这条产线就是印检索率的;量不到,它就是摆在架子上落灰的乐器。
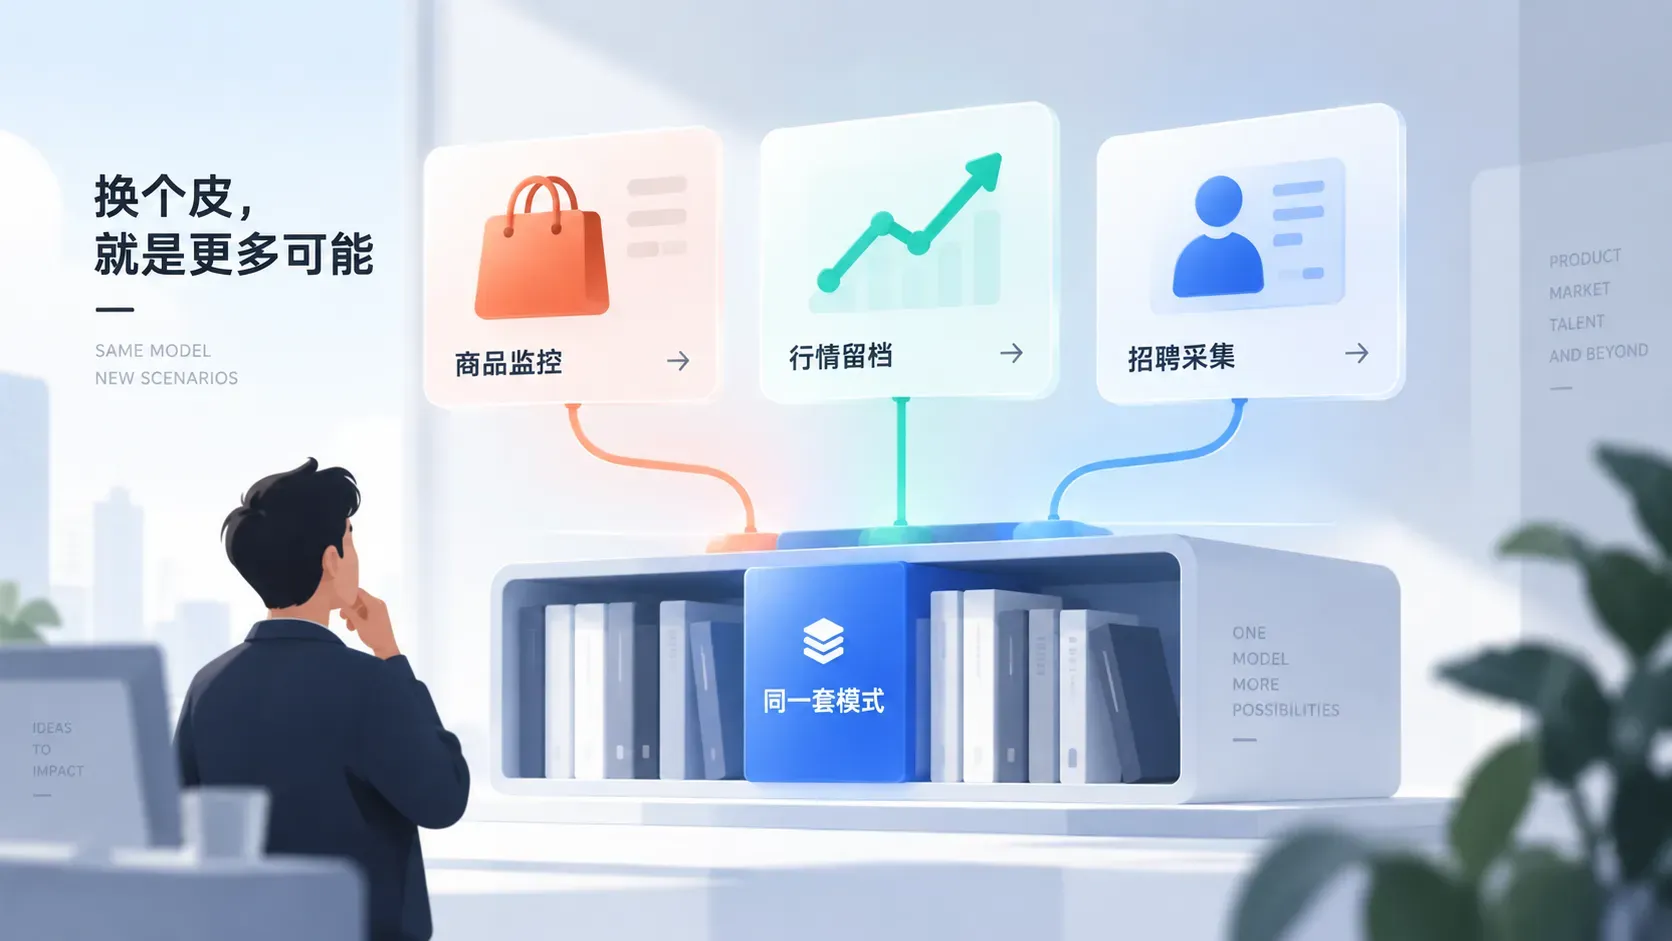
换个皮,就是商品监控和招聘采集
这套东西真正值钱的不是管书,是那个九字模式,截图、识别、结构化保存。
它比传统的网页解析路线皮实得多。解析 HTML 要跟对方的页面结构搏斗,网页一改版选择器全废,前端渲染复杂的站点拿到的还是空壳。截图路线绕开了所有这些,只要人眼能从截图里读出信息,GPT-4o 就能读出来,对方页面怎么改版都影响不到你。页面 rendered 成什么样,模型看到的就是什么样,这句话就是这条路线的全部底气。
豆瓣链接换成电商详情页,就是商品价格监控,每天截一张,价格走势自己会说话。换成行情页面,就是数据留档。换成职位列表,就是招聘信息采集,职位、公司、地点拆成字段存进表里,筛起来比翻网页快得多。想再懒一步,接一个 RSS 模块把豆瓣新书源自动写进 Notion,状态直接设「开始」,连丢链接这个动作都省了,无人值守,库自己长大。
丑话说在前面,第一次搭这条产线不快。HCTI 和 OpenAI 的 Key 各申请一轮,Notion 集成要授权,十二个字段的映射要对一遍,提示词里的九个字段名也要跟页面标签核一次,整套下来半天起步。但它属于搭一次吃很久的那种基建,跑顺之后你每本书的边际成本,就是一次截图额度和一次模型调用。
老雷的建议是拿一个你每天真的会看的页面先跑通全链路,别一上来铺十个场景,一个跑通的模式才推得开,十个半成品只会互相拖垮。
藏书的价值不在数量,在检索成本。那一栏栏看着枯燥的结构化字段,是以后每一次检索少付的学费。
回到开头那个场景。以后在豆瓣点完「想读」,顺手把链接丢进库就完事,抄字段的功夫省下来,多读两页书。书库这种东西养得越久越值钱,而养它的成本,最好低到感觉不到,这才是自动化该有的样子。