老雷AI实验室
Skill 不是提示词,给 Claude Code 立规矩的五层结构
前阵子去一家做跨境电商的公司做 AI 诊断,技术团队人人开着 Claude Code,终端里的会话排成一排。我问负责人大家用得怎么样,他给了句大实话,效果好的时候像开了挂,效果差的时候怀疑模型不行,全看手感。
我说这不用猜,是你们没给 AI 发操作手册。
多数人把 Claude Code 用成聊天窗口,输入一段话,等一段回复,效果好就惊喜,效果差就换个说法再问一遍。这么用,永远在开盲盒。真正拉开差距的思路,是让 AI 按你的标准、你的流程、你的节奏稳定交付,载体就是 Skill。
Skill 不是什么神秘插件,它是一份给 AI 的标准操作手册,写清楚什么时候触发、按几步执行、读哪些文件、调哪些脚本、结果放哪里、失败了怎么恢复。老雷这两年帮企业做 AI 落地,见过一条特别清楚的分水岭,把流程沉淀成 Skill 的团队,AI 是生产力;继续靠临场发挥的团队,AI 是抽卡。
这篇把一套跑在生产环境里的 Skill 结构拆开讲,每一层都给能直接对照的检查项。
五层结构,一眼看全
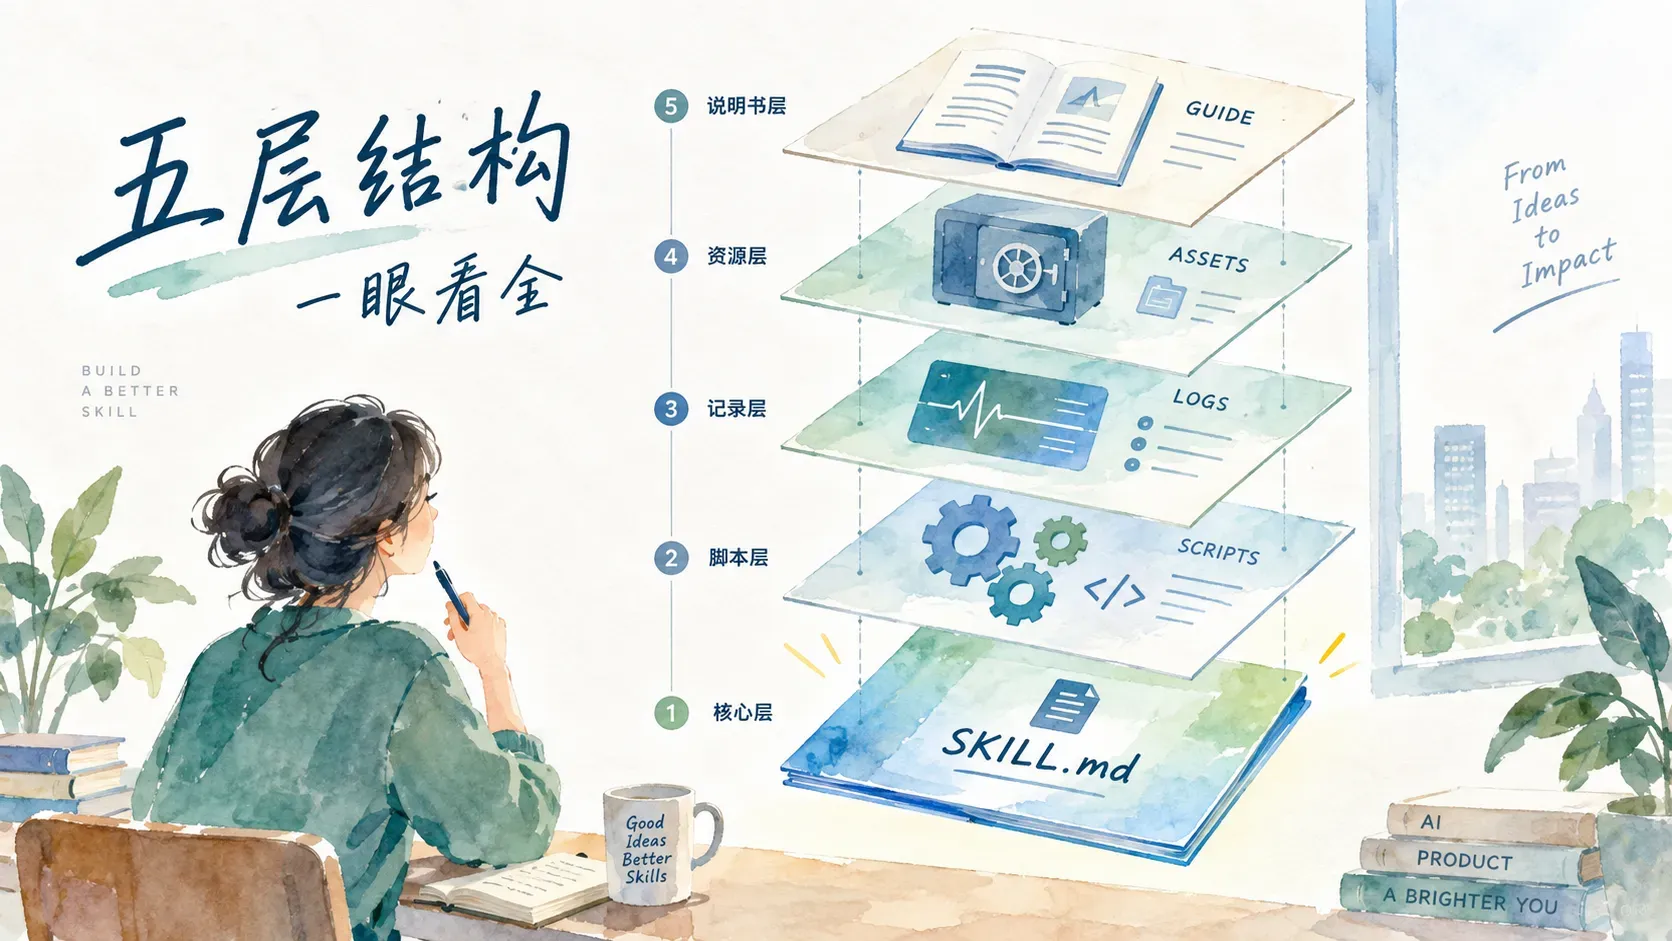
一个能稳定复用的生产级 Skill,从里到外一共五层。
核心层是 SKILL.md、工作流表格和平台约束,定义这个 Skill 是什么、什么时候触发、执行几步。执行层是 scripts、prompts 和变量占位符,脚本干确定性的体力活,Prompt 干需要判断的脑力活。数据层是 runs、state、config 这些目录,管每次运行的数据放哪、进度怎么记、断了怎么接。资源层是 credentials、definitions、presets、templates,管凭证、常量、预设和输出模板。最外面是工程化层,setup、guide、changelog、troubleshoot 四件套,让别人能装、能懂、能维护、能排错。
最小可用的 Skill,只需要核心层一个文件。 后面四层,是它被反复使用之后慢慢长出来的。别一上来把五层目录全铺满,那不叫工程化,叫给自己添堵。
工程化四件套听着不性感,但特别救命。setup 管安装和依赖,guide 管新人怎么上手,changelog 管版本之间改了什么,troubleshoot 管常见故障怎么排。Skill 一多你会发现,耗时间的从来不是第一次写出来,是三周后忘了它怎么装,半年后不知道它为什么坏,换台电脑不清楚缺了哪个依赖。这几份文档,是写给三个月后那个失忆的自己的。
再集中说核心层。SKILL.md 是一本书的封面加目录,封面告诉系统它叫什么、能干什么,目录告诉 Claude Code 按什么顺序执行。frontmatter 里就两个字段要较真。name 用小写字母加连字符,让系统能认。description 用第三人称写清功能和触发条件,比如「将英文文章翻译为中文,当用户说翻译文章、转中文时触发」,别写「我可以帮你」这种对话腔,你是在给系统写说明书,不是在跟用户寒暄。触发词写得越具体,Claude Code 判断该不该调用的准确率越高,这一行字的回报率是全文最高的。
真正压阵的是工作流表格,每一步的职责、执行者、对应文档、输入、输出,一行一步写明白。好的 Skill 不是把一堆事塞给 Claude Code 让它临场发挥,是把流程拆成清楚的任务单元,初始化、采集、分析、输出,一步一格,谁来干、交什么,表格里见。
配套的执行文档还有条纪律叫渐进式披露,执行到哪一步,才读那一步的文档。整本手册不必一开始就塞进脑子,工作流表格是地图,step 文档是走到哪再翻开的哪一页。上下文就这么省出来的。
分工定生死,脚本和模型各干各的
执行层最容易踩的坑,是什么活都让 Claude Code 直接想。
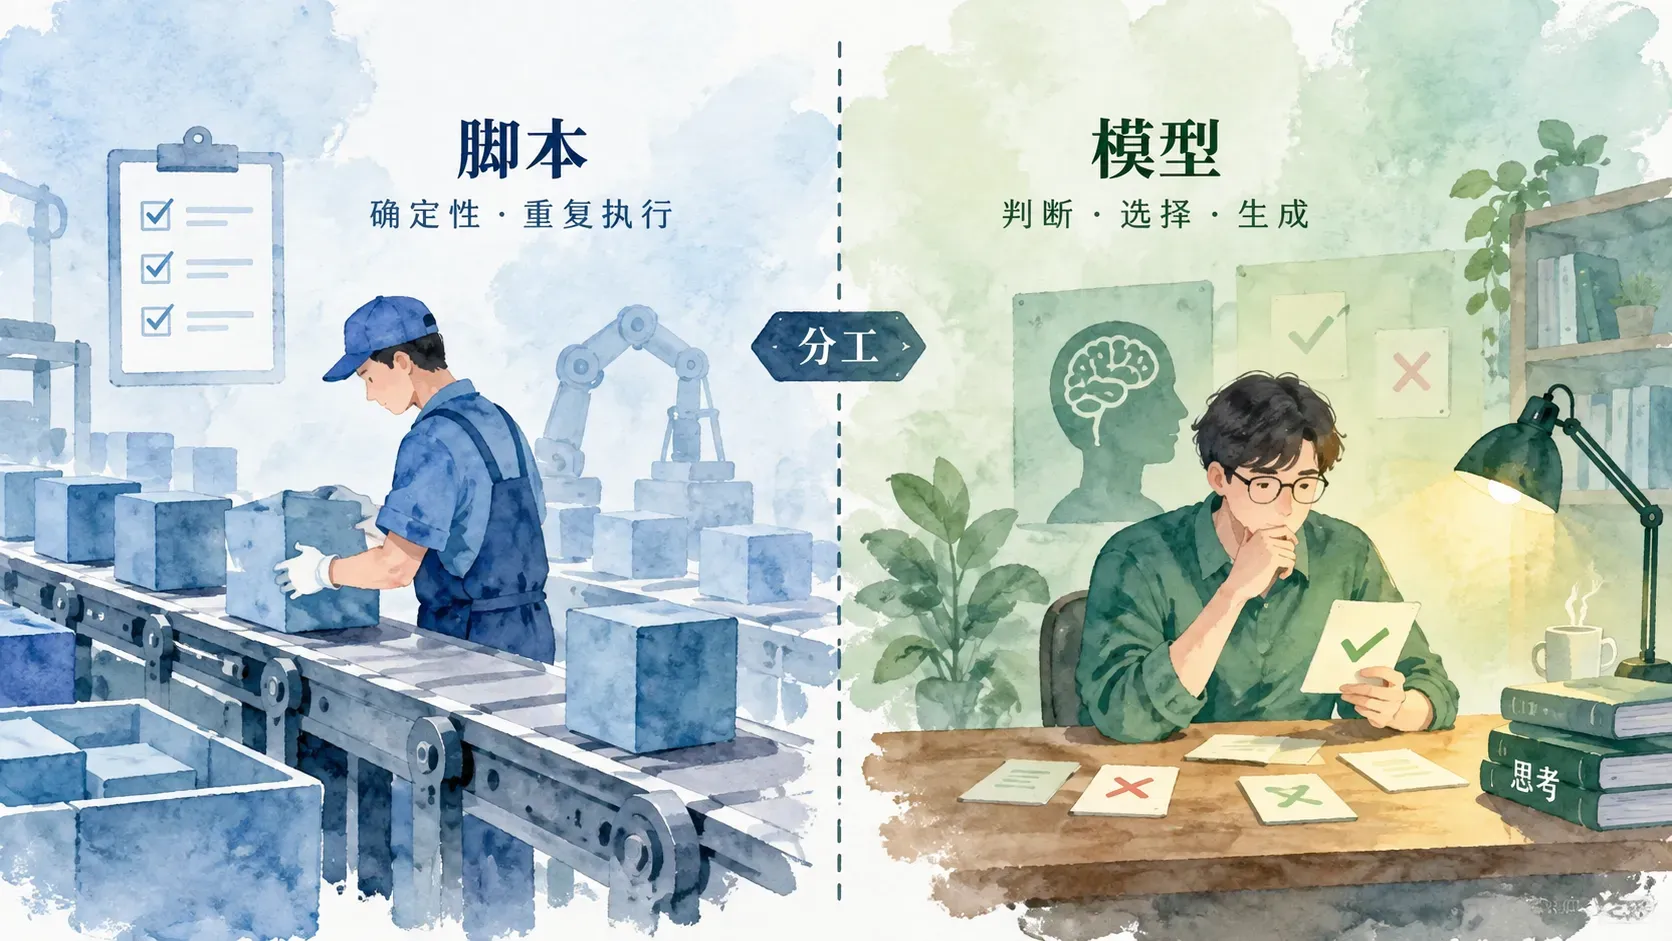
判断标准一句话就够,确定性的事交给脚本,需要判断的事交给模型。 批量重命名、读 JSON、合并 CSV、下载图片、校验文件结构,全下沉进脚本,脚本稳定、便宜、几乎不吃上下文。判断标题够不够抓人、分析用户痛点、诊断内容质量,这些才轮到模型出手。道理不难懂,模型的每一次阅读和思考都在消耗上下文,让模型去干复制粘贴的活,等于请主厨去洗碗,钱花了,活还没干漂亮。
Prompt 模板也要标准化,一份生产级 Prompt 至少六件事。角色,你是谁。任务,要做什么。输入,从哪里读数据。输出,写到哪个文件。约束,哪些不能碰。验收,怎么判断做完了。这六件事放进 prompts 目录当模板,谁来做这件事就给谁发哪份,别全堆在 SKILL.md 里互相打架。
把这六件事串起来的是变量占位符,{inputpath}、{rundir} 这一族。老雷在这里给大家提个醒,有条原则特别反直觉,传路径,不传内容。别让 Agent 自己猜文件在哪,路径必须从状态文件或参数里明确递过去。内容一旦整段塞进提示词,上下文就开始失控,跑两步就爆。
progress.json 是心跳,不是可选件
复杂 Skill 最怕的不是失败,是跑到一半,你不知道它发生了什么。
所以每次运行都开独立目录,runs 下面按任务建文件夹,里面分 state、output、logs。state 里躺着的 progress.json 就是心跳,至少记六样东西,当前步骤、输入路径、输出路径、状态、错误信息、时间戳。写的时候记住一条,心跳要跟着步骤走,做完一步更一次,别等全部跑完再补,那种事后补的心跳救不了场。
这文件看着不起眼,救过我不止一次。我跑过一批夜里挂着的长任务,中途上下文被压缩,会话等于断片,第二天接着跑的时候,就是靠 progress.json 里记的步骤和路径,从断点原地满血,没有从头再来。上下文被压缩、会话被打断、任务半路挂掉,Agent 靠它知道做到哪一步、下一步干什么、能不能接着跑。没有它,任何一次中断都等于从零再来。
配置要分三层管。交互参数是用户这一次临时给的,比如主题和风格。默认配置是 Skill 自带的稳定参数,比如输出目录。预设配置是可复用的选项包,比如不同平台各一套风格。实践里最好用的是预设包,把几种常用输出风格各打包一份,新任务选个包就开工,不用每次口头描述半天风格。三层别混,混了之后改一个参数要全目录排查,维护必乱。
资源层同一个道理。凭证放 credentials,真实密钥坚决不进 Git。常量放 definitions,预设放 presets,输出样式放 templates。为什么不散着写图省事,因为魔法字符串会杀死可维护性。同一个平台名在八个文件里手抄,改一次全局搜,更糟的是 Agent 可能只改了五处,剩下三处旧值留着上线爆炸。资源层做的事,是给 Agent 留一套唯一真相源。
二十分钟,造出第一个
概念讲完,练手项目建议从文章翻译 Skill 开始,需求三句话讲完,输入一个英文 Markdown 的路径,输出中文版,保留标题、列表、代码块和链接。
目录只要三个文件。
article-translating/
├── SKILL.md
└── workflow/
├── step01-init.md
└── step02-translate.md
工作流就两步。第一步初始化,检查源文件存在,建运行目录,写 progress.json。第二步翻译输出,启动 SubAgent,把源文件路径和输出路径递给它,译文写进 output,SubAgent 自己只回一句极简状态,不把全文搬回对话。这两个 step 文档都很短,各写清执行说明、输入输出和验证点,比如第二步收尾要确认译文文件存在且非空,才允许报完成。
第一次跑通大概二十分钟。重点不在翻译本身,在四个设计习惯,路径明确、输出明确、状态明确、验证明确。这四条立住了,后面做十个 Skill,都是复制同一个手感。
顺手答两个高频问题。不会写代码能不能做,能,最小 Skill 就一个 SKILL.md,等要调 API 或批量处理文件了再加脚本。Skill 和 MCP 什么关系,MCP 是让 AI 调用外部工具的接口,Skill 是让 AI 按固定流程干活的章法,一个管手,一个管规矩,互补不打架。另外老雷的建议是,单条工作流控制在六到八步,超过十步就拆成多个 Skill,或者把确定性部分下沉成脚本,步数一多,出错的自由度跟着指数涨。
收尾说点虚的。写 Skill 这个动作,做的不只是工程,是把脑子里的隐性经验翻译成显性流程。
你「怎么写一篇好文章」的直觉,变成步骤文档。你「怎么做质量检查」的手感,变成检查清单。你「怎么排查失败」的经验,变成 troubleshoot。
AI 工作流真正值钱的地方,不是让 AI 偶尔帮你一次,而是让你的方法可以被复用、被调用、被改进。
Skill 不是插件。
它是你留给团队的操作手册,写的时候多认真,跑起来就多稳。
想动手的话别等,这周挑一件你重复次数最多的流程,先只写核心层那个 SKILL.md,跑顺一次,再让它慢慢长出后面四层。