 老雷AI实验室
图生视频别五个模型轮流试,先记住五要素
你输入「一只猫在跳舞」,AI 回你一坨抽搐的像素。多数人的第一反应是换模型,Runway 不行换 Kling,Kling 不行换 Sora,一个月烧掉好几个订阅费,废片率纹丝不动。
方向反了。Runway、Kling、Sora 这些主流模型,生成电影级画面的能力都有,出问题的是你跟模型沟通的方式。提示词写得太笼统,AI 只能瞎猜,猜对的概率约等于零。老雷把市面上主流模型的图生视频都过了一轮,这篇把选型思路和提示词写法一次讲清,帮你把废片率压下来。
先选模型,再谈提示词
模型挑错,提示词写得再好也白搭。按两条轴选,预算和用途。
零成本练手,Hailuo AI 或者 Kling 免费版,先把感觉跑起来,不用花一分钱,Luma 的 Dream Machine 也有免费额度,自然运动和光照做得不错。社媒量产,Kling 2.6,出片快,支持最长两分钟的视频,或者 Pika 2.5 胜在性价比。要带声音的成片,Google Veo 3.1 是目前唯一支持原生音频生成的主流模型,装在 19.99 美元一个月的 Gemini Advanced 套餐里,Kling 2.6 也能同步音视频。电影级品质,Sora 2.0 物理模拟最强,Runway Gen-4.5 控制力最强,十二美元一个月起。电商产品展示认准 Seedance 2.0,物理锚定带来的产品一致性是它吃饭的本事,产品在不同镜头里不会变样。角色一致性要求高的,用 Runway 的参考图锚定面部和造型。
再说一遍趋势,多模型协作。专业团队早就不是一个模型打天下,Sora 或 Veo 出主体素材,Runway 做风格化精修,Pika 和 Kling 快速出社媒变体,各干各擅长的活。
三个烧钱的误区
第一个,什么都想试。今天 Runway 明天 Kling 后天 Sora,每个都浅尝辄止,脾气没摸透,提示词写得不伦不类。老雷见过太多团队在这第一步就来回折腾,选一个主力模型深度用两周,把它的优势和局限摸清,比同时试五个有效得多。
第二个,只看价格不看场景。免费模型练手没问题,商业项目另算。我们做过对比测试,同一个提示词在免费和付费模型上各生成一版产品展示视频,客户选中付费版本的概率超过九成。省下几十块模型费,赔进去的是整轮交付,这笔账怎么算都亏。
第三个,忽视后期。很多人以为 AI 生成的视频就是成品,实际上再好的模型,原始素材也要做色彩校正、节奏调整和音效添加。实测下来,AI 生成只占总工时的三成,剩下七成是筛选和后期。预算和排期按这个比例留,别按一比一拍脑袋。
顺手把图生视频和文生视频的分界也讲清。手里已经有高质量参考图、需要精确控制画面,比如产品展示、角色动画,用图生视频。只有一个创意概念、画面细节愿意交给模型自由发挥,比如概念宣传片、氛围片,用文生视频。两条路还能串起来,先用文生视频探索方向,选中最好的一帧当参考图,再用图生视频出最终版,创意和可控各拿一半。
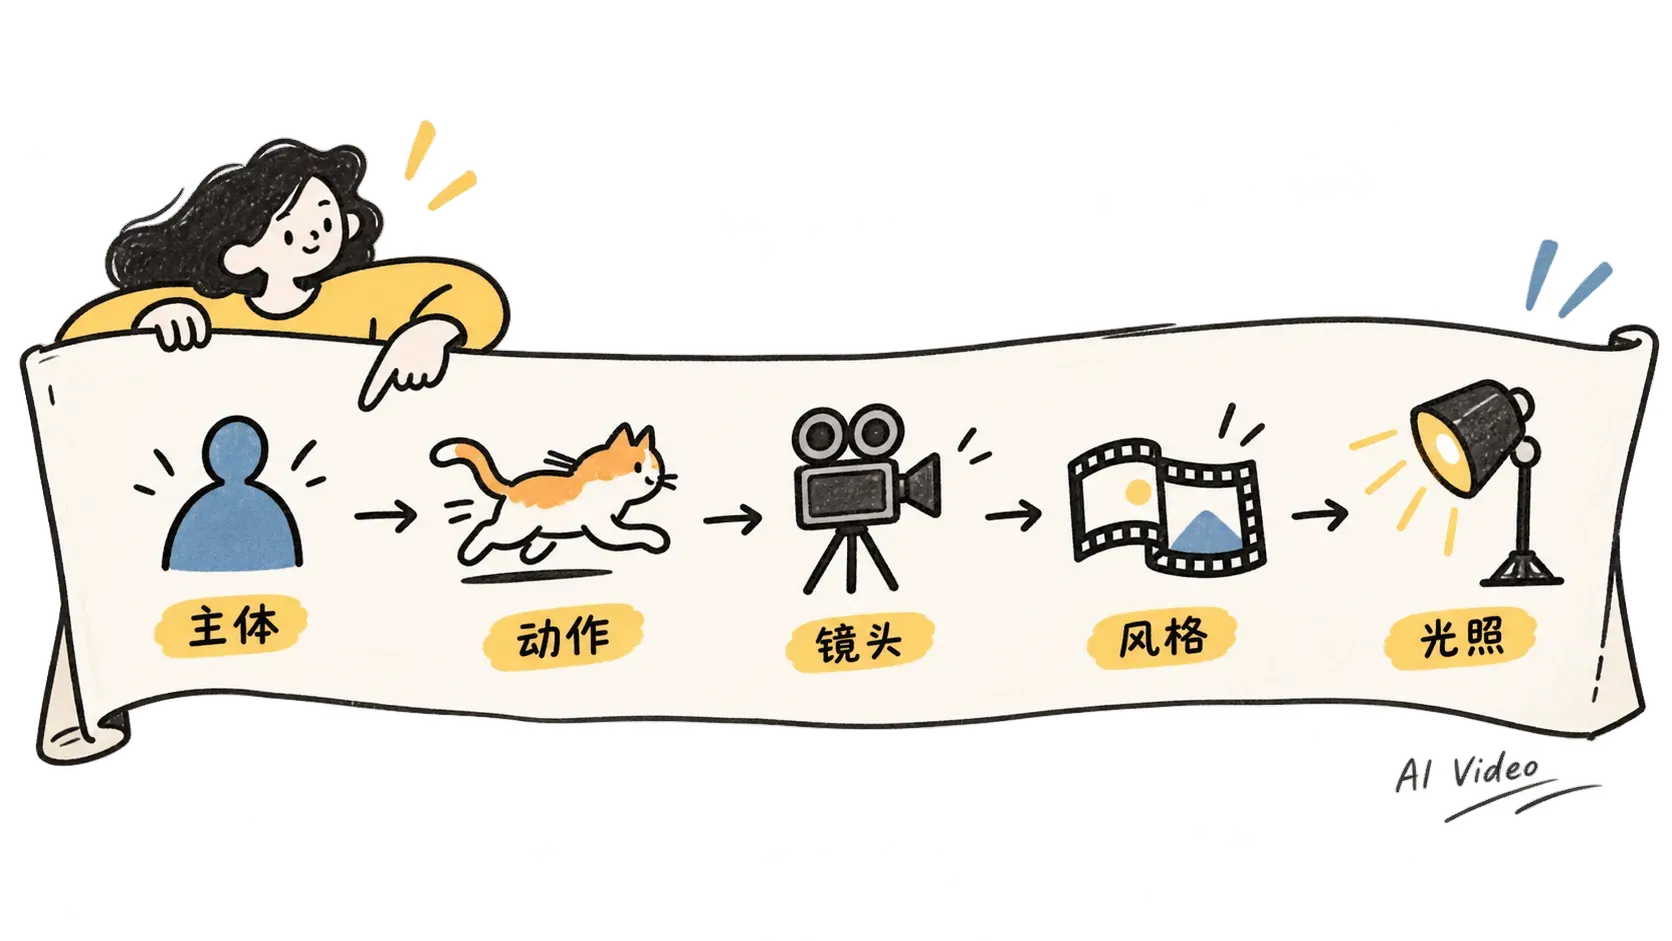
提示词五要素,缺一个 AI 就开始猜
主体。不是「一个人在走」,是「一位穿风衣的年轻女性在雨中的东京街头撑伞行走」。不是「一辆车」,是「一辆 1967 年的福特野马,樱桃红,镀铬保险杠锃亮」。不是「城市街道」,是「雨夜湿漉漉的东京小巷,霓虹灯牌倒映在柏油路面上」。模型靠关键词匹配训练数据里的视觉模式,描述越具体,它猜的空间越小。写英文通常优于中文,主流模型的训练数据以英文为主,英文不好就先用中文把画面写清楚,再让 Claude 或 DeepSeek 翻成视觉描述性的英文,注意别直译,「夕阳下的海边」不是 seaside at sunset,是 golden hour sunlight reflecting on calm ocean waves 这一类的视觉语言。用国产模型的话另说,实测 Kling 2.6 对中文提示词的还原度已经接近英文。
动作。图生视频的关键就是动起来,最重要的一条纪律是一条提示词只写一个核心动作。人物转头加风吹头发加背景下雨加猫跑过,模型会顾此失彼,画面直接乱掉。复杂场景拆成几段分别生成,后期拼接。动作词按效果挑,slowly walks、gently moves 出安静优雅的节奏,rushes through、sprints 出紧张动感,blinks、tilts head slightly 出写实微表情,wind blows、leaves fall、water ripples 这类自然现象给画面加生命力,picks up、pours 这类物体交互加叙事感。运动幅度用 slowly、gently、subtly 压着,幅度一大,人脸和手先崩。
镜头语言。这是最常被忽略的维度,也是业余感和电影感的分水岭。dolly in 推镜头加紧张感,dolly out 拉镜头展全景收尾用,orbit 环绕适合产品展示,drone shot 航拍撑场面,tracking shot 跟拍讲故事。低角度仰拍让主体显高大,拍建筑和人物立威都用它,高角度俯拍自带脆弱感,手持轻微晃动是纪录片的真实感,time-lapse 压缩时间,日出日落城市车流全靠它。敢组合效果更好,镜头从街道低空拉升揭示整座城市,跟拍转环绕,层次立刻不一样。
风格。电影级写实、动画、赛博朋克、复古胶片,选定一个主风格,最多叠一个辅助。photorealistic 配 cartoon,模型自己先精神分裂,出来的画面两头不靠。
氛围光照。同一个场景,golden hour 的暖光和冷蓝夜光是两种情绪,柔和窗光是日常,戏剧性侧光是悬疑。再加点天气和环境细节,rain、mist、steam rising,画面的层次感上一个台阶。写词之前花十到十五分钟做个情绪板,Pinterest 上收五到八张参考图,提炼共同的色调、光照和构图,提示词就不会写着写着跑偏。
五要素凑齐,AI 才不用猜。废片的来源从来不是模型不行,是你让它猜。
五要素背熟了,往一行公式里套就行,主体加动作加镜头运动加风格光照加氛围情绪。
拿电商产品展示举例。白色无线耳机盒放在深色大理石台面上,盒盖缓缓打开露出耳机,摄影棚柔光带出大理石的微妙反光,镜头四十五度平滑环绕,产品摄影风格,极简高级感。这条提示词翻成英文喂给模型,出片稳定性远好于一句「展示一下这款耳机」。
负面提示词同样重要,告诉模型你不要什么。no text、no watermark、no distorted faces,再加 no static image 防 AI 偷懒给你一张不会动的静帧,能挡掉一大半常见翻车,画面上凭空冒出来的字幕和水印基本可以绝迹。
出片不满意的时候,纪律是微调而不是重写。先判断哪个维度出了问题,主体不对改主体,动作太快压幅度,风格偏了换关键词,只动那一个词,其他保持不变。每次从头重写,你永远积累不出经验,也永远不知道上一版为什么差。
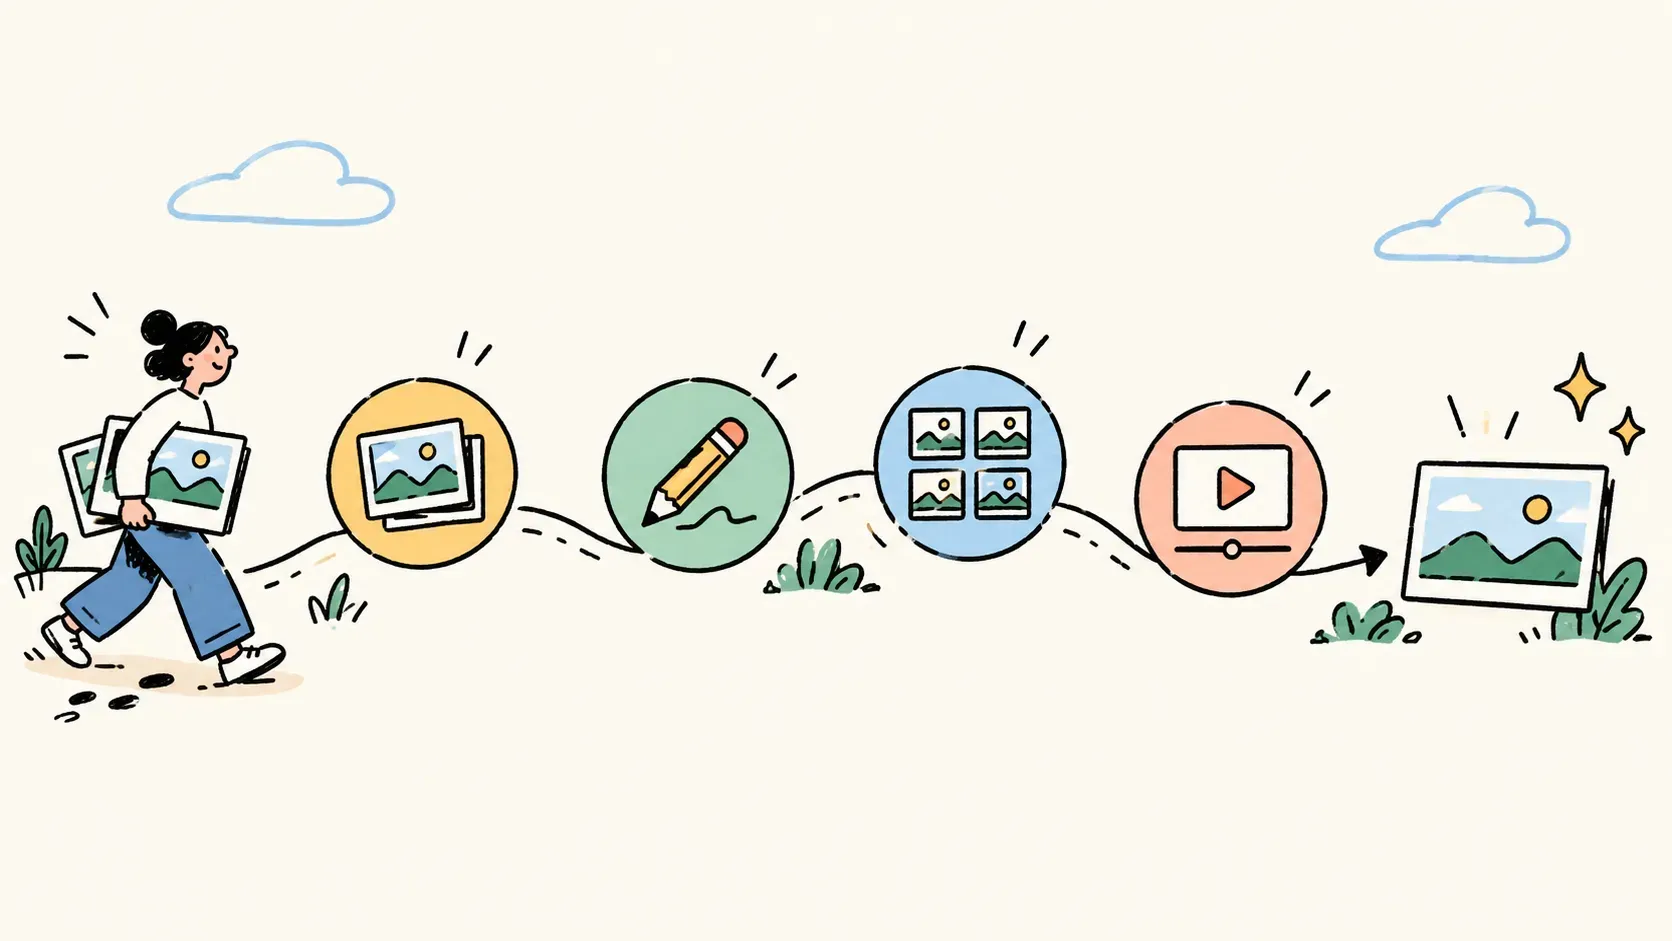
从生成到交付的四步
第一步,用 Midjourney 或 FLUX 准备高质量参考图,构图清晰、主体突出,分辨率 1920 乘 1080 起步。第二步,按用途选模型,五要素写提示词,附上负面清单,不想从零写就把画面描述、时长和用途丢给 Claude 或 ChatGPT,让它按五要素生成一条英文提示词外加一条负面提示词,人工再筛一遍。第三步,同一个提示词生成三到五版,挑动作最自然、画面最稳的那版,全不满意就微调提示词重来。第四步,CapCut 或 Premiere 做剪辑、配乐、调色,按目标平台的格式和比例导出。
还有三条进阶写法留给想再提一档的团队。时间线描述法,别把所有动作塞进一句话,按时间顺序写画面变化,镜头先对准桌上的咖啡杯,蒸汽缓缓升起,三秒后一只手从右侧伸入拿起杯子,五秒后镜头上移露出窗外的城市,这样写出来的片子有叙事感,不像一段会动的截图。情绪递进法,在提示词里指定情绪的变化方向,画面从平静安宁开始,逐渐转向紧张不安,光线也从温暖的金色转成冷峻的蓝色,短短几秒也能有故事感。物理细节法,越写实的片子越要描述微观细节,水滴的折射、布料的褶皱、金属的反光、头发在风里的飘动,实测加两三个,专业感立涨,这正是「AI 感」和「电影感」的分界线。再配一招负空间法,写明画面干净简洁、背景无杂物、人物周围留足空间,模型把元素堆成一锅粥的毛病能好一大半。
这门手艺现在的行情
已经被市场验证过的变现路径,电商产品展示视频单条 200 到 2000 元,婚礼和活动视频的 AI 增强单项目 1000 到 5000 元。还没打算对外接单的团队,先从内部用起来,电商详情页的动态图、社媒内容、短视频账号的 B-Roll 素材,省下来的制作成本就是第一笔回报。
老雷的建议就一条,选一个主力模型,用五要素模板跑十条片子,两周后拿数据复盘。模型半年一换代,价格还在一路往下走,但描述画面的这门语言不会过时,早练的人一直在吃红利。