 老雷AI实验室
文献综述别逐篇硬啃,Make 双分支一次产出两份报告
文献综述期的日常是这样一幅图景,检索一批论文,逐个下载 PDF,打开第一篇,抄下标题和作者,读完摘要再硬着头皮写总结,还要想这篇对自己的课题有什么启示。一篇下来一个小时没了。二十篇还能咬牙扛,到综述阶段要梳理几十上百篇的时候,纯手工就是不可行的方案。
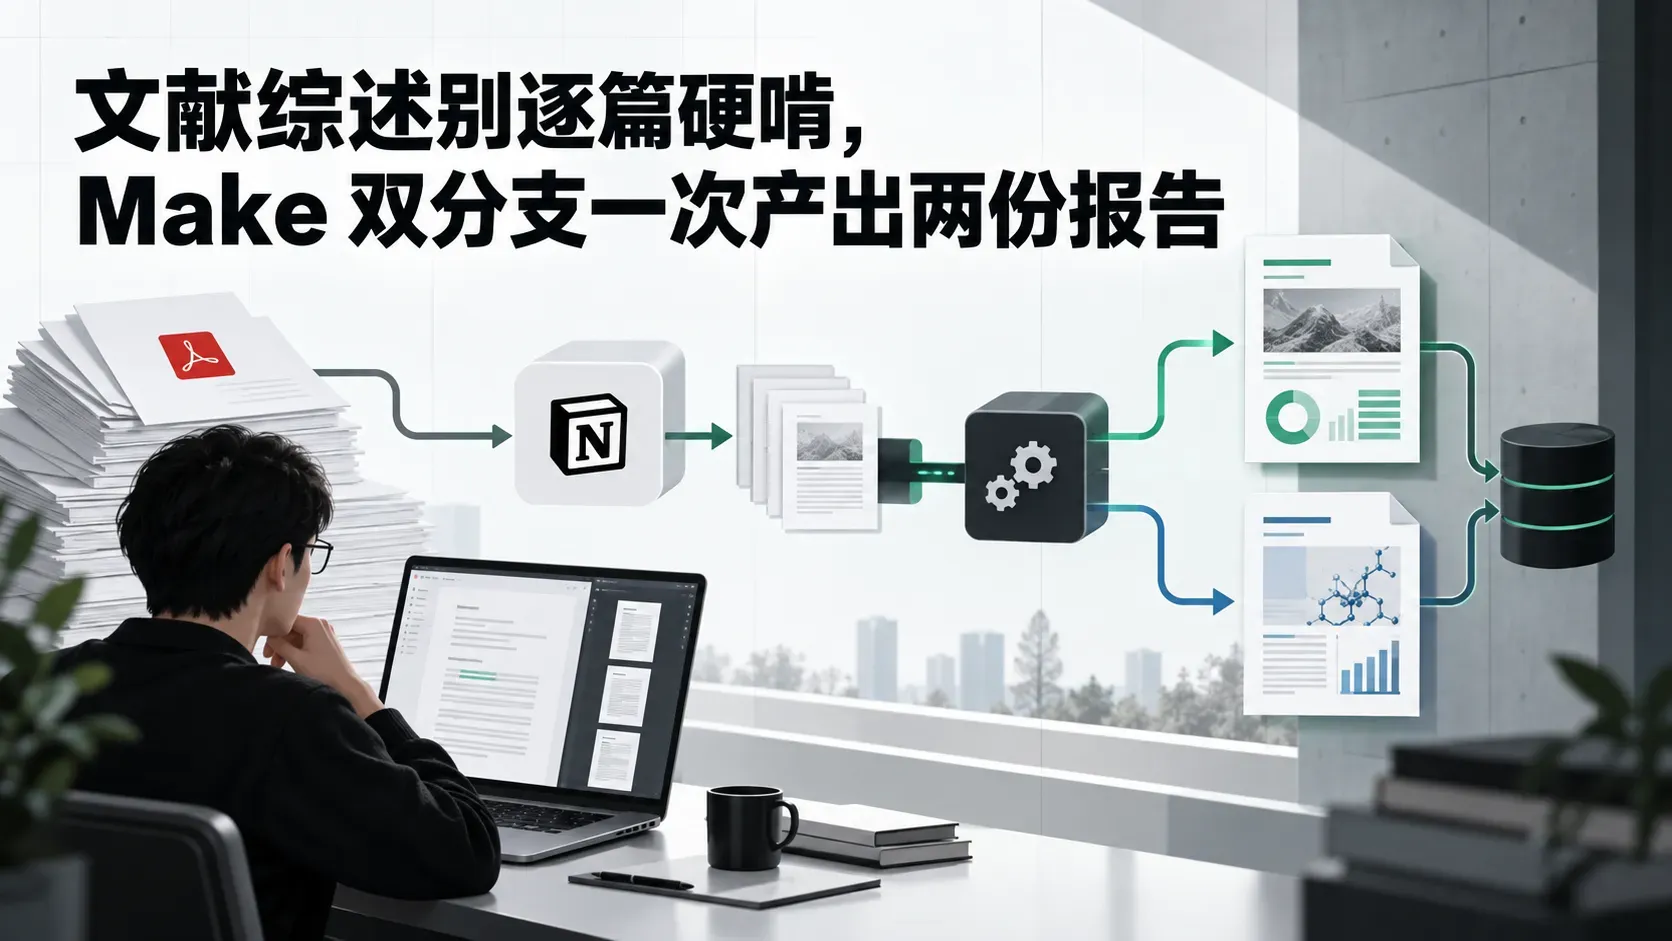
我之前做深度研究项目时撞的就是这堵墙,一次要处理上百篇文献,手动总结根本来不及,这套流水线就是那次被逼出来的。整个流程不复杂,把 PDF 上传到 Notion,工作流自动下载、提取文本、把元数据抽成结构化字段,然后一口气生成两份报告,一份通用文献总结,一份针对你自己课题的文献摘要,全部回填数据库。
这篇写给同样要批量处理文献的人,研究生、博士生、科研工作者都算,也适合任何批量提 PDF 关键信息的场景,金融研报、产品文档一路通。九百多字讲不完细节,我把配置要点和两个亲手踩过的坑全摆出来。
整体架构,一条链分两股
整个工作流分两段。
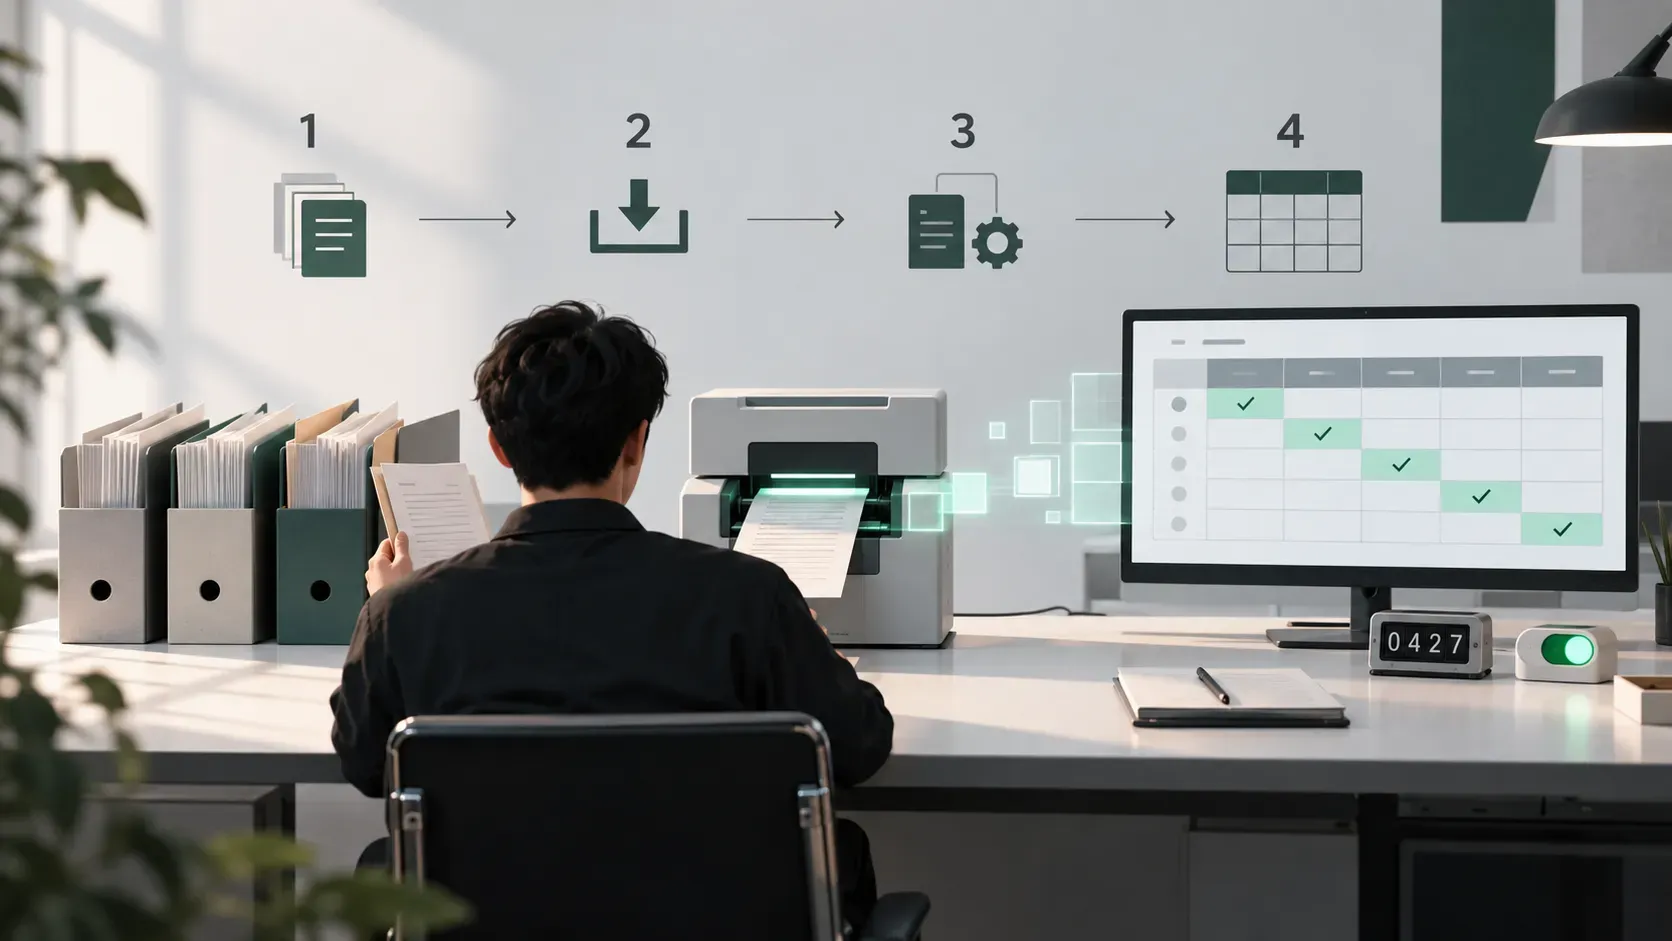
前一段是数据提取,四个模块排成一条线。Notion 搜索模块把待处理的条目捞出来,HTTP 模块把条目里的 PDF 下载下来,PDF.co 把 PDF 转成纯文本,OpenAI 再从文本里抽结构化元数据,标题、作者、摘要、关键词、期刊、DOI,一次抽齐。
后一段是报告生成,一个 Router 分出两条分支按顺序跑。分支一生成通用科研文献总结,分支二生成课题导向的文献摘要,两份都写回同一个 Notion 条目,正文里先总结后摘要。顺序执行有个好处,通用总结先跑完,课题摘要生成时条目已经是个半成品,中间出问题容易定位是哪一截的事。
这个双分支设计的好处,是一次计算产出两个分析视角。通用总结回答这篇论文讲了什么,课题摘要回答这论文对我有什么用,两个问题分开作答,谁也不挤占谁。
自动化省下来的是固定收益,多问一个视角才是额外的赚头。
先把库设计对,分类字段是灵魂
开工前在 Notion 建一个科研论文库,十个属性。标题、作者、摘要、关键词、期刊、DOI、网址、文件(Files 类型,放上传的 PDF)、状态(Select 类型,开始和完成两档),再加一个分类字段。
前面九个字段看名字就会建,唯独分类要单独拎出来讲一节。它不只是标签,是给摘要生成方向掌舵的方向盘。填「大语言模型」,工作流就往大语言模型方向分析这篇文献的启示;填「大模型训练的新方法和理论」,生成的摘要就聚焦得多。
老雷的建议是套一个公式,别填宽泛的大方向,填你课题或项目的具体问题。分类越精确,分支二产出的启示和研究线索越有针对性。这是整条流水线里杠杆最大的一处配置,不花一行代码,把一个字段填准就行。
用法也简单,新建条目,填标题,PDF 传到文件字段,分类填好,状态拨到开始,剩下的事流水线接手。日常往库里丢文献的动作可以零散做,攒着一起跑也行,状态这个开关就是采集和处理的分界线,没拨到开始的条目流水线一律不碰。
逐模块配置要点
第一个 Notion Search Objects 模块配两个筛选条件,分类等于你选定的方向,状态等于开始。有多条研究方向时,改一下筛选值就能切换处理对象。把限制数改大到 10,一次运行就能把一个方向的所有文献批量过一遍。
第二个 HTTP Get a File 模块,URL 映射 Notion 条目文件字段的链接,把 PDF 拉到 Make 服务器上。
第三个 PDF.co 模块选 Convert from PDF,转换类型 PDF to TXT,文件来源接上一步下载的文件。关键参数是 Pages 填 0-3,只提前 3 页。为什么只取 3 页,论文的摘要、引言和方法论概述都集中在前几页,核心信息已经覆盖,而 ChatGPT 的上下文窗口有限,整篇塞进去既费钱又容易分散注意力。PDF.co 按页计费,新用户有免费额度,只提 3 页消耗很少。不想用它也有替代,Kimi 的文件接口或者 PDF 转 Markdown 的方案都能接。
第四个 OpenAI 模块用 Transform Text to Structured Data。它和普通对话模块的差别是不用写复杂提示词去约束输出格式,直接定义数据结构,标题翻成中文,作者保留列表,摘要翻中文,关键词提中文,期刊名保持原文,DOI 和网址照映射,模型用 GPT-4o。
这里有个我亲手踩过的坑,必须划重点。PDF.co 输出的是二进制数据,要先用 toString() 函数转成字符串再喂给 OpenAI 模块,直接接会出错。另外所有字段的 Required 建议都设 No,预印本论文常常没有 DOI 和期刊名,设了必填,缺字段的条目会把整条流水线炸停。
两份报告的提示词差一个变量
Router 的两条分支都用 OpenAI 对话模块,系统提示词分开定义。
分支一,通用总结。系统角色设成科研文献总结助手,硬要求四条,总结字数 3000 字以上,所有内容必须基于发去的文献数据不得编造,以 Markdown 格式输出,只输出总结结果不带开头语和客套话。输出结构五段,文献基本信息、研究背景和目的、研究方法和实验设计、研究结果和关键发现、研究结论和意义。User 消息直接发 toString 转换后的 PDF 文本,Max Tokens 设 4000。跑完先用 Notion Update 把元数据回填、状态改成已完成,再用 Append 把总结追加进条目正文。
分支二,课题摘要。角色换成科研文献摘要撰写助手,输出结构完全不同,基础部分照旧交代背景、方法、发现和结论,往后要连答四组问题。理论启示,现有理论被支持还是被挑战,理论发展有什么新方向。实验方法启示,实验设计和技术改进的空间在哪,方法学上有什么创新。进一步验证方向,给出验证建议和扩展范围。新问题线索,研究发现引出了哪些新问题和未来假设。收尾再给应用建议。
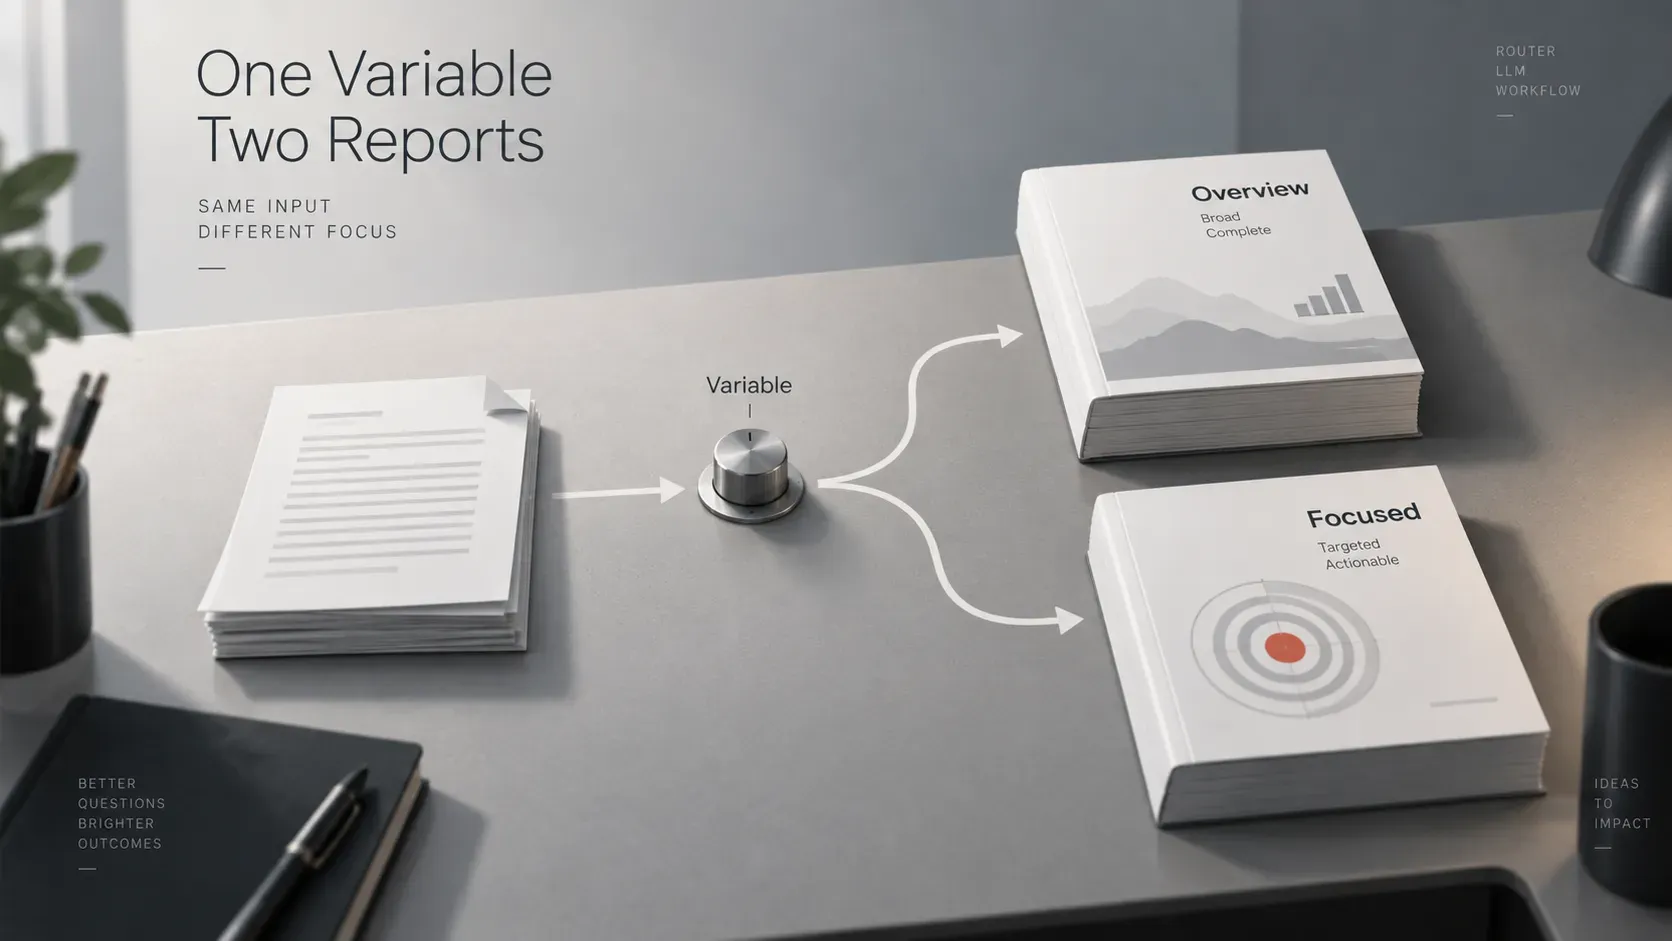
两份报告的本质差异在 User 消息里,分支二额外传入一个研究课题变量,取的正是 Notion 条目的分类字段,课题和文献文本一起发过去。就因为这个变量,同一篇论文,不同课题的人拿到的摘要完全长得不一样。
两条分支的结果都追加进同一个条目,课题摘要排在通用总结后面。跑完回到库里看,元数据字段全部自动填充,正文里两份报告齐活,状态自动翻成已完成,Markdown 编辑器打开条理清楚。
验收、批量与复用
交付验收看三项。抽一个条目,通用总结里不得有编造的痕迹,漏出的数字都能在原文找到出处。课题摘要要真的咬住分类字段里的课题,不是放之四海皆准的套话。状态从开始流转到已完成无卡壳。三项过了再谈放量。
验收里最容易被忽略的是第一项。大模型写总结天生像模像样,编起数据来也像模像样,唯一的解法就是抽检时拿着原文对数字,方法部分的样本量、实验数字、结论里的百分比,对上才算过。这个抽检不能省,也不必多,每一批随手翻一两篇足够兜住质量。
批量跑是这条流水线真正的生产力时刻。把所有待处理文献的状态批量设成开始,检索模块的限制数放大,点一次运行,Make 会遍历每条数据逐一执行完整流程,一个方向的所有文献,一个晚上跑完。中途某条失败也不慌,它的状态还停在开始,补跑时单独捞它出来就行。
再说复用。这套架构其实是个「PDF 进、双报告出」的通用模板。把 PDF 换成金融研报,提示词改成投资分析角度,就是自动研报摘要机。换成产品文档,就能批量提取功能亮点和应用场景。骨架不动,换输入换提示词,就是一个新的交付件。
回头整体看这套东西的价值,它替你读文献是假的,替你把读文献之前的活全包了才是真的。下载、提取、整理、回填全部自动化,两份报告把素材铺到你面前,你只花时间在真正需要动脑的判断上。老雷的建议是头一次跑只放两三篇文献,把两条分支的产出质量验掉,尤其是分类字段对摘要方向的牵引效果,确认无误再放量批跑。综述期省下的时间,拿去思考,别拿去搬砖。