老雷AI实验室
一次采集双平台分发,EXA 加 ChatGPT 的图文产线拆解
同时运营两个内容平台是什么体验。公众号长文写一篇两三个小时,再压缩成小红书笔记又是半小时起步,还没算找配图的工夫。配图还讲究版权,随手百度的图不敢用,图库里一张张挑,一篇八张,又是二十分钟。一天里的大半天,就这么交代在内容生产上。
更磨人的是重复劳动。同一件事,长文写一遍,笔记再换一种口气写一遍,写的人自己都烦。
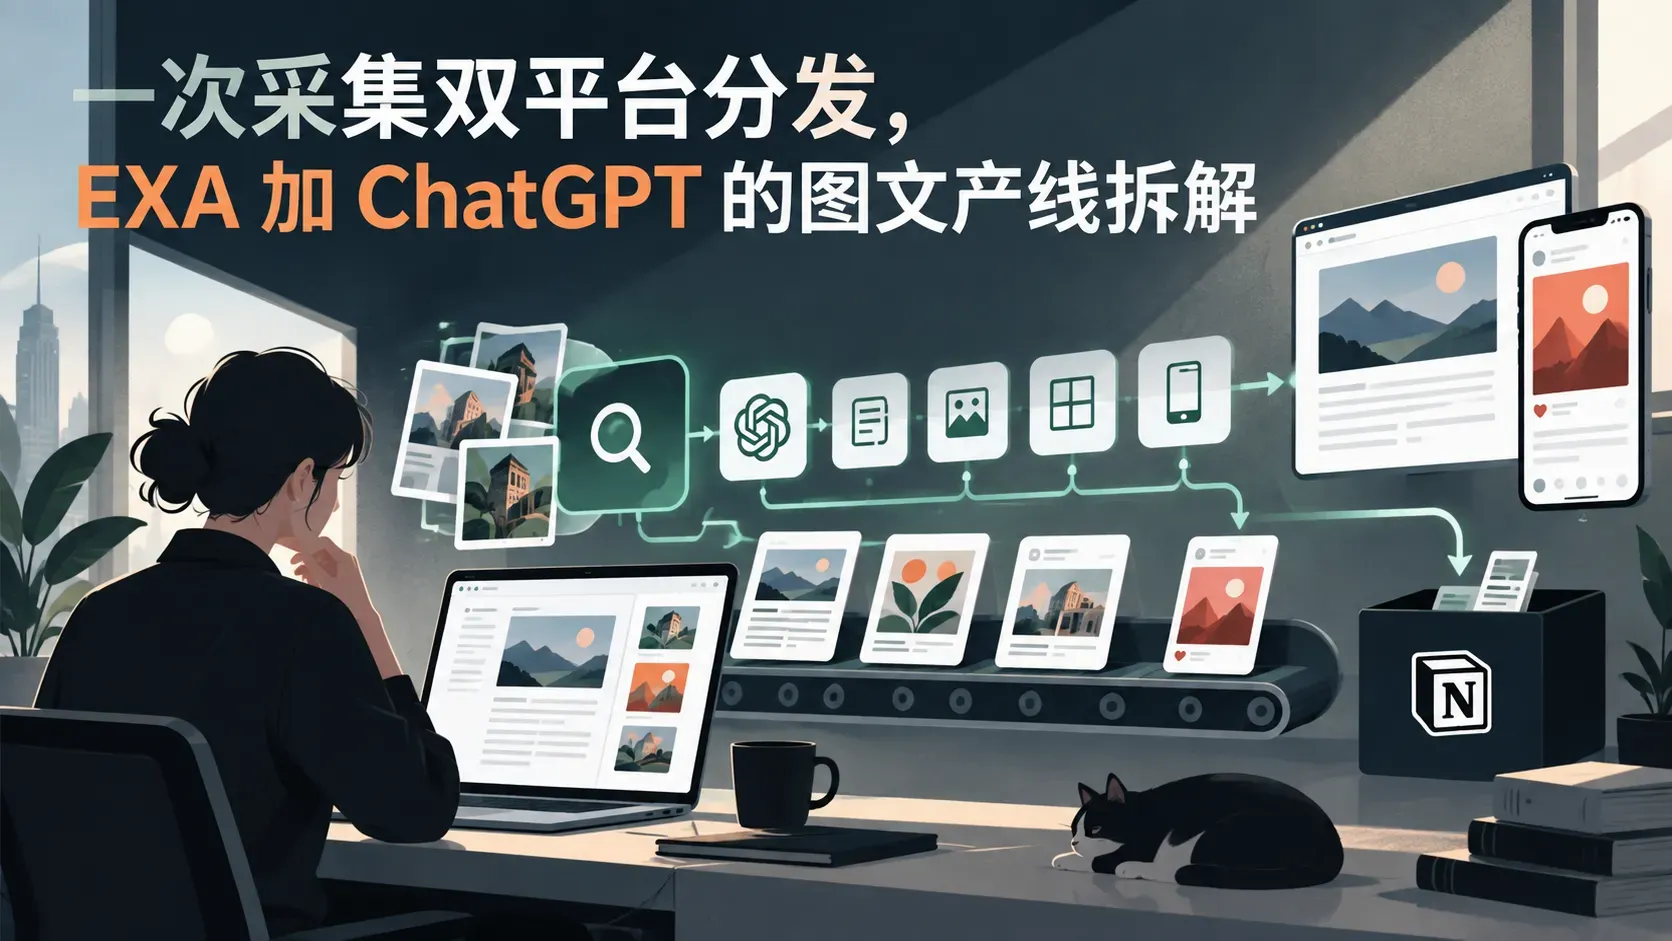
这条产线我搭过一套完整的。RSS 自动捕捉热点标题,EXA 在全网检索素材,ChatGPT 写出两千字以上的文章,配图自动从免费图库抓,最后连小红书笔记一起生成,全部存进 Notion。实测一次运行不到五分钟,出来的是一篇图文并茂的文章加一条笔记,你要做的只剩精修。
素材引擎是整套系统的地基
写得好不好,先看喂进去的东西干不干净。这是老雷给所有内容流水线定的铁律,素材是垃圾,后面写得再流畅也是垃圾。
这次用的素材引擎叫 EXA。它跟 Google 的区别一句话能讲清,Google 是给人用的搜索引擎,EXA 是给 AI 用的。它基于 Transformer 架构做语义搜索,理解意图而不是匹配关键词,还会自动过滤 SEO 垃圾内容,每分钟都在抓互联网的新内容,支持按域名、日期、类别筛选。日期过滤在追热点时特别好使,只留最近一周的内容,写出来的东西不带陈年旧闻的味道。
它的用法也不止写作这一种,做聊天机器人的实时检索、给模型训练攒数据集、盯竞争对手的市场动态,都是它的主场。写作素材获取是其中门槛最低、见效最快的一个,所以我先从这儿用起。
自动洗垃圾这一条对写作太重要了。传统搜索给你的前十条例子,一半是关键词堆出来的营销页,模型吃了这些东西,写出来的稿子一股软文味。EXA 把这层提前洗掉了,你拿到的直接是可以进提示词的干净文本。
注册后到 Dashboard 拿 API Key,调用就是一个 POST 请求打到 api.exa.ai 的 search 接口。query 填主题,numResults 设 10,useAutoprompt 打开让 EXA 自动优化查询词,contents 里的 text 开成 true,正文直接随结果返回。素材质量不理想的时候两个旋钮,numResults 往大调,type 从 keyword 换成 auto 让它自己挑检索策略,冷门主题就换更宽泛的取词。
检索回来别急着喂模型。先加一个 Set Variable 模块,把 10 篇文章的标题、链接、正文按统一格式拼成一份素材文本,素材一、素材二这么排下去,每篇都带上来源链接。拼成一份的好处有两个,一是后面四次模型调用都只读这一份变量,改格式只改一处,二是保留来源,写出来的内容要核实出处时随时能倒回去查。
主题从哪来,留两个入口
第一个入口是 RSS 的 Get Feed Items 模块,订阅一个科技媒体的源,最新文章标题自动变成写作主题,热点到稿件的链路就通了,源换成行业博客、新闻网站都行。我接的是一个 AI 媒体的公开源,标题质量稳定,当天热点当天出稿,蹭热点的时效就是这么来的。素材从哪来决定你能不能抢到第一波热度,RSS 这步看着不起眼,其实是产线的发令枪。
第二个入口留给人工。Notion 建一个文章库,三个属性,标题自带,主题用文本字段存你想写的题目,状态设三个值,开始、已完成,还有一个素材不足。场景里加一个 Notion 的 Search Objects 模块,工作流优先用你填的自定义主题,RSS 的标题做备胎。第三个状态值是给失败留的退路,EXA 都搜不出像样素材的主题,硬写必翻车,标上素材不足跳过,回头人工处理,别让一条坏主题卡死整条产线。
四次模型调用,各干各的活
这条产线最值得抄的设计,是把模型调用拆成了四次,每次只交办一件事。
第一个写文章。提示词的硬要求是只基于提供的素材写、不得杜撰,输出两千字以上的 Markdown,逻辑清晰层次分明,语言简洁少堆术语,直接输出正文、不带开场白和结束语。不得杜撰这条是底线,素材里没有的数字和结论,模型一上头就会自己编,编出来的东西看着还挺像真的。少堆术语则是给传播让路,术语密度一高,普通读者划走只需一秒。User 消息里就两样东西,发送的主题是变量里的主题,发送的内容为那份拼接好的素材文本,边界干净,模型没有自由发挥的空间。
第二个提配图关键词。让它把文章切成 8 个部分,每部分提炼一个英文单词,注意是单词不是词组,JSON 格式吐出来。这个环节产出的不是文案,是给图库检索用的查询串,质量标准完全不同。
第三个做图文混排。把文章和 8 个图片链接一起交给它,图片按 Markdown 语法随文传入,要求按顺序分散插入正文不同位置,不得连续放两张,链接为空的直接跳过,文字和图要对得上。连续放图这个要求不是洁癖,移动端上两张图贴在一起,读者会以为进了图集,正文节奏就断了。这一步走完,产出的是一篇可以直接预览的图文完整稿。
第四个转小红书笔记。输出 JSON,标题、三百到四百字的正文带 emoji、一串话题标签、正文字数,四个字段各归各位。小红书的语感和公众号完全是两个物种,更短、更口语、自带标签体系,这个格式转换交给模型正好,长文压缩成笔记正是它擅长的归纳活。标签那串也别小看,小红书的流量分发吃标签,模型顺手埋好的话题词,比人工凭感觉加的还准。
一个模型包打四份工的写法我也试过,提示词写到后面自相矛盾,输出格式忽好忽坏。拆开之后每段提示词就十几行,稳定得多,真出了问题也知道该修哪一段。
配图关键词要往大了取
配图用的是 Pexels,高质量免版权图库,全部可以免费商用,API 注册就能拿 Key,商用项目的版权顾虑一次解决。Iterator 遍历 8 个关键词,每个关键词调一次检索接口,per_page 设 1,取最匹配的一张,8 张图分散插进文章各段落。两千字的文章配八张图,平均两三百字一图,手机上翻起来刚好是舒服的节奏,图文比就够看了。
这里有个决定成败的细节。关键词取得太具体,图库基本搜不出东西。写 GPU 算力的文章,关键词该是 computing,不是某个具体芯片型号,后者在图库里翻不出一张能用的图。取词的口诀是往前退一步,具体事物退到上位概念,芯片退到算力,直播退到购物,总能找到有图可搜的那一层。宏观概念词才有图可配,这条要写死在提示词里,让模型每部分只给通用词,泛一点不怕,就怕太窄。
交付前过三道检查
第一道,正则扫空图。Pexels 偶尔会返回空结果,文章里就会留下残缺的图片语法,看着像排版事故。保存前加一个 Text Replace 模块,用正则把空链接的图片标签整体滤掉,一行配置的事,漏了就是交付事故。
第二道,原创性边界要想清楚。这套流程不是洗稿,EXA 给的是信息,模型做的是重新组织和表达,成稿是原创的。但基于公开素材,观点和数据难免跟别人重叠,所以它的定位是初稿生产线,发布前必须有人工审核加精修。老雷的提醒是,别把初稿直接往外发,那是在赌运气。你的经验和判断加进去,稿子才从「能用」变成「是你的」。
第三道,定时触发。场景设成每天自动跑一次,配合 RSS 抓热点,库里堆几个主题就清几个,Notion 里的文章库慢慢长成你的内容资产库。你要做的只剩最后一道精修,把值得发的挑出来。
丑话说在前头,这条产线第一次搭,四个提示词都要自己磨,EXA 和 Pexels 的 Key 各申请一轮,模块之间的变量传递也要对几遍,别指望十分钟收工。可它属于那种搭一次吃很久的基建,跑顺之后每天你只投入精修的时间。
自动化把「写」的成本打到地板上,值钱的部分变成判断,判断哪篇值得发、哪里还得改。
一条产线喂饱两个平台,一份素材的功夫办两份内容的事。工具链就摆在这里,五分钟一炉,剩下的精修判断,才是你真正的护城河。老雷的建议是先定一个小的验收标准,比如连跑一周、每天一篇,七篇里挑出三篇肯发的,这条产线就算验收通过,再考虑放量。