老雷AI实验室
找选题写笔记全交给 Make,小红书日更产线从新闻到成品
做小红书的人应该都体会过那种感觉。你守着一个垂直领域,每天新闻素材多到看不完,可真要把素材变成一篇能发的笔记,标题、正文、标签全得自己抠,一篇抠下来一两个小时就没了。喊着要日更,日更个两三天就断。
卡住你的不是没素材,是素材和成品之间那段纯手工的活。这段活把人的执行力一点点磨掉,账号就这么荒了。
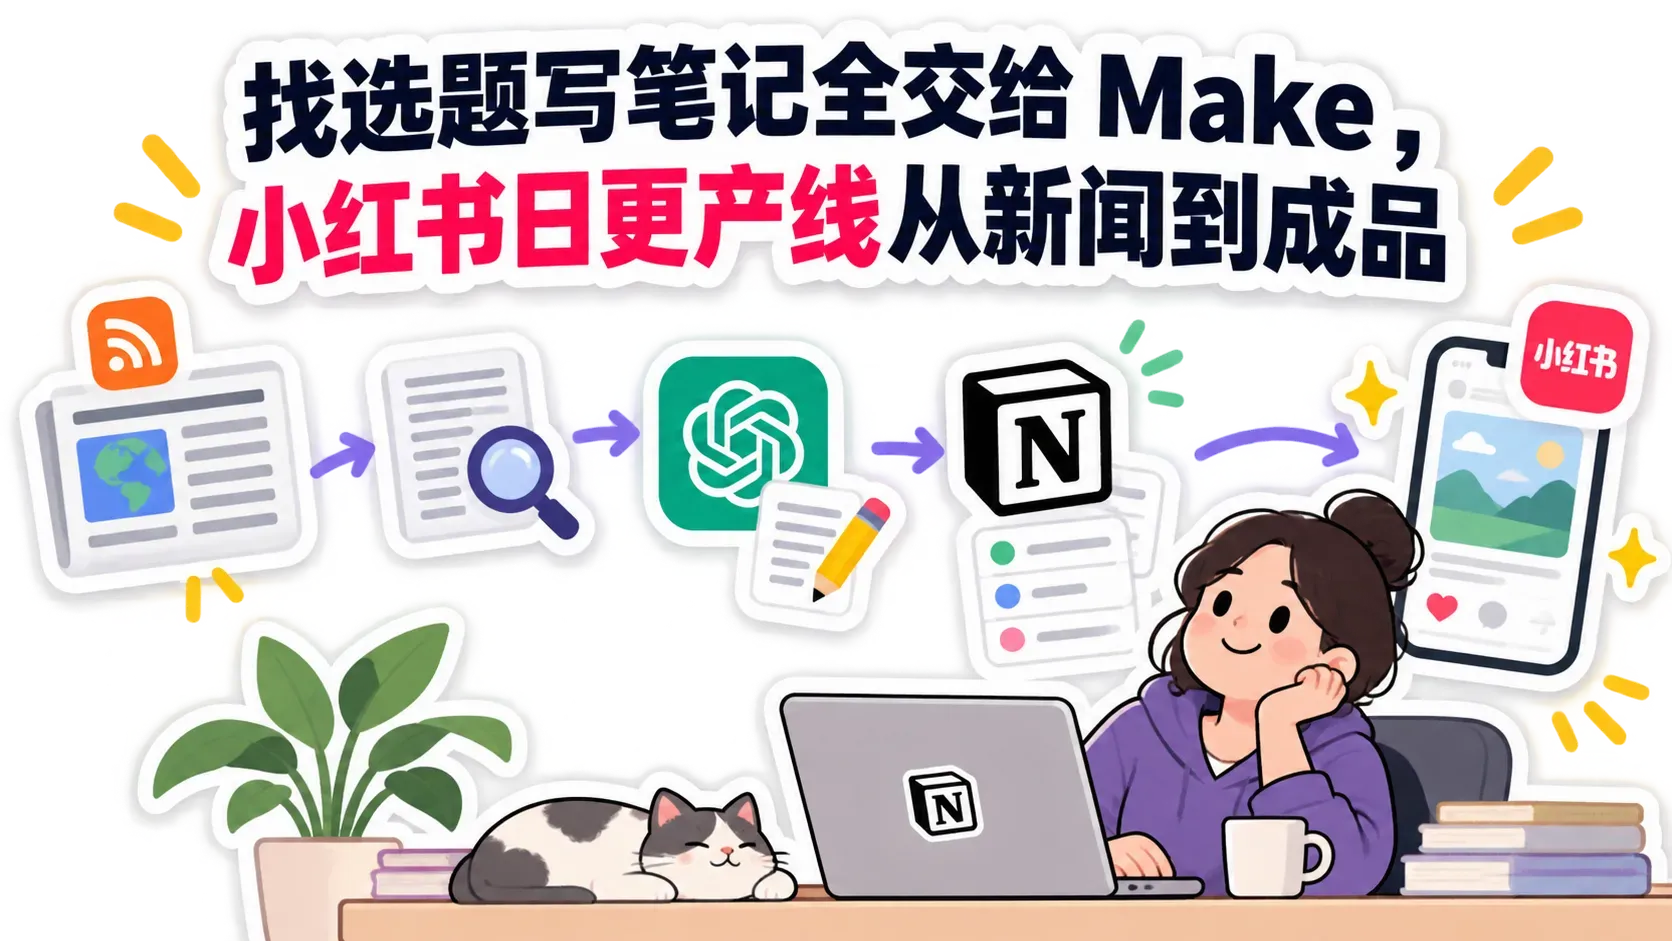
这篇拆一条我跑通过的产线,用 Make 把「新闻进、笔记出」整条链路自动化。Inoreader 负责盯新闻源,Jina Reader 负责把网页扒成干净文本,ChatGPT 按小红书的格式写笔记,成品自动落进 Notion 数据库。你要做的只剩一件事,每天打开 Notion,挑中意的直接发。设置一次,长期有效。
为什么拿新闻资讯类账号开刀?因为它是所有内容类型里最流程化的一种,选题来自新闻更新,素材是现成的文章,格式有固定套路,每个环节都能被模块替代。跑通这一种,你就摸到了自动化内容生产的门道,再往别的品类迁移就是换个提示词的事。
这条线也不挑行业。做金融的抓金融新闻,做产品的盯产品资讯,做科研的订阅 Nature 和 Science,换几个关键词,同一套系统换个领域照跑。
先看全局,四个阶段一根线
整条产线就四个阶段。
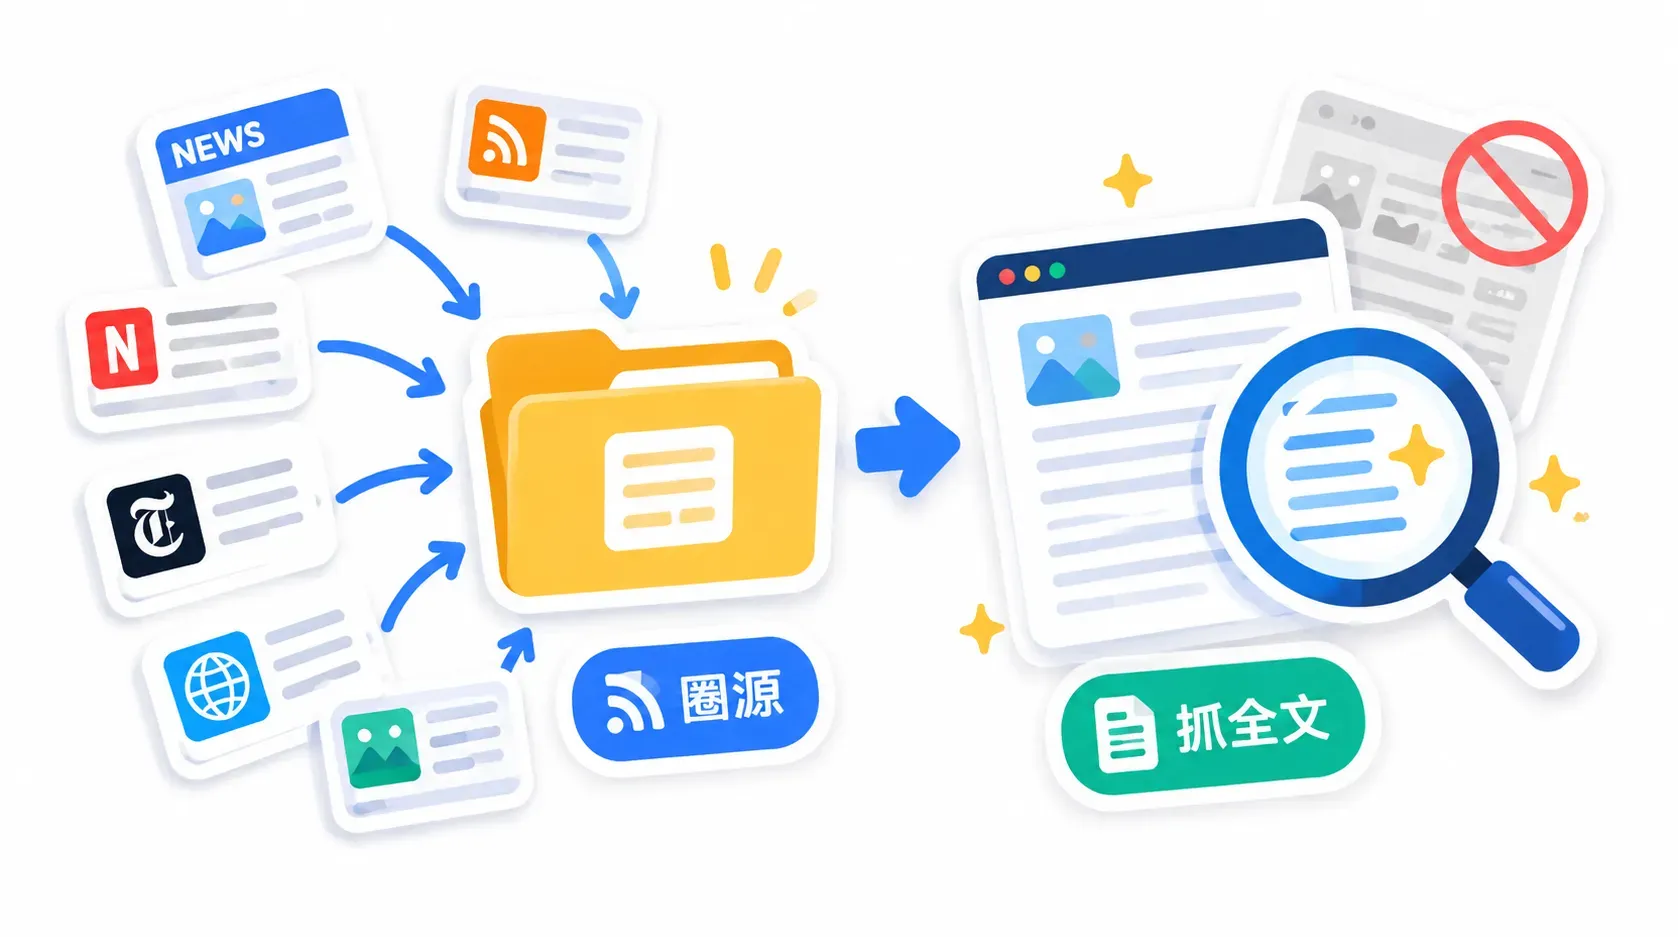
新闻获取,Inoreader 订阅你领域的 RSS 源,把散落在各个媒体的更新聚到一个文件夹。这一步是地基,RSS 的好处是标准、稳定、无人值守,媒体一更新你这边就有数据,不用你满网去追。网页抓取,Jina Reader 把新闻链接转成纯文本,标签和广告全剥掉,只留干净的正文。笔记生成,ChatGPT 按小红书的格式输出结构化内容,标题、正文、标签一次成型。知识库保存,成品自动写进 Notion。
四个阶段在 Make 里串成一条场景,跑起来无人工干预,Notion 里的资讯库每天自己长出新笔记。你要盯的只有收尾那一环,打开库挑稿子。下面按搭建顺序一层层说。
圈源和抓全文,两步打地基
新闻源用 Inoreader 来圈,它是个 RSS 订阅管理工具,干的活是把分散在各个媒体的新闻源汇总到一个地方。操作很轻,注册登录之后,搜索框输入你的领域关键词,比如 Artificial Intelligence,语言中英文都支持,从推荐列表里挑几个质量高的订阅源,统一放进一个文件夹,文件夹直接用领域名命名。这个文件夹就是后面 Make 抓取数据的统一入口,不同领域建不同文件夹,互不干扰,以后要开第二个赛道,复制这套结构就行。成本也给你交个底,免费版足够跑通全流程,规则过滤那些高级功能要收费,但订阅和分组这两个基础动作完全不受影响。
源圈好之后别急着生成,这里有个很多人会踩的坑。Inoreader 返回的内容通常只是摘要,几十到几百个字。拿摘要去生成笔记,模型手里没料,出来的东西干巴巴几句话,像一份压缩过头的缩写,根本撑不起一篇笔记。生成质量的上限,是被喂进去的素材质量决定的。
所以要加一步,用 Jina Reader API 把整篇网页扒下来。它的本事是把任何网页转成干净的纯文本,HTML 标签、广告、导航栏全部剥掉,只留正文。模型拿到的输入是一篇完整文章,写出来的笔记才有细节、有信息量、有可读性。
Make 里加一个 HTTP 模块,请求方式选 POST,地址填 Jina 的 API 地址、后面拼接新闻链接。三个请求头挨个配,Accept 写 application/json,让返回保持 JSON 格式。Authorization 写 Bearer 加你的 API 密钥,注册账号自动就有。X-No-Cache 设 true,每次现抓不读缓存。输出格式选 JSON,把 Parse response 打开。
Jina 这个环节的价值一句话讲完,它把你的信息源范围从「订阅了的媒体」扩展到「整个互联网」,只要有 URL 就能拿到内容。老雷给个提醒,X-No-Cache 这个开关别省,资讯类内容要的就是时效,读了缓存等于拿到旧闻。
提示词决定笔记的生死,两轮消息加一个 JSON
ChatGPT 这一步是整条线的灵魂,加 OpenAI 模块选创建对话,消息要拆成两轮发。
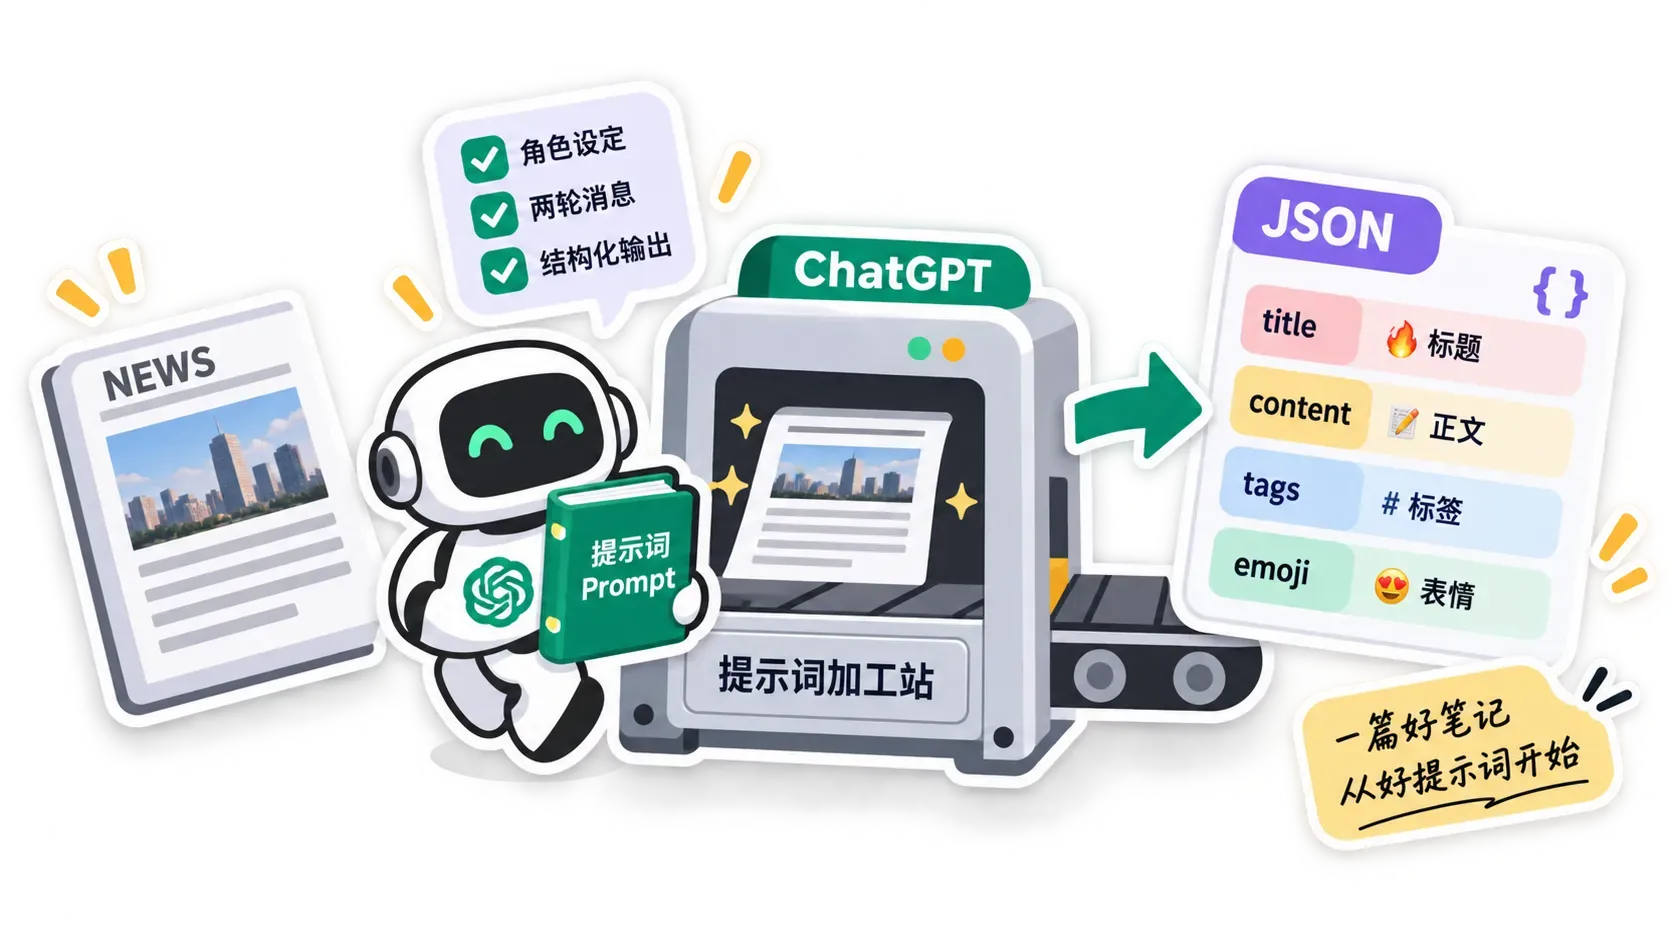
System 消息定角色。告诉它是一个小红书笔记撰写专家,任务是把新闻转写成爆款笔记。关键约束写死,正文 300 到 400 字,用表情符号增强趣味,标题简洁有力,输出 JSON 格式,字段四个,标题、正文、标签、字数。
User 消息传内容,把 HTTP 模块抓到的新闻标题和正文传进去。
为什么拆两轮?目的是避免单次输入过长影响输出质量,角色定义和内容分开走,模型对约束的遵守会稳定得多。高级设置里再把返回格式设成 JSON,输出结构就不容易漂,后面解析环节不会动不动报错。
为什么要较真 JSON 这个格式,因为它是给机器读的。ChatGPT 返回一段结构化的字符串,下一段链路的 Parse JSON 模块才能把它拆成独立字段,标题归标题、正文归正文、标签归标签,Notion 落库的时候各就各位。要是模型自由发挥,这次给你一段散文下次给你一段列表,后面的映射全乱套。结构化输出是自动化链路的通用语言,格式一稳,全链路就稳。
给要交付这条线的工程师一句实在话,System 提示词别一次写到位就不管了,先跑二十条,人工看看笔记的味对不对,表情符号是不是滥用,再回头调约束。提示词是这套系统里唯一需要养的部分。
两道过滤器,一道省钱一道保质量
产线光会跑不行,还得知道什么活不该干。这套流程里加了两层过滤,位置很有讲究。
先交代一下背景,Make 这类自动化平台按操作数计费,链条上每跑一个模块都算一次。垃圾数据如果不拦,后面每一步都在替它烧钱,还污染你的知识库。
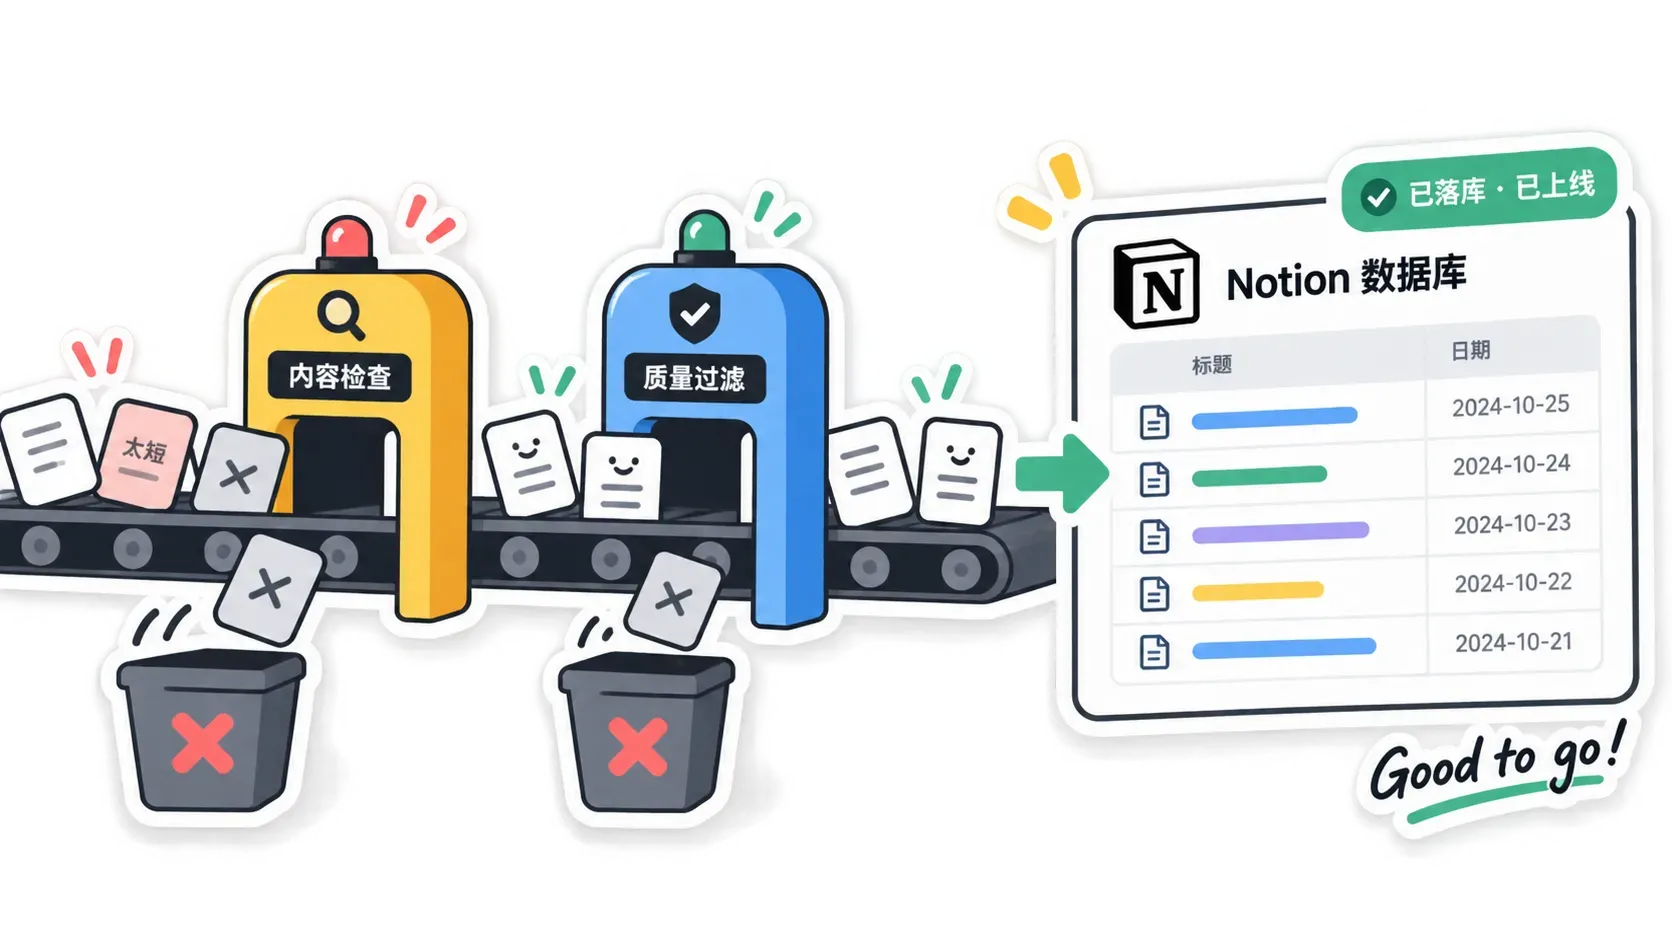
第一道放在 HTTP 和 ChatGPT 之间。抓回来的文本长度小于 3000 字符就跳过,不送生成。为什么定这个数?网页抓取失败、被反爬挡住、内容要登录才能看,这几种情况的共同特征就是文本短得可怜。送过去生成,产出的必然是垃圾笔记,还白烧一次模型调用。
过滤器是自动化产线的成本阀门,不放垃圾进去,也不让垃圾出来。
第二道放在 ChatGPT 和 Notion 之间。生成的笔记字数不在 300 到 500 区间的,跳过不入库。这道保证进知识库的每条笔记都符合小红书的发布体量,你后面挑选的时候不用再做二次筛选。
两道加起来,操作数花在真素材上,知识库里全是合格品,这就是过滤的价值。过滤条件在 Make 里用条件模块实现,不写一行代码。
落库和上线,一份清单收尾
模型输出之后还有一道工序,加 Parse JSON 模块,把 ChatGPT 返回的 JSON 字符串拆成独立字段,标题、正文、标签、字数各自独立,后面映射才能直接取用。
Notion 提前建好数据库,四个字段。标题用 Title 类型,新闻链接用 URL,笔记内容用 Text,发布时间用 Date。
Make 里加 Notion 模块,选创建数据库条目,字段映射对着接。标题来自 JSON 解析,链接来自 HTTP 模块,内容把正文和标签拼接起来存,时间取 Inoreader 的发布时间。
跑通之后的效果,是一个自动更新、无人工干预的垂直领域资讯库。里面每条记录都是一篇能直接发的笔记,带原文链接可溯源,你想核实随时点得回去。库里笔记攒多了,你还能按发布时间、按领域文件夹翻历史存货,找到热点二次利用。
给要落地这套系统的工程师一份上线路径。一,Inoreader 建文件夹圈源,确认订阅源每天有更新量。二,Make 场景的模块按顺序接,每个模块单独测试运行,确认输出再连下一个。三,两道过滤器用条件模块实现,阈值先按 3000 字符和 300 到 500 字跑一周,再按自己领域的正文长度微调。四,Notion 字段类型建库时就定死,中途改类型映射会断。
几个高频疑问顺手答了。有的网页抓不到内容怎么办,那正是第一道过滤器存在的意义,自动跳过不影响整体流程。能不能生成别的平台格式,改 System 提示词就行,把小红书笔记换成别的平台文体,调整字数和格式要求,链路其他部分一个字不用动。
回到那个最累的环节。选题、阅读、写作、排版这套流程里,机器能接管的是从新闻到成品的全部体力活,留给人的只剩一件事,挑选和把关。每天固定十分钟,滑一遍 Notion 库,把最好的几篇搬去发布,十分钟就能维持一个账号的日更。老雷的建议是,把刷素材省下来的时间花在判断哪篇值得发上,这才是人该站的位置。产线替你干活,你替产线做主。