 老雷AI实验室
从零造出能跑的 Skill,执行者分工和上下文预算的施工图
给准备动手写 Claude Code Skill 的工程师,按四种执行者分工、SKILL.md 写法、步骤接口合同、上下文预算和断点恢复五步施工,附脚本纪律与五层验证清单,少走翻车路。
22 块钱跑通一个真活,DeepSeek V4 接进 Claude Code 实测
给要把 DeepSeek V4 接进 Claude Code 的工程师,附五步接入清单和参数模板,用 22 块 API 成本的完整工作流实测它的真实成色和五个坑。
CLAUDE.md怎么写,给失忆的新员工一本入职手册
CLAUDE.md 是 AI 的入职手册,治的是每次都要重复解释的病。该写什么不该写什么、好坏写法逐组对照,附最小版和进阶版两份可抄模板。
一条30字的指令,AI写出一篇6000字长文,秘密全在知识库
一条 30 字的指令,AI 稳定产出一篇 6000 字长文,秘密不在提示词,在知识库工程。分层身份、三路检索、四色记忆、五道入库闸门,FDE 版完整拆解。
企业社媒账号自己转起来,五个 Skill 给 AI 排一班
先算一笔人力账。一个企业社媒账号要保持活跃,每天至少两三条内容,选题、写稿、配图、挑时段发布,一个专职运营一天大半天耗在这上面,一个月上万块的工资,买来的其实大半是重复劳动的工时。 多数老板的 AI 化尝试停在这一步,让员工用 AI 对话写稿,效率提升一些,但每次都要人盯着、催着、复制粘贴着,AI 依然是个要人哄的实习生。真正的跃迁是把 AI 从对话工具变成流水线工人,让它自己排班、自己干活、自己质检。老雷最近把一套跑通的方案拆开看,用五个
四千条对话,一行代码没写,我用 Claude Code 从零攒出一个软件
事情是这样的。三个月前我开始做一个实验,把 Claude Code 当成唯一的编程工具,从零做一套 AI 视频自动剪辑的 Web 应用,代号创剪。上传一段原始视频,选一个剪辑风格,设好配音参数,它自己完成视频分析、旁白撰写、配音合成、音画对齐,吐出一条能直接发布的短视频,全程只需要一个 Gemini API Key。 三个月下来,四千多条对话,二十多万字的沟通记录,我一行代码都没有手写过,这个应用每天在真实环境里跑。 我不是程序员,
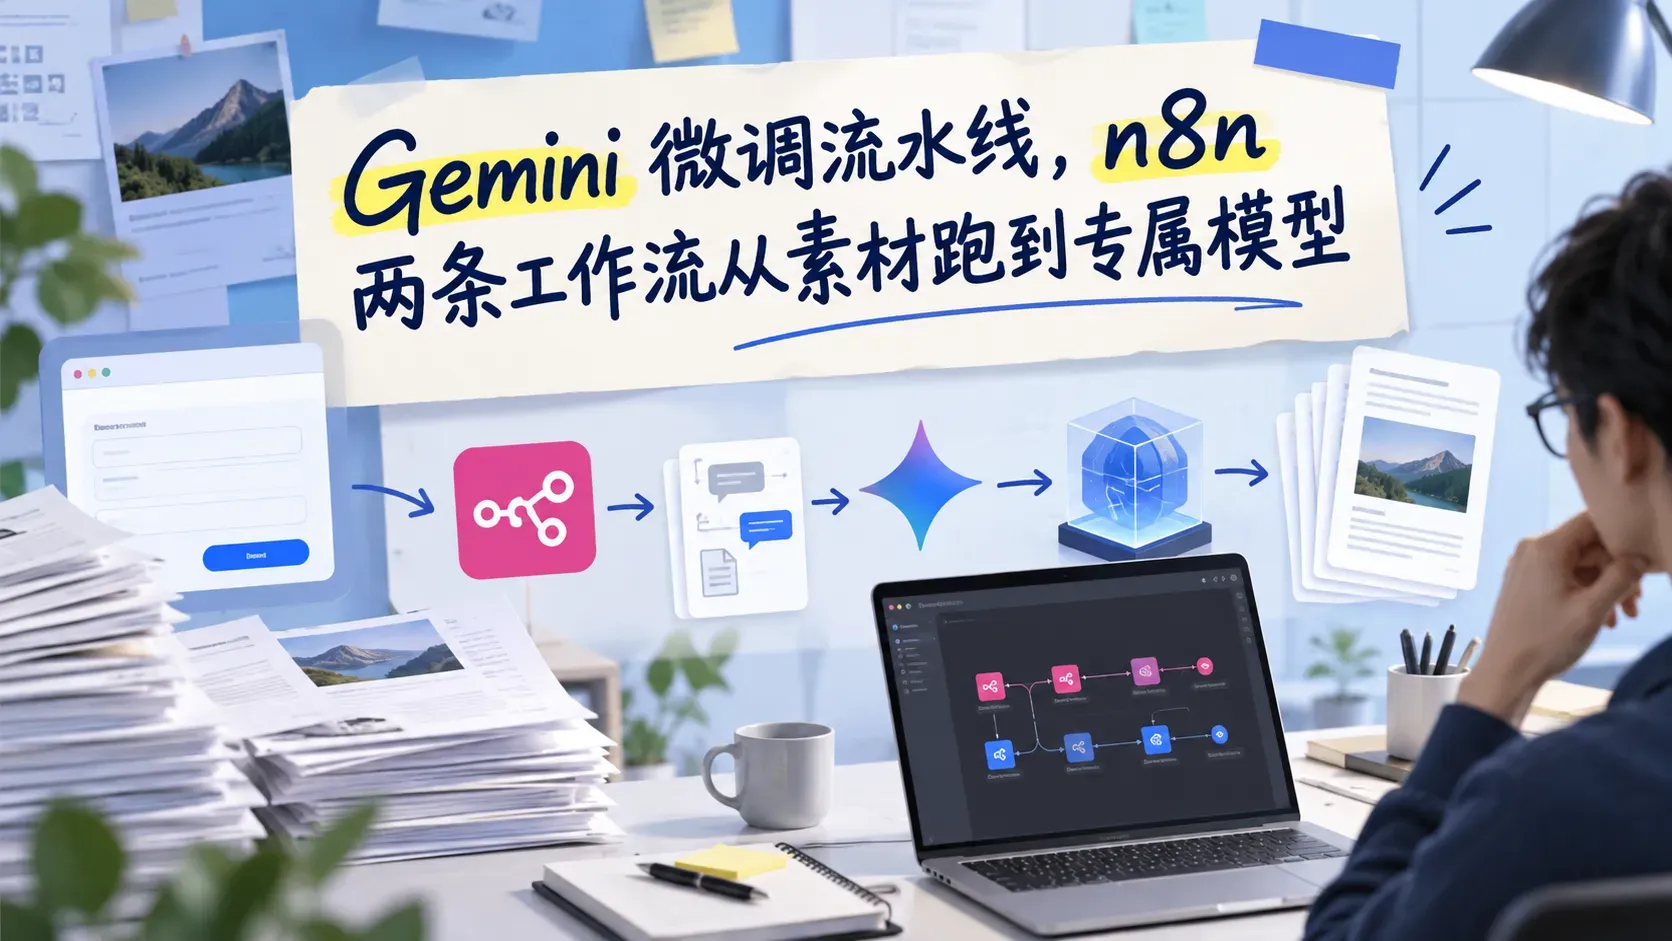
Gemini 微调流水线,n8n 两条工作流从素材跑到专属模型
我以前做风格注入,路子很直,把自己的经历、观点、写作特征全部塞进提示词里。效果有,但两个瓶颈越用越明显。提示词越写越长,上下文窗口被挤得越来越满,而且每次调用都得把这几千字的人设描述重新传一遍,token 白白烧钱。 更别扭的是长文场景。人设提示词和内容提示词在同一个上下文里抢注意力,两边互相牵制,谁也发挥不好。 直到把微调整条流程搬进 n8n 才发现,这件事完全可以一劳永逸,而且自动化搭好之后,新手照着流程也能跑通。这篇把整条流水线拆开讲,从一篇素材进表单,到专属模型出成文,中间不需要人守着。 为什么值得动微调 理解微调有个特别省事的类比。通用大模型就是一个万能函数 f(
微调落地清单,先过选型关再走六步交付
先把两个数字拍在桌上。 一张 RTX 4090,一万块钱上下,配 QLoRA 方法就能微调一个七十亿参数的开源模型,显存占用六到八个 G。LoRA 方法在云 GPU 上微调 Llama 3 的八十亿参数模型,一千条训练样本,行情价五到十五美元。 微调的硬件和价格门槛,两年时间塌了大半。2024 年干这件事还得租多张 A100,起步就是上千美元,如今一张消费级显卡就能进场。 但我这两年跟着企业做 AI 落地项目,看到的真实卡点根本不在钱上。
把Gemini微调做成交付件,五步走加一份验收清单
微调项目最容易翻车的地方,不在训练那一步,在动手之前。不少团队花两三周标注数据,模型也训出来了,效果不达预期,回头一查才发现,一个精心调过的提示词就能拿到九成的效果,微调能补的那点增量,撑不起整个项目的投入。 老雷把 Google Cloud 官方的 Gemini 微调最佳实践过了一遍,再叠上交付里攒下的教训,整理成一套五步走加一份验收清单,给真正要下场动手的工程师。整篇的立场先放在这,微调是个迭代活,别指望一次到位。 动手前先过四道闸 第一道闸,目标要量化。「让模型更聪明」不是目标,「客服回复准确率从七成提到九成」「营销文案风格匹配度从三分提到四分」才是。