 老雷AI实验室
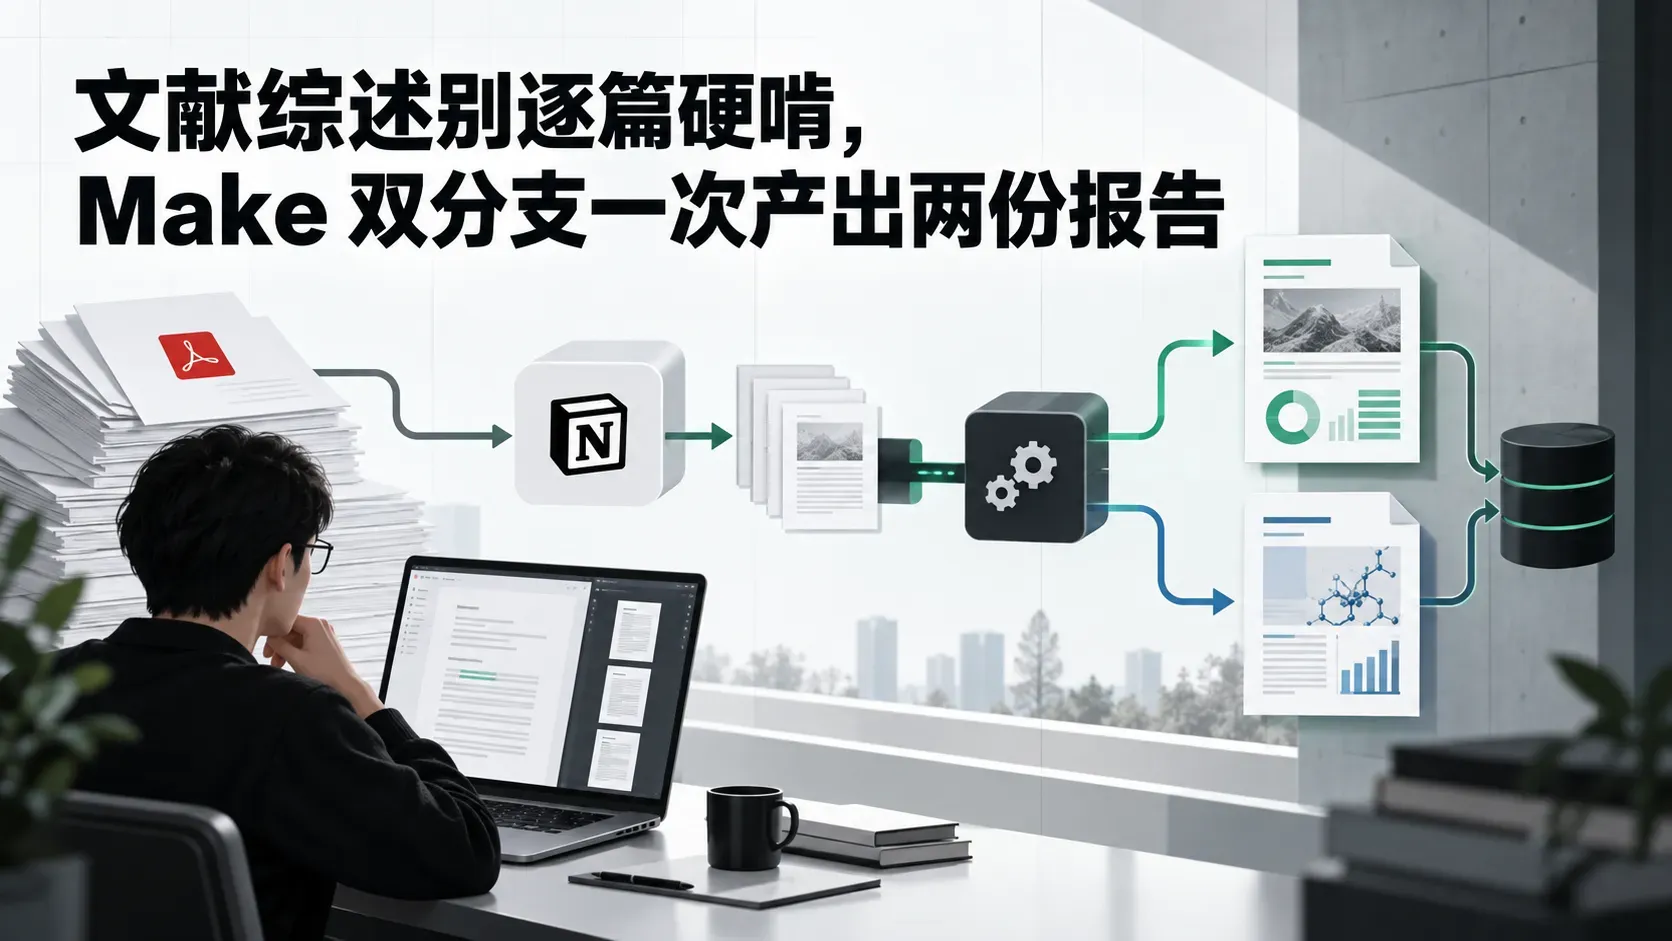
文献综述别逐篇硬啃,Make 双分支一次产出两份报告
文献综述期的日常是这样一幅图景,检索一批论文,逐个下载 PDF,打开第一篇,抄下标题和作者,读完摘要再硬着头皮写总结,还要想这篇对自己的课题有什么启示。一篇下来一个小时没了。二十篇还能咬牙扛,到综述阶段要梳理几十上百篇的时候,纯手工就是不可行的方案。 我之前做深度研究项目时撞的就是这堵墙,一次要处理上百篇文献,手动总结根本来不及,这套流水线就是那次被逼出来的。整个流程不复杂,把 PDF 上传到 Notion,工作流自动下载、提取文本、把元数据抽成结构化字段,然后一口气生成两份报告,一份通用文献总结,一份针对你自己课题的文献摘要,全部回填数据库。 这篇写给同样要批量处理文献的人,研究生、
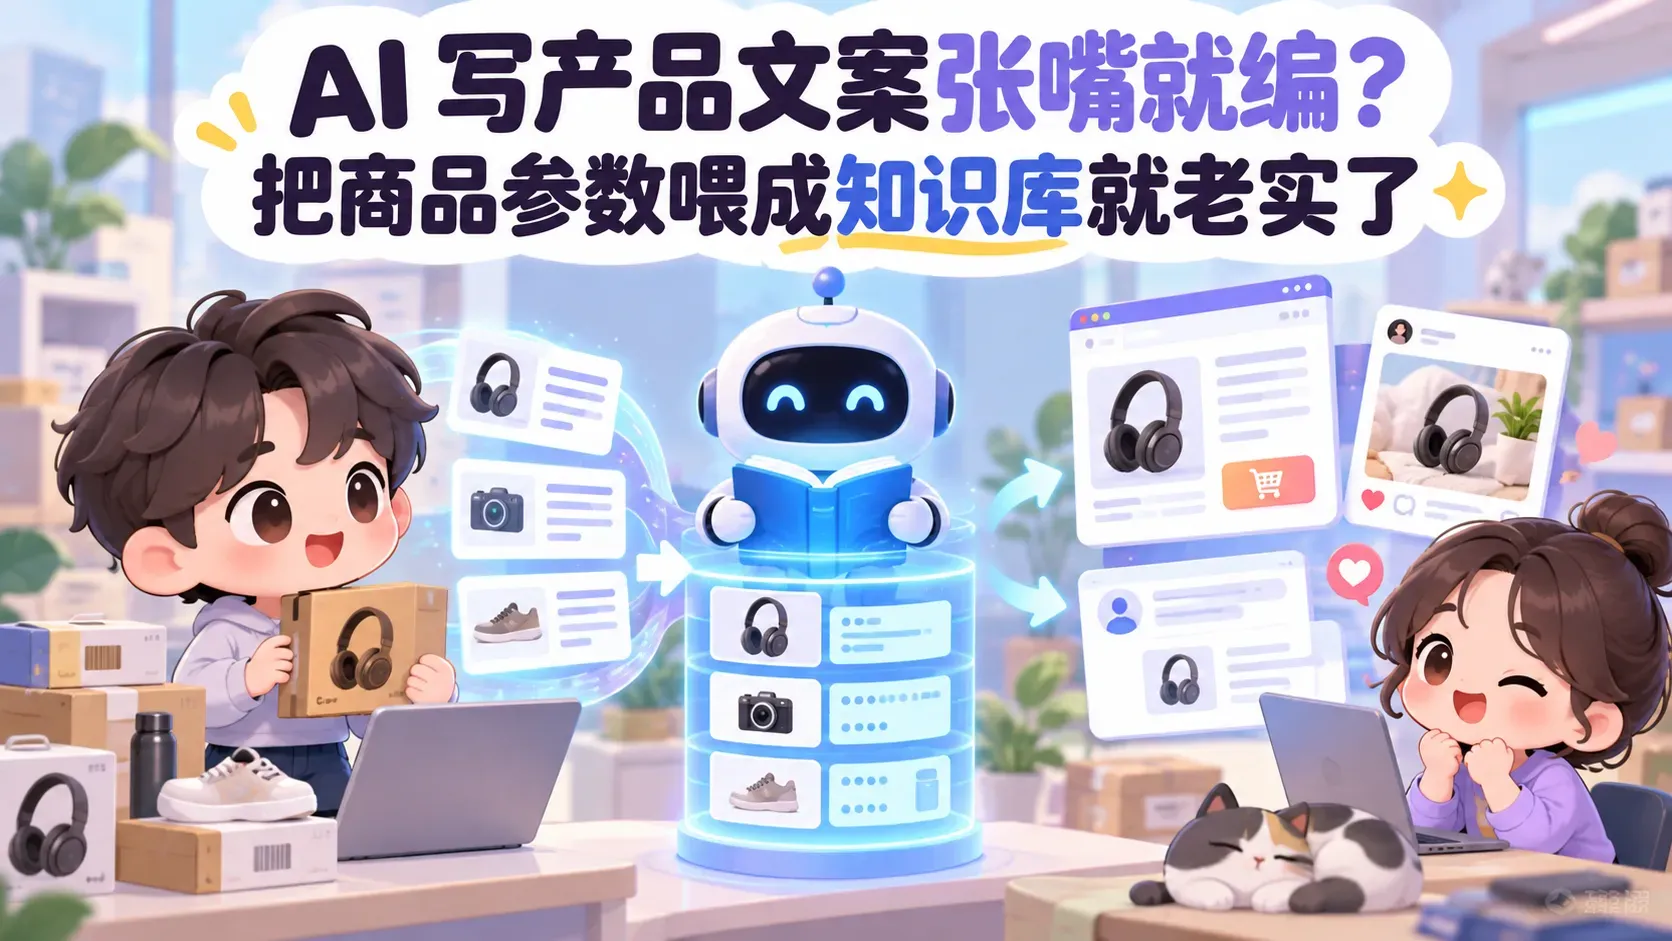
AI 写产品文案张嘴就编?把商品参数喂成知识库就老实了
事情是这样的。朋友的公司做跨境电商,上个月约我吃饭,聊的不是生意,是文案。 他们每上一个新品,亚马逊 Listing 五点描述、产品详情页、种草文、买家问答,一个 SKU 至少四五篇内容。几十个 SKU 排着队,运营组天天加班还是写不完。外包写回来的稿子参数全是编的,改稿的时间比自己写还长。 比量更麻烦的,是真话的约束。产品文案必须踩着真实参数写,续航 20 小时就是 20 小时,Type-
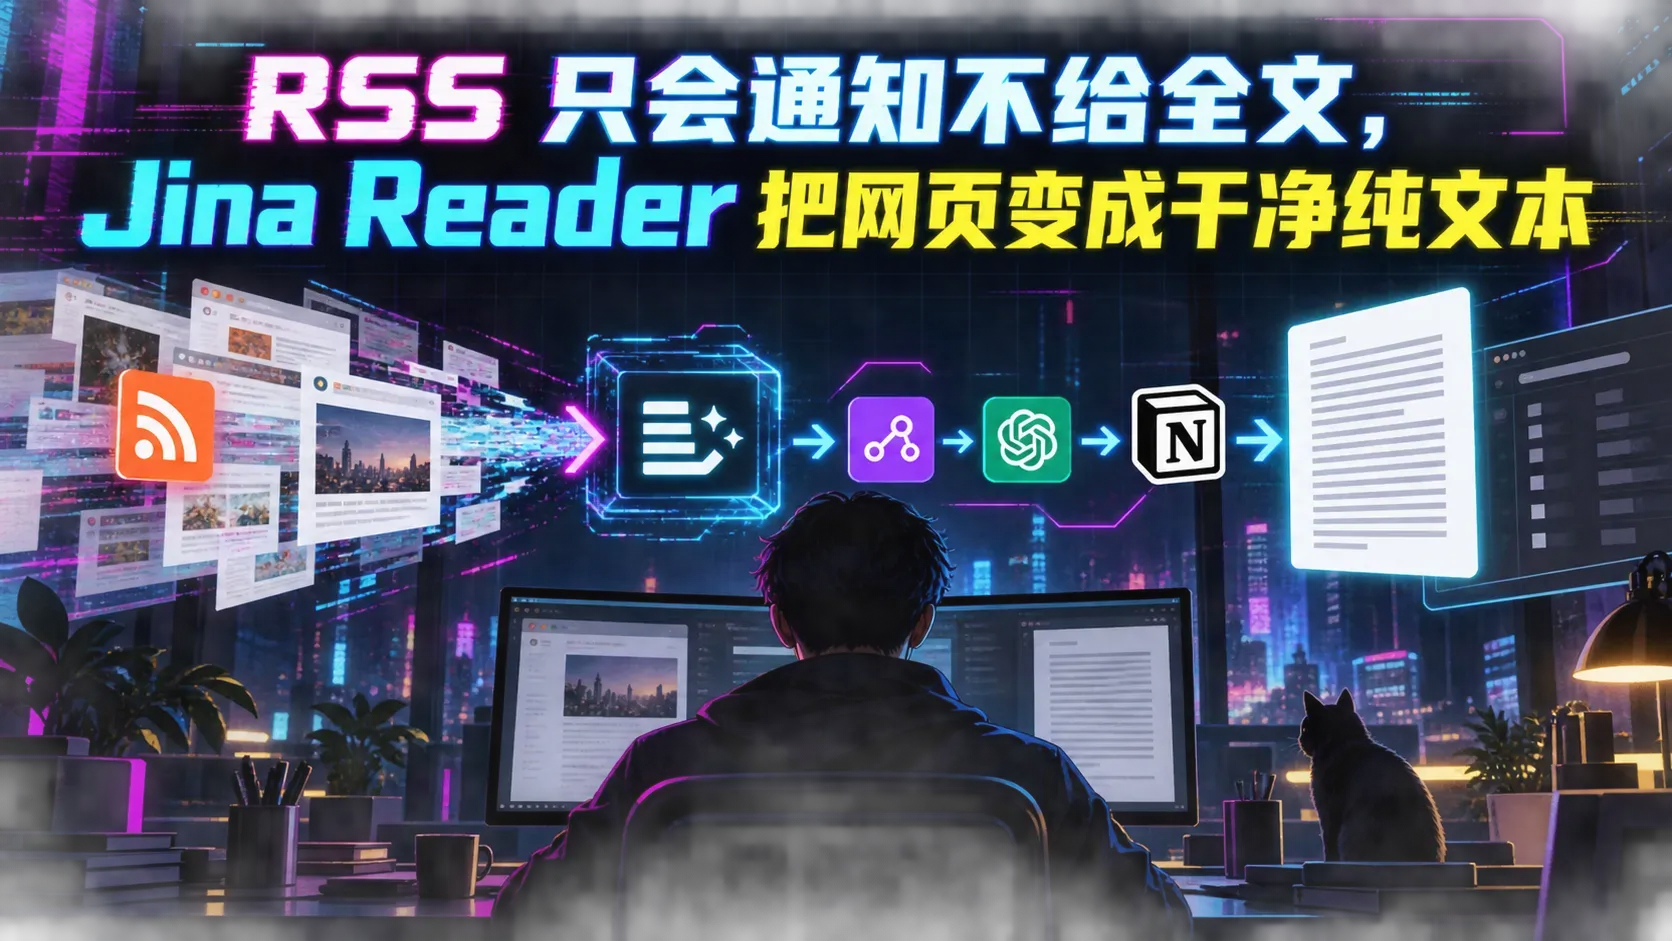
RSS 只会通知不给全文,Jina Reader 把网页变成干净纯文本
用 RSS 追信息的人都会撞上同一堵墙。订阅源很勤快,网站一发新文章它就通知你,可点开一看,只有标题和一段摘要,正文没有。想把内容完整收进知识库,还是得自己开浏览器、进网站、复制全文,一套动作回到手工时代。 一两条还好,要是盯的是一个高频更新的信源,比如一家 AI 公司的官网新闻页,一天几条,天天手动搬,用不了两周人就崩了。追踪特定网站更新的研究者、做资讯简报的运营、靠信息差吃饭的内容团队,多多少少都受过这个罪。 这篇讲怎么把这堵墙拆了。用 Make 加一个 Jina
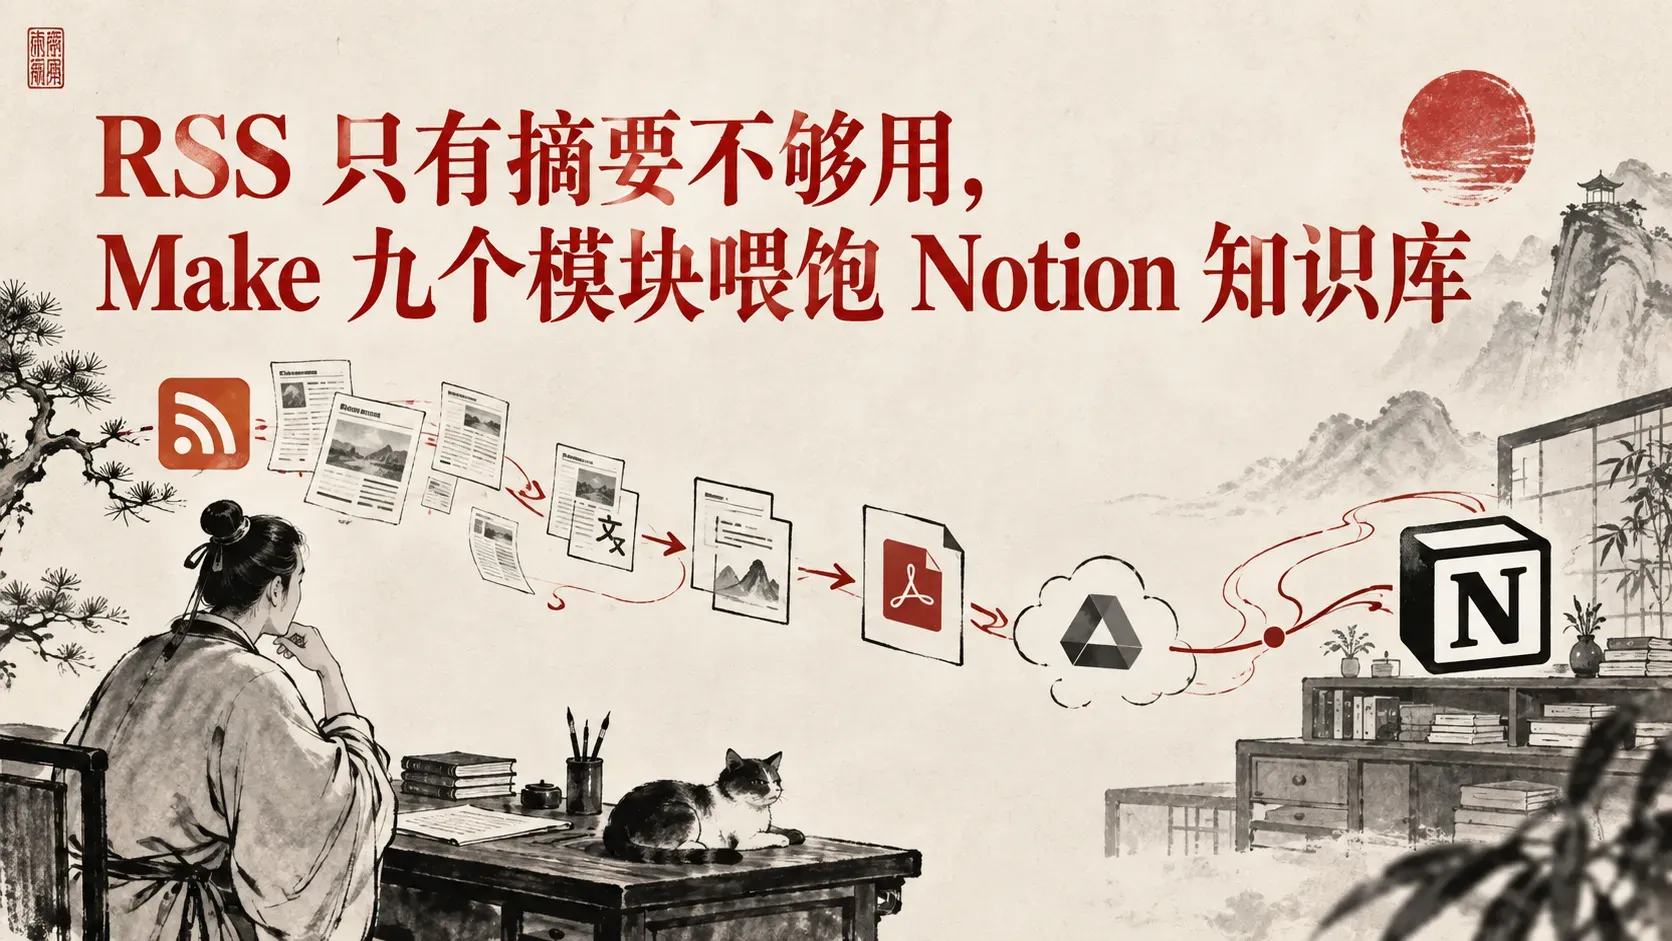
RSS 只有摘要不够用,Make 九个模块喂饱 Notion 知识库
每天要刷几十个网站追资讯的人,大概率都干过这种事,看到一篇有价值的文章,手动复制正文,粘进 Notion,标题是英文的还得再开个翻译窗口,一篇搬完十几分钟就没了。第二天,再来一遍。 这活有省力的干法。用 Make 搭一条流水线,九个模块串起来,RSS 订阅源一有更新就自动抓内容,标题翻译好,正文转成 Markdown 写进 Notion,同时把原文网页转成一份 A4 的 PDF 存进 Google Drive。全程零代码,
一百五十五个字符卖一篇文,元描述批量翻新流水线
先看一组我们后台的真实数字。Google Search Console 里,一篇 Make 自动化教程月展示量五千出头,点击率只有百分之一点五,远低于全站百分之三的平均线。文章内容本身没毛病,坏在门面上。把它的元描述重写一遍,就改了那一行字,两周后点击率爬到百分之三点八,翻了一倍多。正文一个字没动。 这就是元描述的杠杆属性。它是「用一句话卖掉整篇文章」的高难度活,多数人肯花三小时写正文,155 个字符的门面却随手一填。我们运营网站实测下来,做过优化的页面,点击率比没做的高出两到三成,文章累积过百之后,这点差距会滚成可观的流量复利。老雷把它称为内容运营里投入产出比最高的动作,