 老雷AI实验室
Claude Code 装哪个?三个入口是同一台引擎,按工作姿势挑
给团队推广 AI 编程工具,第一个撞上的问题往往不是怎么用,而是装哪个。打开官网就懵了,终端能跑,有桌面应用,VS Code 里能装插件,网页和手机上还能用。于是常见的场面是,有人一口气装齐了三个,有人对着官网纠结一星期迟迟没动手,还有人在群里认真争论哪个入口更「高级」,仿佛装错了入口就会输在起跑线上。这些精力,其实一个都能省下来。 先把结论放前面,这三个入口底下是同一台引擎,配置全部通用,装一个最合你工作姿势的就够了。老雷把三个入口各自的脾气讲清楚,给三类专业人员对号入座,顺便拆掉几个最常见的误区。 三个入口,共用同一台引擎 理解选型的关键事实只有一条,
免费教程能送你到第二关,AI 编程自学的边界线在哪
先说一个场景。后台隔三差五收到同一类问题,CLAUDE.md 怎么组织、Skill 怎么封装,提问的人往往补一句,网上教程搜了一圈,每篇都讲了一点,没一篇讲透。这个困惑很真实,免费教程到底能带你走多远,什么时候才值得掏钱,这篇把边界一条条划出来。 不兜圈子,先给结论。免费资源能把学习路径的前两关覆盖得很好,从第三关开始断档。断档的位置因人而异,但边界本身是清晰的。这篇写给正在自学的工程师,也写给要给团队排培训预算的人,两边用的都是同一张地图。 五个阶段,先看你站在哪 AI 编程的学习路径,拆开是五个阶段,每个阶段要解决的事不一样。
Skill 会自己修 Bug 是什么体验,一套质检闭环把调试压到一小时
事情是这样的。最近两个月我在给客户项目搭 Skill 库,写着写着一个事实浮出水面,写一个 Skill 快的话半天,修一个 Skill 慢起来能拖两三天。 后来我把自己开发 Skill 的时间摊开算了笔账。构思设计占两成,代码编写占两成,剩下的大半,全喂给了调试修复。更气人的是有些 Bug 还不报错,流程规规矩矩走完,输出就是不对,你盯着代码看一万遍也看不出毛病,因为它压根不在代码里。 这篇老雷想把一套自己折腾了一个多月的机制拆开讲清楚,质检闭环。一套让 Skill 自己发现问题、
四千条对话,一行代码没写,我用 Claude Code 从零攒出一个软件
事情是这样的。三个月前我开始做一个实验,把 Claude Code 当成唯一的编程工具,从零做一套 AI 视频自动剪辑的 Web 应用,代号创剪。上传一段原始视频,选一个剪辑风格,设好配音参数,它自己完成视频分析、旁白撰写、配音合成、音画对齐,吐出一条能直接发布的短视频,全程只需要一个 Gemini API Key。 三个月下来,四千多条对话,二十多万字的沟通记录,我一行代码都没有手写过,这个应用每天在真实环境里跑。 我不是程序员,
14 个场景跑下来,把 n8n 的自建账和选型对照算清楚
上一篇拆 Make,后台有读者留言问了一个躲不开的问题,客户说数据一步都不能出内网,那 Make 的方案是不是直接就死了。 问得很准。全托管平台的代价就是把数据交出去,这一条在企业场景里经常是过不了合规那一关的。所以这篇把 n8n 摊开讲,老雷把过去一年用它跑的 14 个实战场景掰开了算账,从视频批量生产到 AI 集成再到副业变现,这篇算的是自建的账,结尾给一张 Make 和 n8n 的选型对照,两篇凑成一对。 如果说 Make 是租来的自动化,n8n
28 个自动化场景跑下来,把 Make 的企业选型边界讲清楚
事情是这样的。最近半年老雷帮几家企业梳理流程,聊到自动化,几乎每次都会撞上同样三个问题,要不要上自动化平台,上哪个,上到什么程度。 趁着给客户做选型的机会,我把 Make 上的 28 个实战场景完整跑了一遍,覆盖内容生产、社交运营、数据采集、知识管理、办公效率这些企业最高频的方向。这篇不讲操作教程,讲选型,讲边界,讲成本账。你要判断的是这东西适不适合你的团队,而不是它有多炫。 工具不是目的,把重复劳动的时间省下来,交给需要人判断的事情。 Make 到底是什么定位 Make,
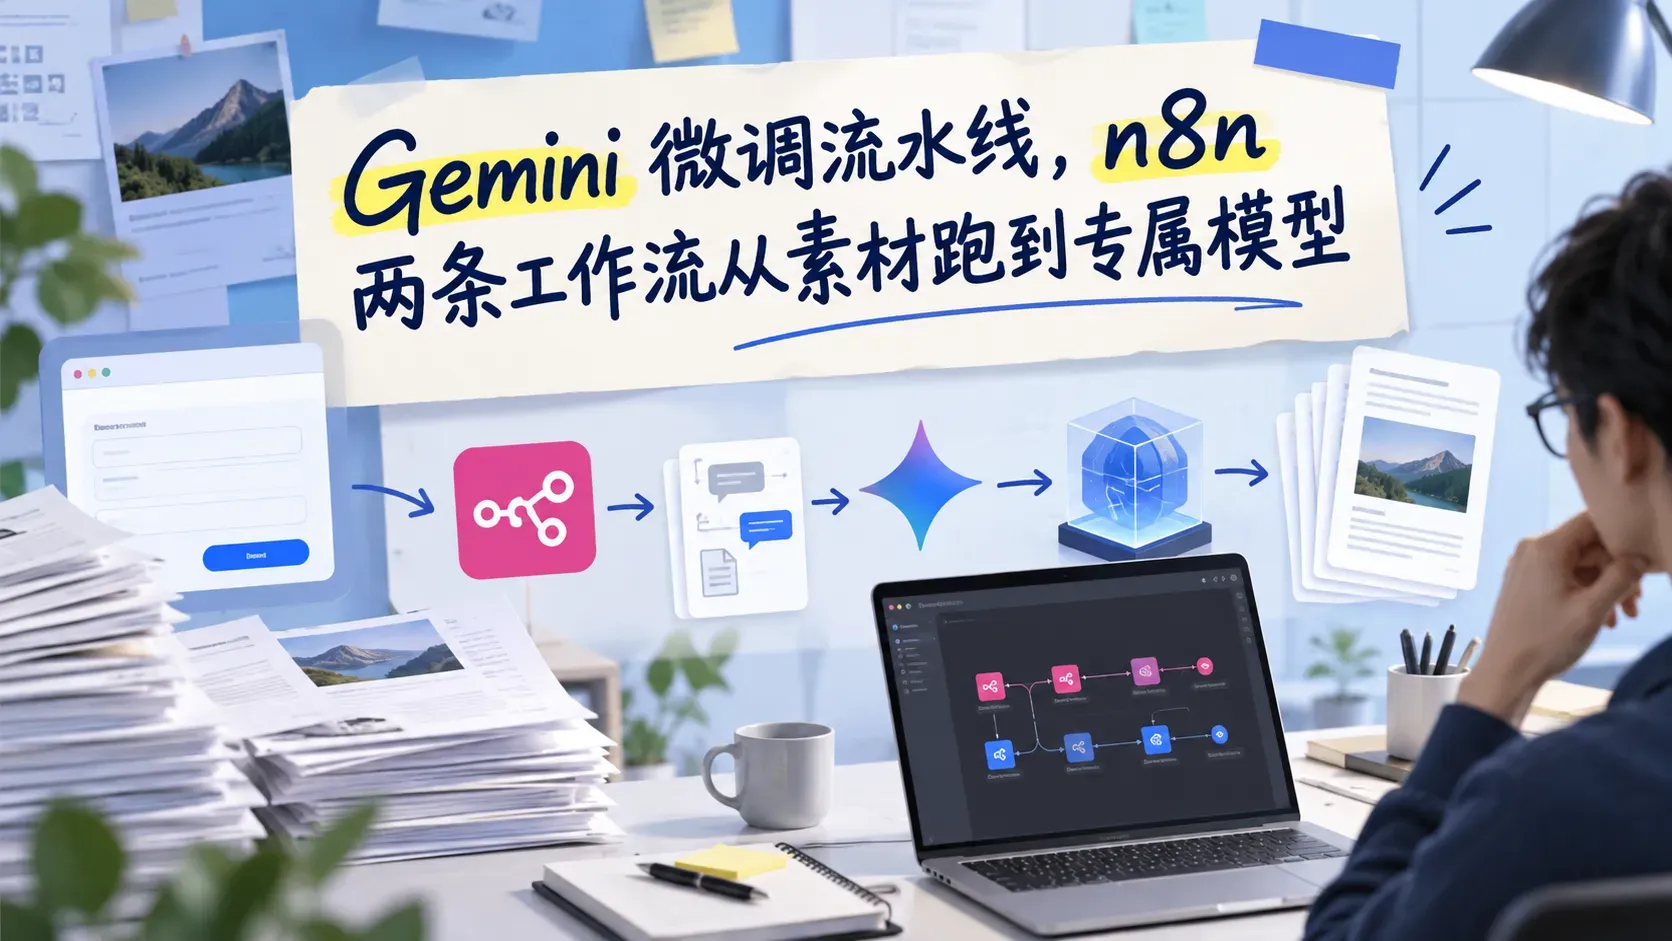
Gemini 微调流水线,n8n 两条工作流从素材跑到专属模型
我以前做风格注入,路子很直,把自己的经历、观点、写作特征全部塞进提示词里。效果有,但两个瓶颈越用越明显。提示词越写越长,上下文窗口被挤得越来越满,而且每次调用都得把这几千字的人设描述重新传一遍,token 白白烧钱。 更别扭的是长文场景。人设提示词和内容提示词在同一个上下文里抢注意力,两边互相牵制,谁也发挥不好。 直到把微调整条流程搬进 n8n 才发现,这件事完全可以一劳永逸,而且自动化搭好之后,新手照着流程也能跑通。这篇把整条流水线拆开讲,从一篇素材进表单,到专属模型出成文,中间不需要人守着。 为什么值得动微调 理解微调有个特别省事的类比。通用大模型就是一个万能函数 f(
微调到底改了什么,一百篇文章喂出来的文风实测
先看同一段「儿童发展心理学」的两种写法。 微调前的模型这么写。第一阶段,0 到 1 岁,信任还是不信任。一个嗷嗷待哺的婴儿,他的整个世界就是妈妈的怀抱,他饿了哭了,妈妈及时送上温暖的乳汁,每一次及时的回应,都在婴儿心里刻下一个信念,这个世界是安全的,我是被爱着的。 知识是对的,表达是标准的,读起来像一页写得还不错的教材。 微调之后,它这么写。第一关,0 到 1 岁,信任的种子。一个嗷嗷待哺的婴儿,
微调落地清单,先过选型关再走六步交付
先把两个数字拍在桌上。 一张 RTX 4090,一万块钱上下,配 QLoRA 方法就能微调一个七十亿参数的开源模型,显存占用六到八个 G。LoRA 方法在云 GPU 上微调 Llama 3 的八十亿参数模型,一千条训练样本,行情价五到十五美元。 微调的硬件和价格门槛,两年时间塌了大半。2024 年干这件事还得租多张 A100,起步就是上千美元,如今一张消费级显卡就能进场。 但我这两年跟着企业做 AI 落地项目,看到的真实卡点根本不在钱上。